GPT-6 SolとGPT-6 Lunaが発表され、「どちらを使うべきか」と考える人が増えています。名前だけを見ると性能差の話に見えますが、職場での選定はベンチマークや単価だけで終わりません。扱う情報の重要度、作業の失敗が誰に影響するか、出力を誰が確認するかまで決めて、初めて実用的な選択になります。
OpenAIの公式モデル案内では、GPT-6 Solは知能とコストのバランスを取るモデル、GPT-6 Lunaはコストを重視する大量処理向けモデルとして位置づけられています。どちらもテキストと画像の入力、テキスト出力、多言語、画像理解に対応すると案内されています。ただし、同じ機能が使えることと、同じ仕事を同じ運用で任せられることは別です。
この記事では、SolとLunaを「高級か低価格か」の二択にせず、仕事を分解して選ぶ方法を紹介します。料金や提供条件は変更され得るため、導入・更新の前には必ず公式のモデル案内と価格表を確認してください。医療、法律、金融、採用、人事評価、契約、行政手続きなど、個人や組織に大きな影響が及ぶ判断は、モデルの出力だけで確定しないことが前提です。
まず押さえたい:SolとLunaは「仕事の置き場」が違う
2026年9月23日時点のOpenAI公式ドキュメントでは、GPT-6 Solは複雑なコーディングやエージェント型ワークフロー向け、GPT-6 Lunaは焦点の定まった大量処理向けと説明されています。いずれも最大出力128Kトークン、コンテキストウィンドウ1.05Mトークンと記載され、推論の設定も用意されています。ここから読み取れるのは、単純に「Lunaは短い仕事だけ」「Solは何でも正確」と決めるのではなく、業務の性質によって期待する役割を変えるべきだという点です。
たとえば、社内規程と過去の案件資料を照合し、複数の手順をまたいで下書きを作る仕事は、途中の判断や例外処理が多くなります。作業がどこで止まったか、次に何を確認するかを扱えることが大切です。一方、同じ形式の問い合わせを分類する、決まった項目を抽出する、短い文章の候補を大量に整形する、といった仕事は、処理件数・待ち時間・単価を含めた全体最適が重要になります。
この違いは、モデル名ではなく「失敗したときに何が起きるか」で見ると分かりやすくなります。誤った要約を人がすぐ読んで直せるなら、小さく試す余地があります。誤った内容が顧客への連絡、支払い、契約更新、アクセス権変更に直結するなら、出力の質に関係なく、実行前の承認と記録を強くする必要があります。
公式情報から読む、価格と能力の「比較しにくさ」
価格表には、標準処理・バッチ・Flex・Fast modeなどの区分があり、短いコンテキストと長いコンテキストでも単価が異なります。記事執筆時点の標準価格の表では、GPT-6 Solは入力100万トークン当たり2ドル、出力100万トークン当たり10ドル、GPT-6 Lunaは入力0.10ドル、出力0.50ドルと示されています。キャッシュ済み入力や長いコンテキスト、利用する処理モードによっても数値は変わります。
ここでありがちな誤解は、入力単価だけで月額を想像することです。実際の費用は、入力と出力の比率、繰り返す指示の長さ、再実行の回数、失敗時の人手、ツール呼び出し、ログ保存などで変わります。長い社内ルールを毎回添える運用なら、プロンプトキャッシュの条件も含めて検討する必要があります。反対に、短い依頼を大量に処理するなら、1件ごとの速度と失敗の再処理率が効いてきます。
また、価格差を「確認を減らせる差」と解釈してはいけません。安価なモデルだから人の確認が必要、高価なモデルなら不要、という線引きは安全でも実務的でもありません。確認の深さは、モデルではなく、出力の用途と影響範囲に合わせます。社内のたたき台と、顧客・取引先・公的機関に出す文章では、同じ文章生成でも必要な検証が異なります。
モデル選定の前に、仕事を4つの軸で棚卸しする
導入を急ぐと、まず「どのモデルを全社標準にするか」を決めたくなります。しかし実務では、仕事の種類を先に並べたほうが、余計なコストと事故を減らしやすくなります。次の4軸を一枚の表にして、案件ごとに記録してみてください。
1. 問題の複雑さ:一度の回答か、途中で判断が分かれるか
複雑さは文章の長さだけで決まりません。条件が増える、資料同士が矛盾する、途中で外部ツールを使う、例外に対応する、といった要素があると確認ポイントが増えます。複数の資料を根拠として提案書の構成を作る、コードの変更箇所を洗い出してテスト計画を組む、問い合わせ内容から必要な部署を決める、といった仕事では、結果だけでなく途中の前提を見られる設計が必要です。
Solは公式に複雑なコーディングとエージェント型ワークフロー向けとされているため、このような候補に入ります。ただし、候補に入ることは自動実行の許可ではありません。入力資料の版、使った指示、出力した案、担当者の承認を残し、想定外の条件に出会ったときに止まれるようにします。
2. 処理量と待ち時間:1件の出来より、全体の流れを見る
日報の分類、商品属性の候補付け、議事録の定型整形、画像の説明文の下書きなど、比較的限定された仕事が何千件もある場合は、Lunaのようなコスト重視・高処理量向けのモデルが検討対象になります。ここで大切なのは、最初から全件を流さないことです。
代表的なデータを小さく抜き出し、正解例を用意します。次に、誤分類、空欄、重複、禁止語の混入、固有名詞の取り違えといった失敗を数えます。1件の品質だけでなく、修正に何分かかったか、再実行で直ったか、例外の割合はどれくらいかを記録すると、処理量を増やしたときの実態に近づきます。大量処理は小さな誤りも大量に広げるため、件数を増やす判断は品質確認の後に置きます。
3. 情報の機微性:入力してよいデータを先に決める
モデルを選ぶ前に、入力データの区分を決めます。公開済み情報、社内一般情報、取扱注意情報、個人情報や営業秘密などに分け、どの区分をどの環境に送れるかを担当部署と確認します。住所、連絡先、健康情報、口座情報、未公表の業績、認証情報、取引条件などは、必要最小限にするか、原則として入力しない設計が安全です。
匿名化も万能ではありません。複数の属性を組み合わせると個人や案件が推測されることがあります。置換した識別子の対応表を同じ作業環境に置かない、少数事例をまとめる、画面キャプチャに不要な情報が写っていないかを見る、といった基本操作を運用に組み込みます。データ保持、地域、権限、管理機能の条件は契約形態や時期によって異なり得るため、購入前に最新の公式資料と組織の規程を確認してください。
4. 出力の影響:下書き・提案・実行を混ぜない
最も重要なのは、生成物が何に使われるかです。社内のアイデア出しは下書きとして扱えますが、顧客向けの説明、採用候補者への連絡、契約文、価格表示、健康や投資に関する案内は、誤りが相手の判断に影響します。こうした仕事では、AIの出力を最終判断にせず、責任を持つ担当者が根拠を確認してから利用します。
外部システムを操作するエージェント型の運用では、さらに段階を分けましょう。検索・要約・草案作成は自動化の範囲に入れやすい一方、送信、公開、購入、返金、権限付与、データ削除は承認を必須にする、というように区切ります。承認者が内容と影響を理解できる画面・ログを用意することも、モデル選びと同じくらい大切です。
Solが候補になりやすい場面と、試すときの注意
Solは、複数段階の作業や複雑なコーディング、ツールを組み合わせるワークフローを検討するときに候補になります。たとえば、既存システムの仕様書とソースコードを読んで改修案を作る、複数部門から来た要望を整理して未決事項を抽出する、社内ナレッジを参照しながら問い合わせの下書きを作る、といった使い方です。
ただし、複雑な仕事ほど、正しそうに見える出力への注意が必要です。引用元が古い、存在しない根拠を補ってしまう、前提条件を落とす、似た名称の制度や商品を混同する、といったことが起こり得ます。検証では、正解を知る担当者が「どの資料のどの箇所を使ったか」を追えるようにし、根拠が示せない文章は採用しないルールを置きます。
コード作業の場合は、生成結果をそのまま本番環境に反映しないことが基本です。変更内容を人がレビューし、テスト環境で動かし、差分とロールバック手順を確認してから段階的に適用します。秘密情報をプロンプトやログに含めない、ツールの権限を読み取り中心から始める、外部送信を明示承認にする、といった制御は、どのモデルでも欠かせません。
Lunaが候補になりやすい場面と、量を増やす前の確認
Lunaは、焦点の定まった大量処理をコスト意識とともに進めたいときに候補になります。例としては、定型フォームの分類、事前に決めた項目への抽出、文書の重複候補の発見、社内向けFAQの下書き候補、短い文章の表記ゆれ点検などが考えられます。作業の入力形式と望む出力形式が安定しているほど、試験結果を比較しやすくなります。
一方で、大量処理に向くからといって、曖昧なルールを大量に適用してよいわけではありません。たとえば問い合わせの優先度を決める仕事では、緊急性の定義、対象外にする条件、人へ引き継ぐ条件を、先に文章で固定します。モデルに「良い感じに分類して」と任せると、担当者ごとの暗黙知が混ざり、再現性を確かめにくくなります。
実験では、通常例だけでなく、空欄、複数の意味を持つ語、誤字、例外、感情の強い表現、複数言語が混在する入力を含めます。失敗を見つけるためのデータを用意することは、導入を遅らせる作業ではありません。適用範囲を明確にし、誤処理を利用者に渡さないための準備です。判定が難しいものは「保留」として人に渡す選択肢を出力形式に含めると、無理な断定を減らせます。
小さな検証を、費用・品質・安全性で評価する手順
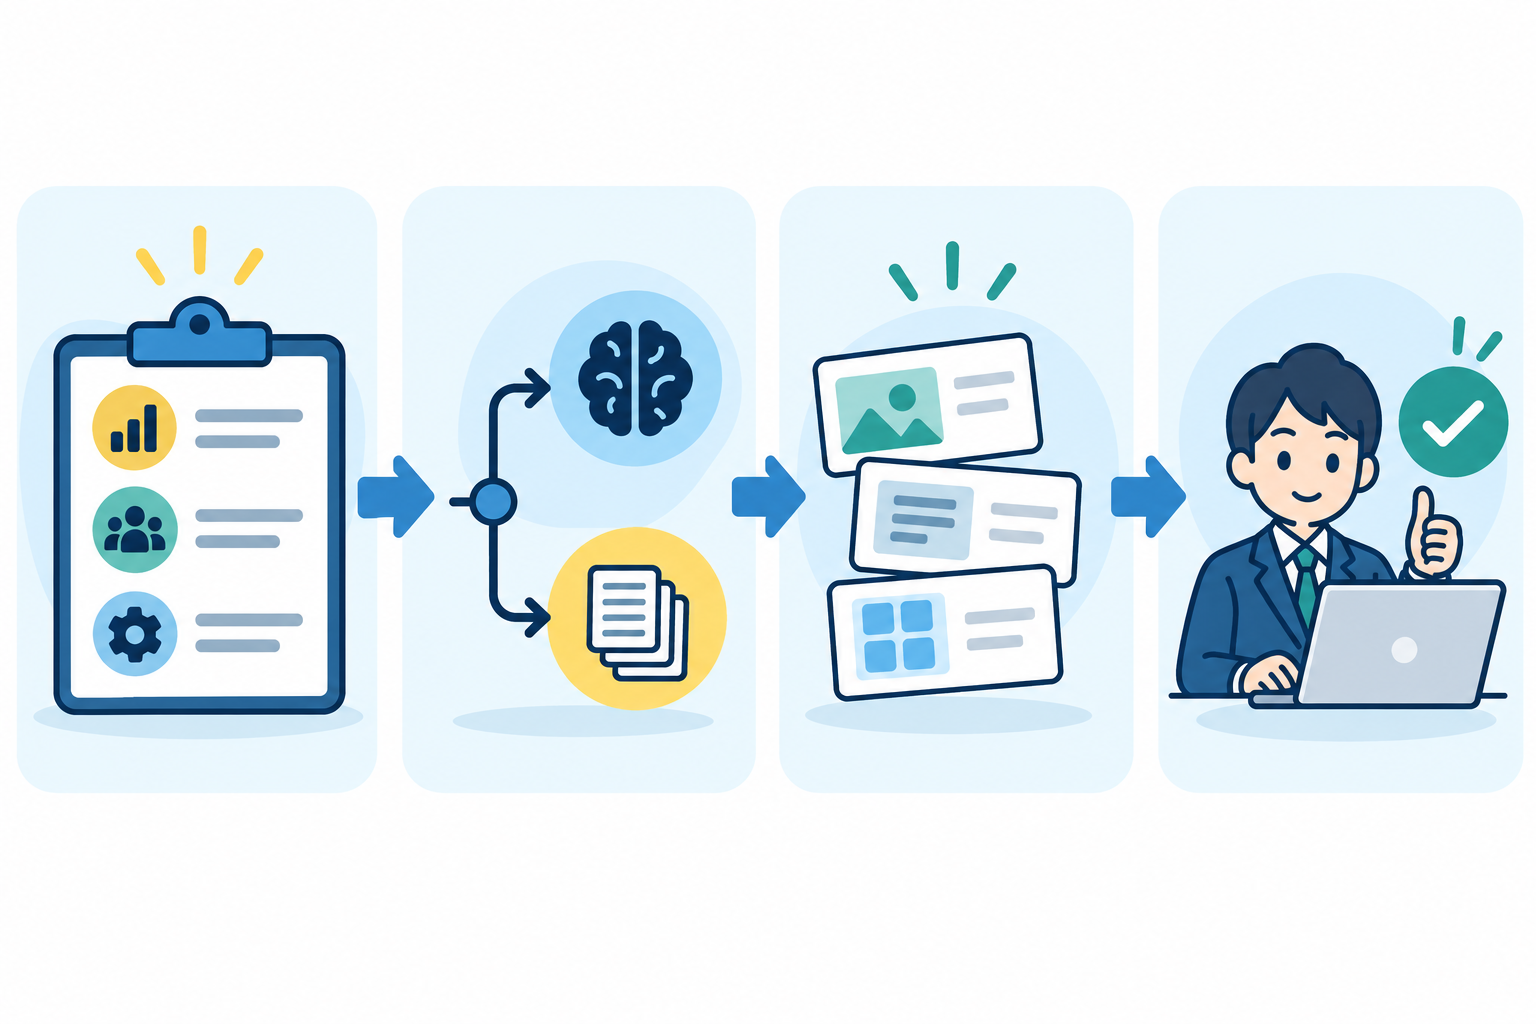
導入の可否を一度のデモで決めるより、限られた期間と範囲で試すほうが、組織に合う運用を見つけやすくなります。次の順で進めると、SolとLunaのどちらをどこに置くかを比較しやすくなります。
- 目的を一文で決める。「問い合わせ一次分類の手作業を補助する」のように、最終判断を置き換える表現は避けます。
- 入力と出力を固定する。使ってよいデータ、出力項目、利用禁止の用途、保存場所を決めます。
- 正解例と例外例を用意する。正答率だけでなく、根拠の欠落、危険な断定、個人情報の混入も確認します。
- SolとLunaを同じ条件で少量試す。モデル以外の指示や参照資料を同じにし、比較対象を明確にします。
- 人手の確認時間を記録する。生成時間だけでなく、修正・差し戻し・確認の時間を足します。
- 停止条件を先に決める。誤分類率、根拠不明の回答、情報区分違反など、止める条件を数値または具体例で合意します。
費用の見積もりは、トークン単価に想定処理件数を掛けるだけでは不十分です。再試行の回数、長い指示の入力、出力が冗長になる傾向、ツール利用、監視、レビュー担当者の時間を含めます。小さな検証で「1件当たりの総作業時間」と「人が修正した割合」を取得すれば、単価表だけでは見えない差が分かります。安いモデルを使うことより、修正作業や誤送信を含む総コストを下げることが目的です。
4コマで整理:選ぶ前に、分けて・試して・確認する
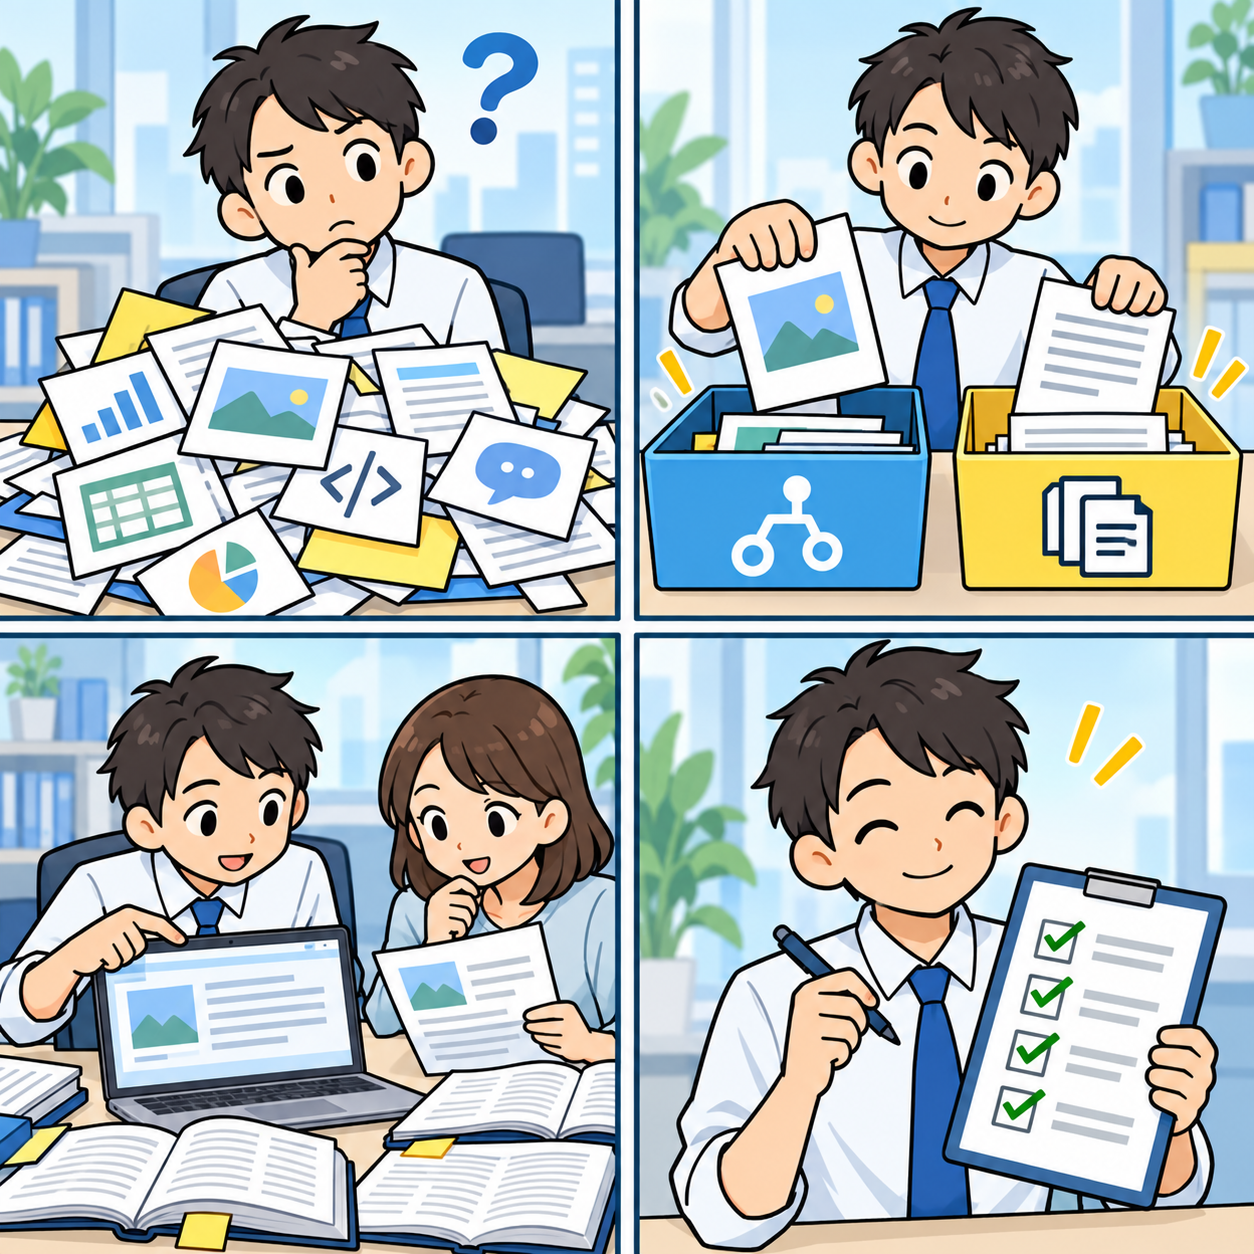
「難しい仕事にはSol、たくさんの定型作業にはLuna」と覚えるだけでは、実務の判断には足りません。最初のコマのように、仕事が混ざったままモデルを決めると、比較結果も曖昧になります。次に、複雑さと処理量だけでなく、情報の機微性と出力の影響を見て、仕事を分けます。
三つ目のコマでは、少量の代表データで結果を確かめます。この段階で、正解率が高くても根拠が追えない、例外に弱い、確認作業が想定以上に増えると分かることがあります。最後は、モデルの回答を採用するかどうかを人が確認する状態です。チェックリストは形式だけにせず、参照した資料、変更した内容、承認者、公開・送信の有無まで残せる形にすると、後から見直せます。
権限設計も、モデル選定と同時に決める
AIにブラウザー、ファイル、社内システムなどの道具をつなぐ場合は、モデルの能力評価と権限設計を切り離せません。初期段階では、閲覧・検索・下書きのように元データや外部の状態を変えない操作から始めると、試験結果を安全に確認しやすくなります。更新、送信、公開、支払い、削除、権限追加といった操作は、モデルが提案しても自動では実行せず、担当者が内容・宛先・影響範囲を確認して承認する形にします。
アクセス権は「便利だから広く渡す」のではなく、仕事ごとに必要な最小限へ絞ります。読み取り専用のアカウント、検証用のデータ領域、本番と分けた環境、期限のある一時権限を使えば、予期しない操作が起きたときの影響を狭められます。認証情報を会話の指示文やテスト資料に書かないこと、誰がいつ何を実行しようとしたかを記録することも基本です。
特に、モデルが外部情報を読んでから行動する仕組みでは、指示に見せかけた不適切な文が混入する可能性を考えます。参照先の文章をそのまま実行指示として扱わない、許可していない操作は拒否する、予算・送信先・変更対象の上限を設定する、といった境界が必要です。これはSolとLunaのどちらを使う場合でも同じで、便利なワークフローを長く使うための土台になります。
よくある疑問:どちらか一方に統一したほうがよい?
運用を単純にしたいという理由で一つに統一する判断はあり得ます。ただし、統一による管理のしやすさと、個々の業務に合う費用・待ち時間・品質のバランスは別に評価してください。小規模組織では、まず一つのモデルと限定された用途で安全な手順を固めるほうが、二つを同時に広げるより管理しやすい場合があります。
一方、部門ごとに無秩序にモデルを選ぶと、入力データの扱い、ログ、権限、費用負担の管理が難しくなります。モデルを増やす場合は、利用目的、許可されたデータ区分、承認が必要な操作、費用を見る担当者を共通化します。モデルの選定表を公開し、変更時には小さな再検証を行うことで、現場の使いやすさと統制の両立を目指せます。
まとめ:モデル名より、仕事の境界と人の責任を先に決める
GPT-6 Solは複雑なコーディングやエージェント型ワークフロー、GPT-6 Lunaはコスト重視の高処理量タスクという公式の位置づけを、選定の出発点にはできます。しかし、最適な使い方は組織のデータ、業務、確認体制で変わります。性能の印象や一回のデモで決めず、次の4点を順番に確認してください。
- 仕事を複雑さ、処理量、情報の機微性、出力の影響で分ける。
- 小さな代表データと例外データで、品質と修正時間を測る。
- 下書き、外部送信、権限変更などを分け、重要な操作には人の承認を置く。
- 価格、提供条件、データに関する設定は、実施時点の公式情報と社内規程で再確認する。
AIモデルは便利な道具ですが、責任の所在を肩代わりするものではありません。SolとLunaを比較する機会を、単価比較だけで終わらせず、「どの仕事を、どの情報で、誰が確かめて進めるのか」を見直す機会にすると、継続しやすい導入につながります。