2026年9月18日、Anthropicは、フロンティアAIを独立に評価するため、Accentureと「embedded evaluation(埋め込み型評価)」で提携すると発表しました。これは、外部の評価者が完成後のモデルだけを試すのではなく、AI企業の内部で開発の過程にも触れながら、レッドチーム、アラインメント評価、安全策の試験などを行う構想です。両社は今後5年間でこの分野の能力づくりにそれぞれ少なくとも10億ドルを投じる見通しも示しています。
AIの能力が高くなり、文章作成だけでなくコード実行、情報検索、外部ツールの操作へ広がるほど、「公開前に何を確かめたのか」は利用者にとっても重要になります。モデルが便利に見えることと、誤った行動、想定外の権限行使、偏り、情報漏えいの危険が十分に管理されていることは別の話です。今回の発表は、その距離を少し縮めるために、評価者をより開発に近い場所へ置こうとする試みだといえます。
一方で、仕組みが新しいからこそ、実効性はまだ決まっていません。評価者にどこまでアクセスを認めるのか。費用を開発企業が払う場合に、評価の独立性をどう保つのか。問題を見つけたとき、誰に報告し、何を社会へ公開するのか。この記事では、発表で分かっていることと未確定の点を分け、企業や一般の利用者がAIの「安全」を読むときの確認軸を整理します。
Anthropicが発表した埋め込み型評価とは
一般に、AIの評価にはいくつかの距離があります。開発チームが自ら行うテスト、完成品に近い状態で外部の専門家が試す評価、そして実際の利用環境で問題を監視する運用評価です。どれか一つだけで十分というより、異なる立場と時点から重ねることで、見落としを減らす考え方が基本になります。
今回Anthropicが説明した「埋め込み型評価者」は、通常の外部評価者より深いアクセスを持ち、社員に近い位置で開発の進み方、モデルづくりに関わる判断、社内の安全上の取り組みを観察する想定です。発表によれば、Accentureの専門AI事業であるFacultyが、モデルの評価とレッドチーミング、アラインメント評価、安全対策の試験を担います。レッドチーミングとは、悪用や想定外の振る舞いを意図的に探す検証です。
ここで大切なのは、「評価者が社内にいる」ことを、AIが安全だという証明と受け取らないことです。評価は、危険の有無を一度で白黒に分ける判定ではありません。どの用途で、どの権限を与え、どの失敗を想定し、どの証拠を確認したかを積み重ねる仕事です。独立した視点を近くに置くことは、開発側が見慣れてしまった前提を問い直す助けになりますが、最終的な安全責任は開発企業に残る、とAnthropic自身も明記しています。
なぜ完成後だけのテストでは足りないのか
AIモデルは、完成したアプリ画面だけでは評価しにくい性質を持ちます。学習データの扱い、訓練時の安全策、システム指示、ツール接続の設計、モデル更新の判断など、利用者から見えない工程が振る舞いに影響します。外から入力と出力だけを観察する評価は重要ですが、内部の意思決定や途中の警告を直接知ることは難しい場合があります。
たとえば、エージェント型のAIにファイル操作やウェブ操作の権限を与えるとします。出力文章だけを見れば正常でも、途中でどの情報源を開いたのか、何を保存したのか、失敗時に止まれるのか、権限が意図せず広がらないのかまで確かめなければ、実務での安全性は分かりません。開発の早い段階から評価者が設計を見られるなら、公開直前に発見して作り直すより早く、問題の芽を指摘できる可能性があります。
ただし、内部へのアクセスが広がれば、評価者自身も機密情報を扱うことになります。顧客情報、未公開の研究、セキュリティ上の脆弱性などを、誰がどの条件で見るのかという管理も必要です。「透明性」を高めるために情報の扱いが緩くなれば、別のリスクを生むからです。評価の深さと、情報の保護を両立させるルールが欠かせません。
発表で期待されるメリットを三つに分ける
第一は、早期発見です。開発の途中で安全上の懸念を見つければ、モデルや接続機能の設計を変更する余地が大きくなります。完成後の修正は、すでに利用者や取引先に影響が広がっていることもあります。評価者が開発の節目に関わることで、「発売前に問題を探す」だけでなく「危ない使い方を前提にしない構造へ直す」議論がしやすくなります。
第二は、説明可能性です。AI企業が安全への取り組みを公表しても、利用者は自社の説明だけで十分か判断しづらいものです。外部の知見を持つ評価者が、何を見て、どの制約があり、どのような懸念を伝えたのかが適切に示されれば、単なる宣言より検証可能な説明に近づきます。NISTのAIリスク管理枠組みも、個人、組織、社会に関わるリスクを、設計・開発・利用・評価の中へ組み込むことを目的にしています。
第三は、評価能力の蓄積です。AIの能力や利用形態は変化が速く、評価する側にも専門人材、試験環境、手法の共有が必要です。今回の提携は、企業内の実務に詳しい評価者を育てる取り組みとしても位置づけられます。ただし、投資額の大きさだけで評価の品質は測れません。評価の対象、発見事項への対応、報告の質が伴って初めて意味を持ちます。
いちばん大きい論点は「独立性」をどう実装するか
今回の発表で、Anthropicは、埋め込み型評価にはアクセス範囲、報告方法、資金調達の標準がまだないと説明しています。この率直さは重要です。評価者が「独立」と呼ばれるためには、開発企業にとって不都合な結果を出しても、評価の内容や担当者の立場が不当に左右されない仕組みが必要です。
今回の初期段階では、AnthropicがAccentureの業務に直接資金を出す予定です。これはすぐに評価が無意味になることを示すものではありません。実務を立ち上げるには費用が必要であり、評価者の専門性も価値があります。ただし、資金を出す企業と評価される企業が同じ場合、利用者が納得できる独立性をどう示すかは残ります。契約上の保護、評価範囲を評価者が提案できる余地、報告の公開原則、意見が対立したときの記録などが確認ポイントになります。
長期的には、複数の評価機関、非営利団体、大学、監督当局などが関わり、資金源も一社に偏らない形が望ましいと考えられます。AnthropicもMETRなどの非営利評価団体と話し合っているとしています。大切なのは、特定の組織だけを「お墨付き」の役にしないことです。異なる手法と立場を持つ評価が並び、結果の違いも含めて議論できる環境のほうが、過度な安心感を避けやすくなります。
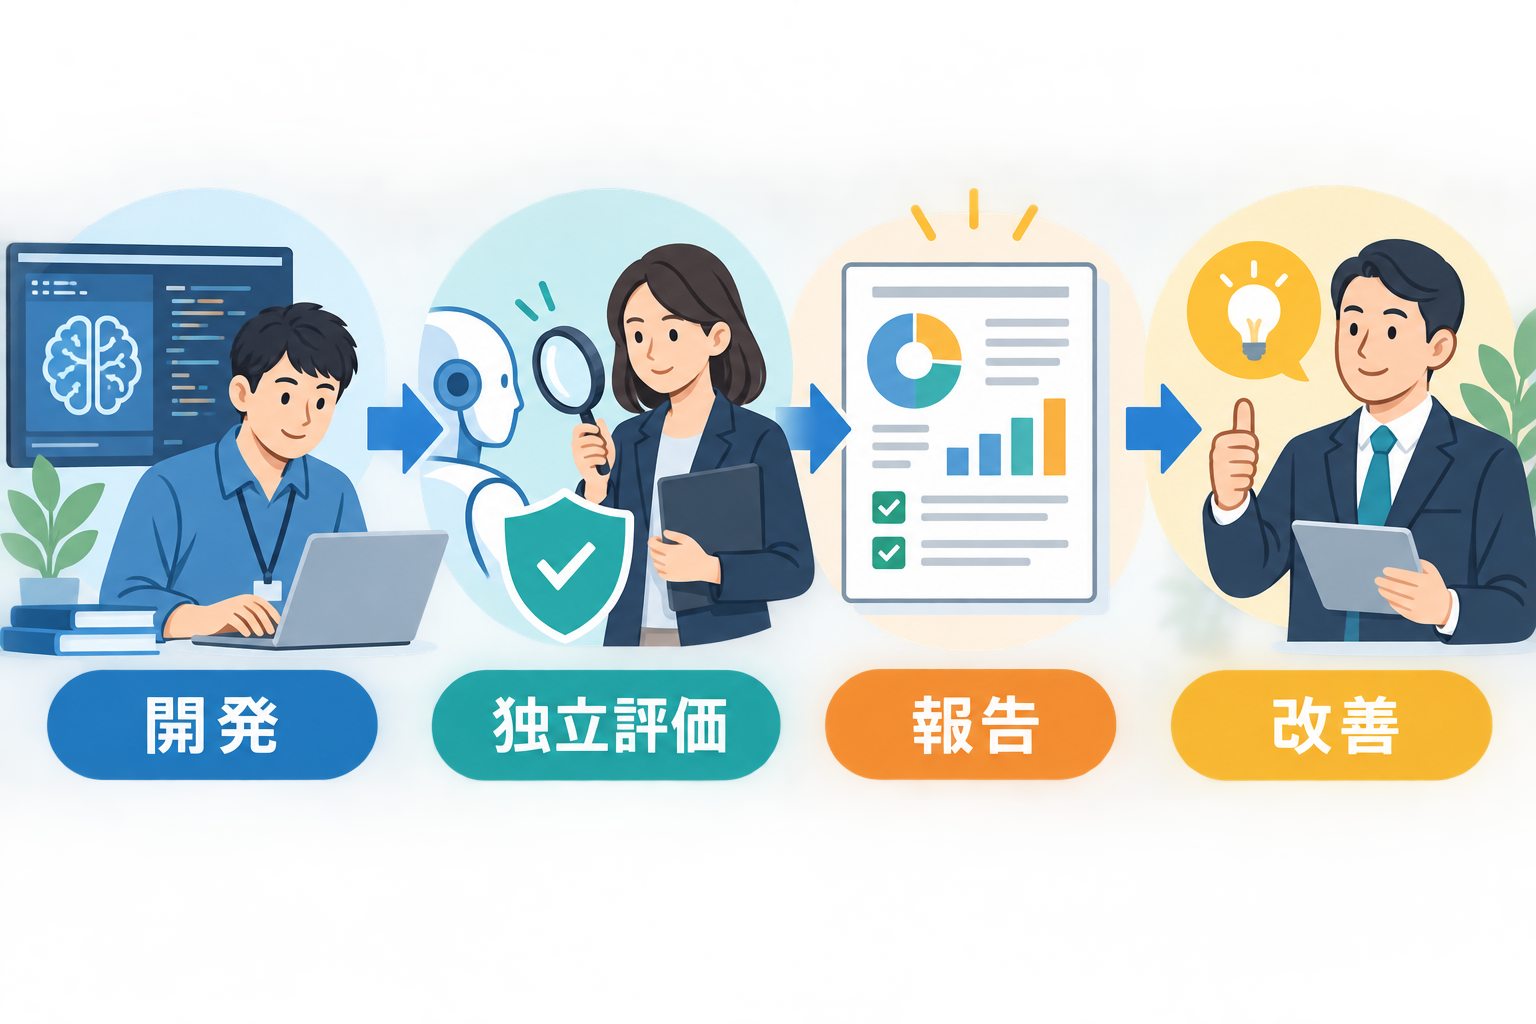
「評価した」という言葉を読むための五つの質問
企業の発表やサービス説明に「安全性を評価済み」と書かれていたら、まず評価対象を確認します。文章の誤りなのか、偏りなのか、サイバー悪用なのか、個人情報なのか、外部ツールの誤操作なのか。対象によって必要な試験は違います。広い言葉だけで、あらゆる危険が確認済みだと受け取るのは早計です。
次に、誰が評価したのかを見ます。開発チームの内部テストか、独立した第三者か、利用企業の監査か。内部評価は製品を最もよく知る強みがあり、第三者評価は別の視点を持ち込める強みがあります。どちらが絶対に優れているというより、役割と限界を開示しているかが重要です。
三つ目は、評価の時点です。公開前の一回限りか、モデル更新のたびに行うのか、実運用の事故情報を反映するのか。AIサービスは更新で性能も振る舞いも変わり得ます。昨月の評価結果が今日の接続設定まで保証するとは限りません。変更管理と継続監視の説明があるかを確かめましょう。
四つ目は、問題が見つかった後の対応です。機能の停止、権限の縮小、利用者への通知、再発防止、外部への報告といった流れが定義されているでしょうか。評価レポートの数より、問題が起きたときに止めて直せる運用のほうが重要なことがあります。
五つ目は、評価の限界です。公開できない情報があること自体は珍しくありません。しかし、何が未検証か、どのような条件では結果が当てはまらないか、どんな用途を想定していないかを示す姿勢は、利用者が判断する材料になります。安全を断言するより、限界を説明できる組織のほうが、改善へつながりやすいといえます。
導入企業が外部AIを見るときの実務チェック
自社でAIを導入する側も、提供企業の評価をそのまま受け入れるだけでは足りません。最初に、自社で使う機能と権限を具体的にします。議事録の下書き、社内文書の検索、顧客対応、コード実行、購入手続きの補助では、影響の大きさが異なります。小さな補助から始め、重大な判断や外部送信を含む機能は人の承認を置く、といった段階的な設計が基本です。
次に、データの流れを図にします。誰のデータを、どのサービスへ、どの保存期間で渡すのか。学習利用の有無、国外移転、削除方法、委託先、ログの扱いを、契約と設定の両方で確認します。個人情報、営業秘密、未公表の研究、医療・金融・人事の情報は、便利さだけで外部AIへ渡してよいものではありません。社内規程、契約、法令、専門担当者の確認が必要です。
また、AIの出力を誰がレビューするかを決めます。医療、法律、税金、投資、保険、採用、教育、福祉、行政サービスなど、人の権利や生活に大きく影響する場面では、AIの回答を単独の根拠にしてはいけません。一次情報、資格を持つ専門家、責任者の確認を組み合わせ、誤りを訂正する窓口を用意してください。本記事は個別の法律・医療・投資判断を助言するものではありません。
埋め込み型評価が社会に根づくために必要なもの
この取り組みが一社の新しい制度で終わらず、社会に役立つ仕組みになるには、比較可能な基準が必要です。評価者がアクセスできる範囲、試験の再現性、重大な発見の扱い、公開できる要約、利益相反の開示、評価者の保護などが、各社で大きく違いすぎれば、利用者は内容を比べられません。
政府だけ、企業だけ、研究者だけで完結する問題でもありません。技術の専門家は試験方法を磨き、企業は設計と運用の情報を提供し、利用組織は現場の失敗を共有し、市民社会や制度設計者は人権・消費者保護・説明責任の観点を持ち込みます。EUのAI Boardが同日にAI Actの実施、透明性、フロンティアAIの安全性やサイバー面を議論したことも、評価が技術だけの課題ではないことを示しています。
重要なのは、評価を「公開のための儀式」にしないことです。開発スケジュールが迫ったときに悪い結果を無視しないこと、評価者が懸念を言えること、利用者が問題を報告できること、改善後にもう一度確かめること。この循環が動かなければ、どれほど立派な名称でも実質は伴いません。
まとめ:安全は宣言ではなく、確かめて改善する過程
AnthropicとAccentureの提携は、AIの安全評価を、完成品を外から試すだけでなく、開発の近くで継続的に行おうとする新しい試みです。早期に問題を見つけ、開発側の説明を検証し、評価能力を育てる可能性があります。その一方で、評価者の権限、資金の独立性、報告の透明性、発見後の対応には、これから具体化すべき点が残ります。
利用者や導入企業が注目したいのは、「独立評価」という名称だけではありません。何を、誰が、いつ、どの範囲で見たのか。問題を見つけたら、止めて直し、説明できるのか。AIに重要な仕事を任せるほど、この基本的な確認が価値を持ちます。
AIは便利な提案を素早く返せますが、責任を負うのは人と組織です。評価を万能の保証として扱わず、根拠を確認し、限界を共有し、必要なら利用を止める。この地道な設計こそが、AIを安心して役立てるための土台になります。
利用者の立場からできる、身近な確認
大きなAI企業の内部評価は、個人には遠い話に見えるかもしれません。しかし、日常で使う生成AIの選び方にも同じ考え方を応用できます。たとえば、仕事で文章作成を頼む場合、出力をそのまま送らず、日付、固有名詞、数字、引用元を原資料で確かめる。ファイルを要約させる場合、機密情報を入力してよい契約・設定かを確認する。自動実行の提案が出た場合、まずは下書きやプレビューで内容を見てから人が承認する。これらは特別な技術がなくてもできる、利用者側の小さな評価です。
とくに「AIが調べた」「AIが判定した」という表現には注意が必要です。AIはもっともらしい説明を作ることがありますが、情報源の正しさ、対象者の事情、最新の制度や条件まで自動で保証するわけではありません。医療症状、服薬、法律上の手続き、税務、投資、保険、雇用や進学などでは、AIの出力を最終判断に使わず、公的機関の一次情報や専門家・担当窓口を確認してください。相談の準備として論点を整理する用途と、個別の結論を代行させる用途は分ける必要があります。
AIサービスの画面には、利用規約、データ利用の説明、管理者向けの設定、出力の注意書きが置かれていることがあります。すべてを一度に読み切れなくても、重要な仕事で使う前に、入力データが学習に使われるか、履歴を削除できるか、組織の管理者が権限を制御できるか、問い合わせ先があるかを確認するとよいでしょう。提供者が評価の内容を説明している場合も、これは便利か、ではなく「自分の用途で起こる失敗を想定しているか」という目で読むと、判断が具体的になります。
評価結果を「数字だけ」で比べないために
AIの安全性を示す資料には、テスト件数、検知率、危険な回答の減少率、ベンチマークの点数など、数字が並ぶことがあります。数字は比較の入口になりますが、単独では意味が定まりません。どのような入力を集めたのか、テストは誰が作ったのか、実際の利用環境に近いのか、失敗例が除かれていないか、別の言語や少数の利用者に同じように当てはまるかを見なければ、数字だけが安心感を大きく見せるおそれがあります。
たとえば、有害な依頼への応答を減らす試験が高得点でも、誤った医療情報をもっともらしく作る問題、個人情報を含む文書の取り扱い、権限を持つツールの意図しない操作は、別途確かめる必要があります。反対に、特定の試験で失敗が報告されていても、企業が原因、影響範囲、当面の制限、修正予定を明確にしているなら、その情報は改善可能性を判断する材料になります。失敗をゼロと宣伝することより、失敗を把握し、利用者に伝え、修正後を再評価する循環のほうが信頼に近づきます。
また、評価には「偽陽性」と「偽陰性」の難しさがあります。危険ではない操作まで広く止めれば安全に見えるかもしれませんが、正当な利用を過度に妨げることがあります。逆に便利さを優先しすぎれば、危険な操作を見逃す可能性が高まります。どこに線を引くかは技術だけで決まらず、利用分野、影響を受ける人、代替手段、異議申立ての仕組みを含めて考える社会的な判断です。埋め込み型評価者には、この線引きが開発都合だけで決まらないよう問い続ける役割も期待されます。
これから公開される情報で見たいこと
今回の提携について、今後特に注目したいのは四点です。第一に、評価者がどの開発段階と情報にアクセスするのか。第二に、重大な懸念が出た場合に開発・公開の判断へどう反映されるのか。第三に、評価費用、契約、報告書の扱いを含む利益相反がどの程度開示されるのか。第四に、評価者の見解と開発企業の見解が異なったとき、その違いが記録・説明されるのかです。
すべての技術情報を公開することが常に適切とは限りません。脆弱性の詳細は悪用につながることがあり、個人情報や企業秘密も守る必要があります。それでも、外部の利用者が「何も分からない」状態では独立評価の価値を判断できません。対象範囲、方法の概要、主要な発見の分類、対応状況、限界、次回の見直し時期など、悪用を招かない水準の説明を継続して示せるかが問われます。
AIの安全は、完成した認証マークを貼って終わる性質のものではありません。モデル、データ、接続先、利用場面、社会のルールが変われば、リスクも変わります。今回のような評価の仕組みが、批判を避けるための看板ではなく、開発を止めてでも検証し、改善するための実務として育つか。利用者側も、便利さだけでなく説明と検証を求めることで、その方向を後押しできます。