2026年9月24日、GoogleのProduct Securityチームは、社内のWebアプリケーションを対象にしたAIエージェントの取り組み「PageBreak」を公開しました。狙いは、AIに脆弱性の候補をたくさん挙げさせること自体ではありません。候補の中から、実際に悪用できる問題を見極め、開発チームが直せる形の根拠へつなぐことです。
AIによるコード解析やセキュリティ診断は、すでに珍しい技術ではありません。ただし、もっともらしく見える誤報、文脈を外した警告、すでに防御済みの箇所の指摘が大量に届けば、確認する人の時間を奪います。Googleはこの「ノイズ」を、AIを使った脆弱性管理の大きなボトルネックとして挙げています。PageBreakは、候補を出すAIと、攻撃が成立するかを検証するAIを分け、最終的には人の専門家が確認する設計を試みたものです。
この記事では、Googleが9月24日に公表した内容を基に、PageBreakが何をしようとしているのか、従来のAIセキュリティ診断と何が違うのか、利用する側がどのような確認を用意すべきかを整理します。製品の安全性や個別の脆弱性の有無を保証するものではありません。医療、金融、行政、教育、法律など重要なサービスのセキュリティ判断は、組織の責任者と有資格・専門の担当者が、公式情報と自組織の環境を確認して行ってください。
Googleが発表したPageBreakとは
PageBreakはGoogle Product Securityの内部プロジェクトとして説明されているAIエージェントです。Googleの一次情報によると、同社のファーストパーティWebアプリケーションの安全性をテストするため、2025年11月に試行を始め、2026年1月に本格的なプロジェクトへ移行しました。公開の目的は、AIによる候補列挙を増やすだけでなく、実証可能な脆弱性を優先して見つけ、担当チームが対応できるようにすることです。
ここでいうWebアプリケーションは、利用者がブラウザから操作するサービスや社内向け画面を含みます。入力フォーム、ログイン、データ表示、API、管理画面などが組み合わさるため、コードを一部分だけ読んでも実際の挙動を理解しにくい場合があります。攻撃者が入力をどう変えるか、権限の異なる利用者が同じURLを開いたらどうなるか、複数の画面遷移を重ねたら何が起きるかまで確かめて、初めて危険性を評価できることがあります。
Googleの説明で注目されるのは、PageBreakが「静的解析の代用品」だけを目指していない点です。静的解析は、プログラムを実行せずに危険な書き方や不整合を探す有用な手法です。しかし、AIがコードを読んで「ここが危ないかもしれない」と文章で返すと、現実には成立しない攻撃まで混ざることがあります。Googleはこれを、候補報告のかなりの部分がAI由来のノイズや偽陽性となり、現場の負担を増やし得る問題として捉えています。
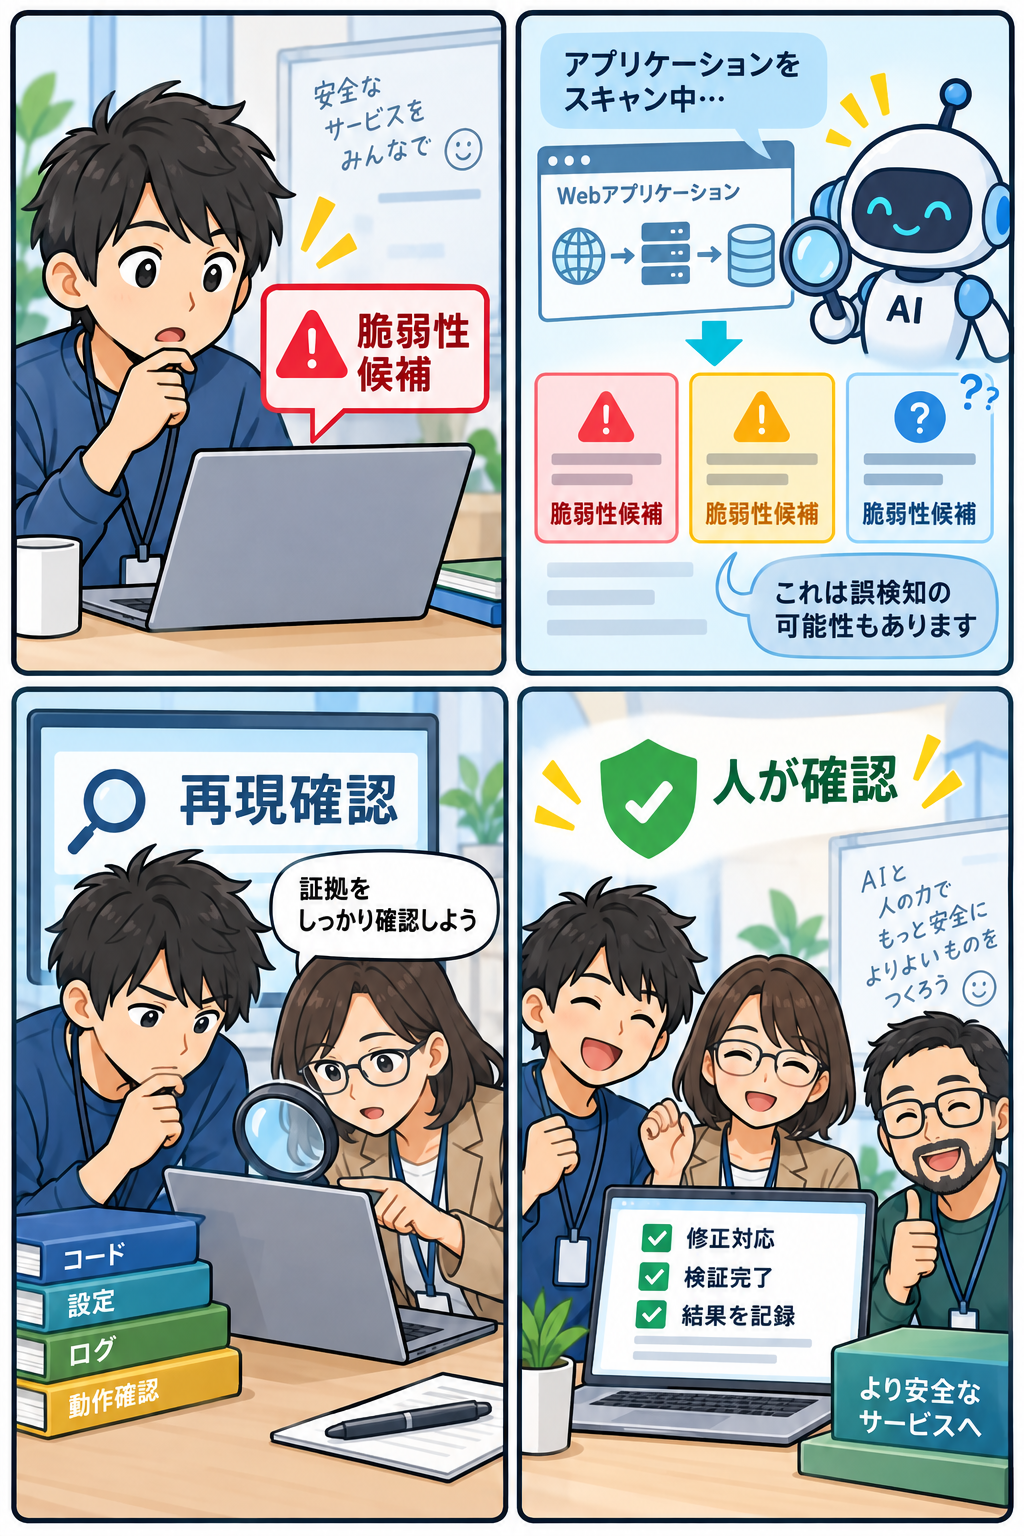
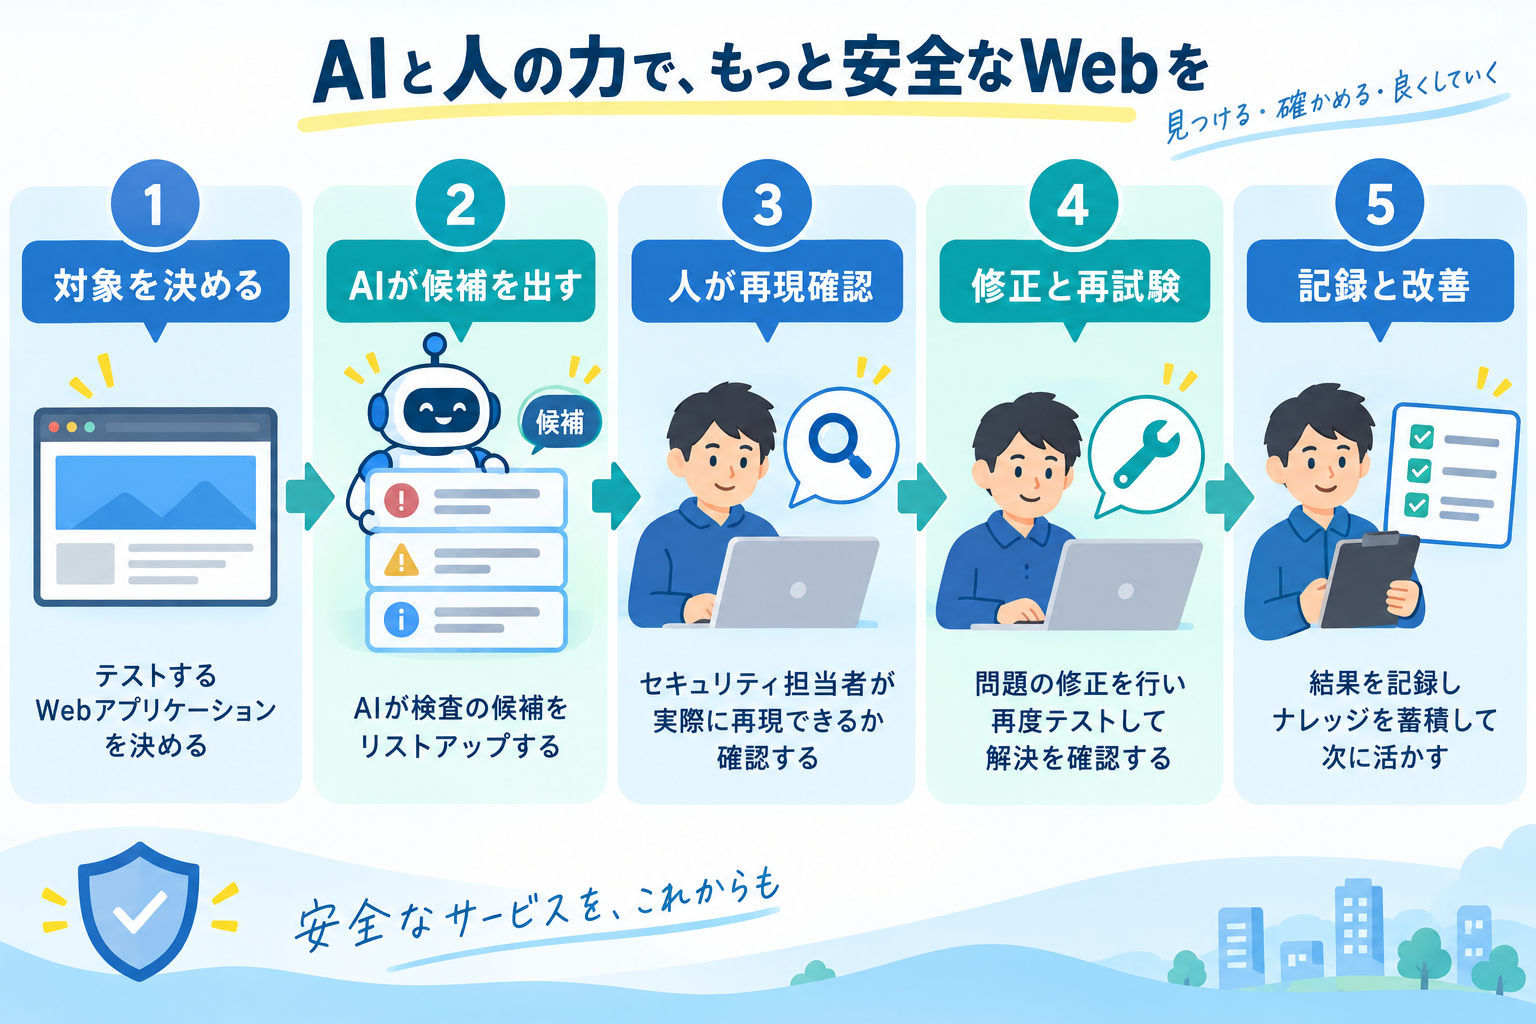
そこでPageBreakは、発見役のエージェントと検証役のエージェントを組み合わせます。発見役はソースコード、設定、画面の構造などから仮説を作ります。検証役は、その仮説が対象アプリの動く環境で本当に再現できるか、どの条件で影響が出るかを調べます。公開記事には、最終的にセキュリティエンジニアが内容を確認し、妥当な修正へつなげる前提も示されています。AIが警告したから直すのではなく、根拠を追って直すという流れです。
なぜAIの脆弱性候補が「多すぎる」と困るのか
脆弱性の検出では、見逃しを減らすことが大切です。一方、警告が多ければ多いほど安全になるわけではありません。たとえば1,000件の候補のうち実際に修正が必要なのが数件なら、残りを調べる間に重要な問題への対応が遅れます。開発者は原因を理解し、再現し、影響範囲を確認し、修正し、再試験しなければなりません。候補の質が低いと、この一連の作業に必要な時間が膨らみます。
AIの出力が厄介なのは、文章が自然で説得力を持ちやすいことです。「この入力がHTMLとして解釈される可能性がある」「この認可チェックは迂回できるかもしれない」といった説明は、ぱっと見では正しく思えます。しかし、実際には入力値が別の層で無害化されていたり、アクセス制御が共通の仕組みで働いていたり、テスト用のコードが本番には入っていなかったりします。断片的なコードだけを見れば危険でも、実行環境では悪用できないことがあります。
逆に、AIが「安全」と説明した箇所が本当に安全とも限りません。複数の機能をまたぐ問題、設定の組み合わせで起きる問題、利用者の操作手順に依存する問題は、単純なパターン照合では捉えにくいことがあります。AIを導入すると、人が確認しなくてよい、という結論にはなりません。どの候補を優先し、どの証拠がそろえば修正に進むのかを、組織として決めておく必要があります。
GoogleがPageBreakで示した考え方は、AIを「警告を量産する装置」ではなく、「検証可能な仕事の下書きを作る補助者」として扱うものです。候補に再現手順、前提となる権限、対象のバージョン、観察した結果、想定される影響が添えられていれば、人はゼロから調べずに済みます。それでも、実際の運用への影響と修正の優先順位を決める責任は、人と組織に残ります。
PageBreakの仕組み:候補、実証、修正を切り分ける
Googleの公開記事は内部実装のすべてを明らかにしているわけではありません。そのため、外部の組織が同じ性能を再現できるとまでは言えません。ただ、公開された説明からは、AIエージェントを一つの万能な判定者にせず、役割を分ける設計が読み取れます。
第一の役割は、攻撃の仮説を出すことです。Webアプリの画面、入力、API、認証、データの受け渡しを見て、「この値が想定外の形で扱われないか」「別の利用者のデータに届かないか」といった候補を作ります。この段階の出力は、結論ではなく調査の出発点です。候補数の多さは探索範囲の広さを示すかもしれませんが、そのままリスク件数を示すものではありません。
第二の役割は、実証です。Googleは候補を実際に試し、動的に検証する仕組みを説明しています。たとえばクロスサイトスクリプティング(XSS)は、悪意ある入力がブラウザでスクリプトとして実行され、利用者の操作や情報に影響する可能性がある問題です。候補の文字列がコード中にあるだけではXSSとは決められません。対象画面へ到達できるか、入力がどのように処理されるか、実行可能な状態になるかを確かめる必要があります。
第三の役割は、結果を開発チームが扱える形にすることです。再現できたなら、どの条件で起きたか、影響はどこまでか、何を修正すればよいかを整理します。再現できなかった場合も、単に「失敗」として捨てるのではなく、なぜ失敗したかを記録すれば、次の候補生成の条件を改善できます。安全な運用では、見つけた件数だけでなく、誤検知率、再現までの時間、修正後の再発率、検証できなかった理由も見るべきです。
Googleは、2026年9月4日時点で、対象フレームワークで構築された数百のWebアプリケーションをスキャンし、XSSは2件だけ特定したと説明しています。しかもそれらは内部アプリか、ハードニングに課題のあったデバッグ用エンドポイントに限られたとされています。この数値はGoogleの環境と評価条件における公表値であり、他社のアプリに同じ割合で問題がある、あるいはないことを意味しません。それでも、AIの候補を実証で絞る設計を重視していることは分かります。
従来のセキュリティ対策と何が違うのか
AIエージェントが登場しても、基本的な対策は不要になりません。入力値の検証、権限管理、依存ライブラリの更新、ログ監視、バックアップ、脆弱性の報告窓口、第三者によるテストといった積み重ねは、今もセキュリティの土台です。PageBreakのような取り組みは、その土台を補うための探索と検証の自動化として捉えるのが適切です。
従来の静的解析は、早い段階で危険なコードの書き方を見つけるのに向いています。動的テストは、アプリを動かしながら実際の挙動を確かめるのに向いています。人によるレビューは、仕様、事業上の影響、利用者の行動、組織固有の例外を含めて判断するのに向いています。AIエージェントは、これらの間を行き来しながら候補を整理し、テストの準備を助ける可能性があります。
一方で、AIを導入すると新たな管理対象も生まれます。AIがアクセスできるコード、設定、ログ、テスト環境には、顧客情報、認証情報、未公開の設計が含まれる場合があります。外部のAIサービスを使うなら、送信するデータ、保存期間、学習利用の有無、アクセス権、委託先の管理を確認しなければなりません。社内環境で動かす場合も、AIエージェントにどの操作を許すか、実行ログをどう残すか、異常時に止められるかが重要です。
「AIが攻撃も試す」と聞くと、不安を感じる人もいるでしょう。だからこそ対象範囲を限定し、許可されたテスト環境で行い、実行できる操作に制限を設ける必要があります。実サービスで無制限に試すことや、第三者のシステムを許可なく検査することは、技術的にも法的にも問題になり得ます。PageBreakはGoogleの社内アプリを対象とする取り組みとして公表されたものであり、他者のサイトへの無断テストを勧めるものではありません。
導入前に確認したい七つのポイント
PageBreakの発表は、大規模な組織の事例です。しかし、AIを使ったセキュリティ支援を検討する中小企業や開発チームにも、参考にできる点があります。大がかりなエージェントを作る前に、次の確認を設計しておくと、期待と現実の差を小さくできます。
1. 目的を「検出件数」ではなく「修正の質」に置く
最初に決めるべきは、何件見つけるかではなく、何を改善したいかです。重要な機能のリスクを早く確認したいのか、リリース前レビューの負担を減らしたいのか、同じ種類の不具合を減らしたいのかを言語化します。件数だけを目標にすると、AIがもっともらしい候補を増やす方向へ最適化され、確認する人が疲弊しやすくなります。
2. 対象と権限を最小限から始める
最初から全システム、全権限で動かす必要はありません。テスト環境の限られた機能、公開前の新規画面、過去に問題が起きやすかった入力処理など、範囲を絞ります。AIが読めるリポジトリ、使える認証情報、送信可能なリクエスト、変更可能な設定を最小限にし、必要に応じて段階的に広げます。
3. 再現の基準を明文化する
「AIが危険と言った」ことを報告の完了にしないことが重要です。誰が、どの環境で、どんな操作をしたとき、何が観察できれば再現と見なすのかを決めます。再現に失敗した場合の扱いも必要です。確認できない候補を即座に無視するのではなく、条件不足なのか、誤検知なのか、追加調査が必要なのかを区別します。
4. 人が読むための根拠を必須にする
AIの報告には、対象URLやコードの位置だけでなく、前提条件、再現手順、期待される結果、実際の結果、影響を受ける利用者、確認済みの防御策を含めます。出典やログへの参照がなければ、担当者はAIの説明を信じるしかありません。根拠を追える形式にすることで、誤りを早く見つけられ、修正のレビューも行いやすくなります。
5. 修正と再試験を同じ流れに入れる
警告をチケットに登録して終わりにしないことも大切です。修正を入れた後に、同じ再現手順が通らなくなったか、別の機能を壊していないか、同種の問題が残っていないかを確かめます。AIが候補を出す工程だけが速くなっても、修正と確認が詰まれば、利用者にとっての安全性は上がりません。
6. ログと説明責任を残す
どのモデルやツールに、いつ、どの権限で、何を調べさせたかを記録します。候補の採用・不採用、修正の理由、例外的に受け入れたリスク、再試験の結果も残すと、後から判断を説明しやすくなります。事故や問い合わせが起きた際に「AIがそう言った」だけでは、利用者や監督者への説明になりません。
7. 停止条件と相談経路を用意する
AIが想定外の操作を試そうとした、機密情報を含むログを出力した、重要なサービスへの影響が疑われる、といったときは自動実行を止める必要があります。誰が停止を判断し、どの担当者へ連絡し、利用者への通知をどう行うかをあらかじめ決めます。特に個人情報や決済、健康情報を扱うサービスでは、法務、プライバシー、セキュリティ、事業部門が連携できる経路が欠かせません。
医療・金融・公共サービスで一層慎重に扱う理由
AIによるセキュリティ検証の対象が、診療予約、保険、決済、投資、行政手続き、学習支援などの場合、誤った判断の影響は大きくなります。脆弱性の見落としは情報漏えいや不正利用につながる可能性があります。一方で、誤った警告への過剰反応は、正規の利用者のサービス停止や、必要な支援の遅れにつながり得ます。
そのため重要領域では、AIの出力を単独の根拠にして、利用者のアクセスを止めたり、請求や資格の判断を変えたりしてはいけません。AIは調査の優先順位付けや証拠収集を助ける道具として使い、最終判断は権限を持つ人が、法令、契約、組織の規程、専門知識に基づいて行うべきです。セキュリティ対策であっても、利用者に不利益が生じる可能性を考え、異議申立てや復旧の手順を用意する必要があります。
また、AIツールへ入力するログやテストデータは、本番の個人情報をそのまま含めないよう注意が必要です。必要最小限に加工し、匿名化・マスキングの可否を検討し、アクセスを記録します。外部サービスへのデータ移転がある場合は、契約と利用規約、保存地域、再委託、削除方法を確認してください。技術的に便利であることは、適法性や説明可能性を自動的に満たすことを意味しません。
「AIが見つける」から「安全に直せる」へ
GoogleのPageBreakが示すもっとも重要な点は、AIの能力を大きく見せることではなく、候補から証拠へ、証拠から修正へ進む流れを重視しているところです。AIのセキュリティ活用では、発見数や派手なデモが注目されがちです。しかし、利用者の安全を高めるのは、再現できる問題を見極め、影響を判断し、修正し、再発を防ぐ日々の運用です。
今回の公表はGoogleの社内プロジェクトに関するもので、第三者が同等の成果を検証した報告ではありません。対象範囲、評価方法、誤検知の扱い、長期的な有効性は、今後も公開情報と実務の知見を見ながら判断する必要があります。それでも、AIを万能の審判にしないこと、検証と人の責任を工程に組み込むことは、多くの組織に共通する教訓です。
AIを使うかどうかを二択にするより、「どの作業を任せ、どこで人が止めて確認し、何を記録するか」を具体的に決めることが重要です。開発者、セキュリティ担当者、事業責任者、利用者支援の担当者が同じ情報を見られるようにすれば、AIの速さを、説明できる安全性へ近づけられます。
まとめ
Googleが9月24日に公表したPageBreakは、AIでWebアプリの脆弱性候補を探しつつ、動的な検証と人の確認でノイズを減らそうとする取り組みです。大切なのは、AIの警告をそのまま結論にせず、再現条件と根拠を確認し、修正後に再試験し、記録を残すことです。
AIは調査の幅と速度を広げられますが、リスクの受容、利用者への影響、修正の優先順位、重要サービスの停止や復旧を決める責任までは引き受けません。これからAIをセキュリティ業務へ取り入れるなら、候補の量ではなく、確認できた問題を安全に直せる工程を先に整えることが、堅実な第一歩になります。