FacebookやInstagramなどを事業に活用していると、プラットフォームの規約変更が自分のウェブサイトにどう影響するのか気になることがあります。2026年10月、Metaの商用規約をめぐって、関連するサイトの情報収集とAIへの利用可能性について議論が起きました。
米国の報道機関Nieman Labは、Metaが新しい商用規約の文言を修正し、「train(学習させる)」という語を削除した一方、残る規定の範囲について法律専門家が懸念を示していると伝えました。続報の公開は米東部時間10月17日午後、日本時間では10月18日未明です。
重要なのは、規約の文言、実際に行われるデータ収集、AIモデルの学習に使われたという事実、そして法的な結論を混同しないことです。この記事では、報道時点で確認できる内容と見解の違いを整理し、ブログや事業サイトの運営者が自分の状況を確認する手順を考えます。
Metaの商用規約変更で何が話題になったのか
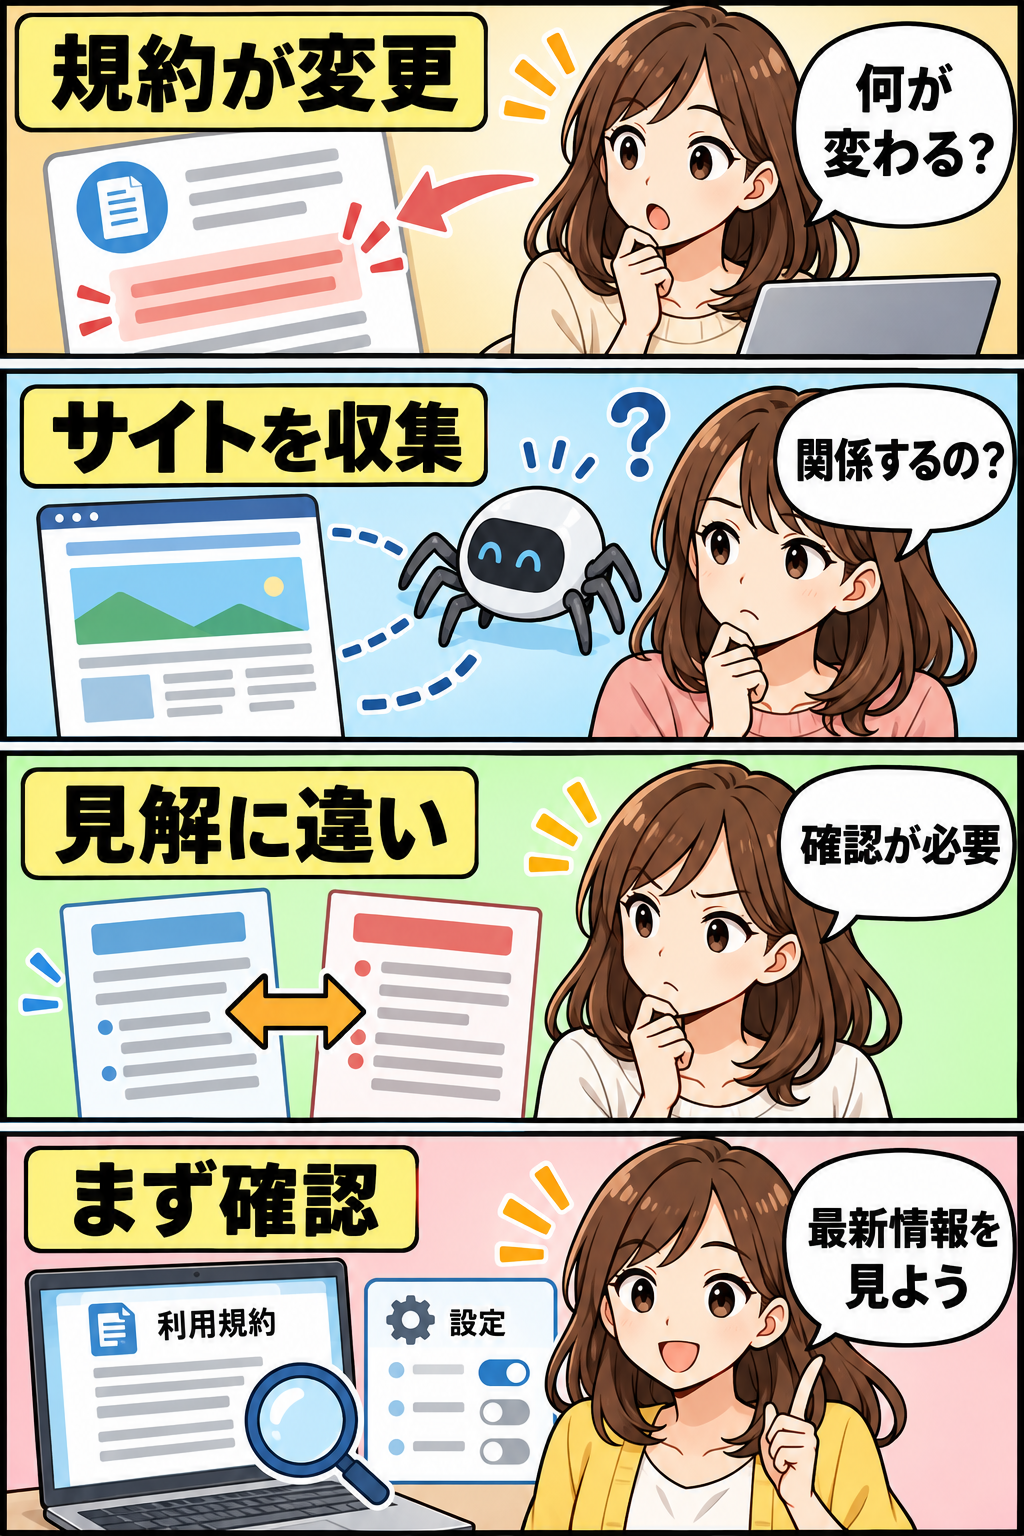
Nieman Labの10月15日の報道によると、Metaは10月30日から適用予定の商用規約に、事業用アカウントに関連するサイトなどを自動的にアクセスし、収集することに関する文言を盛り込みました。対象となる利用形態は、ページや広告、事業用ツールなどを含みますが、自分の契約にどの規約が適用されるかは、アカウントの種類、所在地、利用機能や最新の規約によって確認する必要があります。
報道で注目されたのは、SNSに投稿した文章だけでなく、事業やサービスに関連するウェブサイトの内容にも規定が及び得るという点です。サイト運営者にとって、自社のページがSNSのアカウントとどう結び付けられるかは、サイトへのアクセスや情報利用の範囲を考える出発点になります。
ただし、「関連する」という文言の具体的な範囲や、特定のサイトにどのように適用されるかをこの記事だけで確定することはできません。リンクを置いているだけの場合、複数の事業を扱う場合、外部サービスにサイトの一部を委託している場合など、関係の形はさまざまです。規約本文と自分の利用状況を照らし合わせることが欠かせません。
「train」の削除で何が変わった?
Nieman Labの続報によれば、Metaは批判を受けて予定されていた文言を修正し、利用目的の列挙から「train」という語を削除しました。また、目的を広くMeta製品全般とする表現から、広告・ビジネス関連製品に関する表現へと改めました。
この修正は、当初案と修正後の案を区別して読むための重要な変化です。しかし、単語がなくなったことだけで、すべてのAI関連利用が禁止された、あるいは逆に必ず実施される、と結論づけることはできません。残った「開発」「改善」などの言葉の意味や対象製品の範囲について、法律専門家が広く読める可能性を指摘しているためです。
Meta側は、広告とビジネス製品に関するクローリングの条項を明確化したもので、サイト運営者のrobots.txtの設定を上書きする新たな権利を与えるものではないと説明しています。一方、取材を受けた専門家は、修正後も規定の幅が広く、懸念は解消されていないと述べています。これは見解の相違であり、いずれかを裁判所の確定判断のように扱うことはできません。
クローリングとスクレイピングとは
クローリングは、自動プログラムがウェブ上のページにアクセスし、リンクをたどるなどして情報を巡回することです。スクレイピングは、ページから必要な情報を取得する処理を指します。検索エンジンによるページの発見や、広告配信時のページ確認など、自動アクセスにはさまざまな用途があります。
たとえば、店舗が営業時間や商品の案内をウェブサイトに掲載している場合、そのページを検索サービスが巡回すれば、利用者が店を見つけやすくなることがあります。一方で、どの情報が何のために取得され、どの期間保持され、別の目的に使われるかは、個々のサービスや契約によって異なります。
ここで注意したいのは、ページを取得することと、その情報でAIモデルを学習させることは別の工程だという点です。自動アクセスの存在だけから、学習の実施、モデルへの取り込み、出力への再現までを推定することはできません。同様に、規約上の許可に関する文言だけから、特定のページが実際に取得された事実を証明することもできません。
ニュースを読む際は、「規約にどんな利用が書かれているか」「事業者が実際にどう運用すると説明しているか」「独立した証拠で何が確認されたか」を分けて考えると、見出しだけで判断しにくい論点が整理できます。
AI学習との関係で確認したい三つの論点
1. 規約上の利用目的
契約文書には、情報を収集する行為と、収集した情報の利用目的が別々に書かれることがあります。自動アクセスを許可する文言だけでなく、その後に続く利用目的、関連する別規約、定義の範囲を確認しましょう。
今回の報道では、修正前の文言にあった「train」が削除されました。それでも法律専門家は、修正後の「開発」などにAI関連の利用が含まれると解釈され得ると懸念しています。これは専門家の解釈であり、Metaがその利用を行ったという認定ではありません。
2. 実際に収集される情報
規約に広い可能性が書かれていても、個々のURLが実際にアクセスされるか、本文や画像のどの部分が取得されるかは別の問題です。アクセスログに記録される場合もありますが、ログだけでは取得後の利用目的まですべて分かるとは限りません。
また、サイトに掲載する写真や文章には、自分が著作権を持つものと、第三者から許諾を得て使っているものが混在することがあります。自分が運営するページであっても、掲載素材の権利関係は一律ではありません。第三者素材の利用契約で再利用に関する条件が設けられている場合もあるため、必要に応じて確認が必要です。
3. 法的な評価
規約の意味、同意の成立、著作権や個人情報に関する扱いは、契約の内容、事実関係、適用される法域などで変わり得ます。報道に登場する米国の専門家の見解を、そのまま日本の個別案件に当てはめることはできません。
この記事は一般的な情報整理であり、個別の法律相談ではありません。取引先との契約、顧客情報、第三者の権利などに影響がありそうな場合は、実際の規約と契約書、サイトの構成を持参し、対応する法域に詳しい弁護士などに相談してください。
robots.txtで何ができる?限界も知っておこう
robots.txtは、サイトにアクセスする自動プログラムに対し、巡回に関する希望を伝えるためのファイルです。検索エンジンなどがこれを参照し、対象範囲の判断に使うことがあります。Metaも報道の中で、コンテンツの所有者はrobots.txtを使ってアクセスに関する設定を管理できると説明しています。
ただし、robots.txtは情報を暗号化する仕組みでも、パスワードを要求する仕組みでもありません。記載を守らないプログラムのアクセスを、それだけで物理的に止められるわけではありません。さらに、規約とrobots.txtの関係については、Metaの説明と取材を受けた専門家の見解が一致していません。
そのため、robots.txtを設定したからすべての収集や利用を確実に防げる、とは言えません。逆に、robots.txtの有無だけで契約上の権利義務が決まると断定することもできません。設定は運用上の一つの手段として扱い、規約、技術的な公開範囲、必要な法的確認と併せて検討しましょう。
閲覧を制限したい情報は、そもそも公開ページに置かないことが基本です。認証が必要な領域、管理画面、顧客向けの資料などは、適切なアクセス制御を設け、意図せず公開されていないか確認します。robots.txtに秘密のURLを書けば安全になるわけではなく、設定内容が誰でも読めることにも注意が必要です。
ブログ・事業サイトの運営者が確認する順番
対応を急ぐ前に、自分の利用形態と公開情報を棚卸しすると、必要な確認先を絞りやすくなります。次の順番は一般的な整理方法であり、特定の設定変更や契約解除を勧めるものではありません。
まずアカウントと適用規約を特定する
Facebookページ、Instagramの事業用アカウント、広告管理ツール、WhatsAppの事業利用など、組織が使っているサービスを一覧にします。担当者個人のアカウントと組織の事業用アカウントが混在していないか、管理者権限が誰にあるかも確認しましょう。
そのうえで、各サービスの管理画面や公式の通知から、適用される規約、更新日、適用開始予定日、対象地域を確認します。Nieman Labが伝えた10月30日は報道時点の予定であり、その後の変更や自分の契約における適用条件まで保証するものではありません。確認した日時と文書の版を記録しておくと、後で変更を追いやすくなります。
関連するサイトと公開内容を整理する
アカウントに登録されたURL、広告の遷移先、商品ページ、外部予約サイト、複数ドメインの関係を確認します。事業部ごとに異なるサイトを管理している場合や、制作会社が管理するページがある場合は、担当者に確認して情報を集めましょう。
ページ内の文章、写真、動画、利用者の投稿、取引先が提供した資料なども分類します。特に第三者から利用を許された素材については、掲載目的や再利用に関する条件を確認してください。分類は、今回の規約にその素材が必ず含まれるという意味ではなく、自分たちが管理する情報と契約上の責任を把握するための作業です。
公開設定とアクセス制御を見直す
一般公開する必要のない資料、個人情報、社内用のページが公開状態になっていないか確認します。アクセス制限を設ける場合は、検索結果や既存の共有リンクへの影響、正当な利用者の業務への影響も考慮します。
robots.txtを変更する場合、必要な検索エンジンやサービスのアクセスを意図せず妨げる可能性があります。設定前に現在の内容を保存し、サイト管理者や制作会社と影響を確認してください。安全性は一つのファイルだけで確保できるものではなく、認証、公開範囲、権限管理、定期的な点検を組み合わせることが大切です。
疑問は担当窓口と専門家に具体的に聞く
問い合わせる際には、アカウントの種類、問題となる規約の版、対象サイト、気になる利用目的を整理します。「AIに使われますか」という広い問いだけでなく、対象となるURLの範囲、robots.txtの扱い、収集した情報の利用目的、設定や異議申し立ての手段などを分けて尋ねると、回答を比較しやすくなります。
回答が得られた場合は、日時、担当窓口、質問内容、回答の適用範囲を保存します。窓口の説明と契約文書の関係に疑問が残る場合や、事業上の影響が大きい場合は、個別事情を踏まえた専門家の助言を受けましょう。
個人ブログにも関係する?
個人で日記を書いているだけの人と、広告や事業用アカウントを使ってサイトを運営する人では、適用される条件が同じとは限りません。今回取り上げたのは商用規約に関する報道であり、すべての個人ブログが一律に対象になるとする根拠はありません。
一方、個人名義でも、商品販売、広告、仕事の受注などにSNSの事業用機能を使っている場合は、自分では「個人ブログ」と考えていても、特定の商用規約が適用される可能性があります。サービスの名称や見た目だけで判断せず、登録情報と実際の利用機能を確認してください。
SNSへの投稿と、自分が管理する外部サイトも分けて考えましょう。SNS内で公開した文章や写真には、投稿先の利用規約やプライバシーに関する規定が関係することがあります。外部サイトには別の契約やアクセス設定があり、双方の扱いを同じだと決めつけることはできません。
著作権や個人情報で気をつけたいこと
サイトの文章や写真を扱うときは、著作権者が誰か、どの範囲の利用を許諾されているか、契約でどのような条件を負っているかを確認します。自分で制作した素材、外部ライターの原稿、素材サイトの画像、取引先から提供されたロゴなどでは、確認すべき契約が異なります。
顧客の氏名、連絡先、購入履歴などを扱う場合は、そもそも一般公開が必要かを見直してください。アクセス解析や外部サービスへの連携を含め、どの情報がどこに送られるかを把握することも大切です。プライバシーポリシーの記載だけを見て、実際のデータの流れを確認しないまま安心することはできません。
収集やAI利用が合法かどうかは、公開されていることだけ、あるいは規約の一文だけで決まるとは限りません。日本と海外では制度や判断枠組みも異なります。具体的な対応は、契約文書、データの種類、利用目的、関係する国や地域を踏まえ、必要に応じて専門家に確認してください。
規約の読み方で押さえたいポイント
長い規約を読むときは、まず「誰が」「何に」「どのような行為を」「何の目的で」行えると書かれているかに印を付けます。次に、対象となるサイトや情報がどのように定義されているか、例外や別規約への参照があるかを確認します。
続いて、変更の通知方法と適用開始日、利用継続と同意の関係、サービスを使わない場合の選択肢を確認しましょう。これらはサービスの種類や契約によって異なります。画面の短い通知だけでなく、リンク先の全文や関連規約を見ることが重要です。
Nieman Labは、報道時点で新しい規約に対する事前のオプトアウトの選択肢がないと伝えています。ただし、設定や提供条件は変わる可能性があります。自分のアカウントに現在どの選択肢があるかは、最新の管理画面と公式案内で確認してください。
よくある疑問
自分のサイトはすでにAI学習に使われましたか?
今回の報道だけでは、個々のサイトが取得されたか、AI学習に使われたかは分かりません。規約の文言と実際の処理には違いがあります。具体的な利用状況は、事業者の説明や利用可能な記録を確認し、必要に応じて問い合わせてください。
「train」の削除で問題はすべて解決しましたか?
削除は修正内容の一つですが、専門家は残った利用目的の範囲について懸念を示しています。Metaは条項の明確化だと説明しており、見解には違いがあります。削除だけで影響がなくなったと断定するのは適切ではありません。
robots.txtを書けばアクセスは完全に止まりますか?
robots.txtは巡回に関する指示を伝える仕組みで、認証や暗号化ではありません。従う事業者もいますが、すべてのアクセスを技術的に遮断する保証はありません。非公開情報には適切なアクセス制御を用いましょう。
すぐに事業用アカウントを削除すべきですか?
一律の答えはありません。事業上の集客、顧客対応、広告運用への影響と、契約や情報管理上の懸念を併せて検討する必要があります。まず適用規約と実際の選択肢を確認し、影響が大きい場合は社内の責任者や専門家と相談してください。
まとめ:規約・運用・証拠を分けて確認する
Metaの商用規約をめぐる今回の論点は、サイト情報への自動アクセスと、その後の利用目的をどこまで認めるのかという点にあります。報道によると、Metaは「train」という語を削除し、広告・ビジネス製品に関する説明を明確にしました。一方、専門家は残る表現の広さを懸念しており、実際の利用や法的評価を一つの見出しだけで決めることはできません。
サイト運営者が今できることは、利用中の事業用アカウントと関連サイトを把握し、適用される最新の規約と公開設定を確認することです。そのうえで、不明点を窓口に尋ね、権利関係や事業への影響が大きい場合には専門家へ相談しましょう。便利なサービスを活用しながら、どの情報を公開し、どの条件で利用を認めるのかを自分たちで確認していくことが大切です。
参考資料
- Nieman Lab:修正後の商用規約に関する専門家の見解(2026年10月17日、米東部時間)
- Nieman Lab:当初の商用規約に関する報道(2026年10月15日)
- Meta商用規約
- Google検索セントラル:robots.txtの概要
※この記事は2026年10月19日時点の公開情報に基づく一般的な解説です。規約やサービスの提供条件は変更されることがあります。個別の法律判断は専門家にご相談ください。