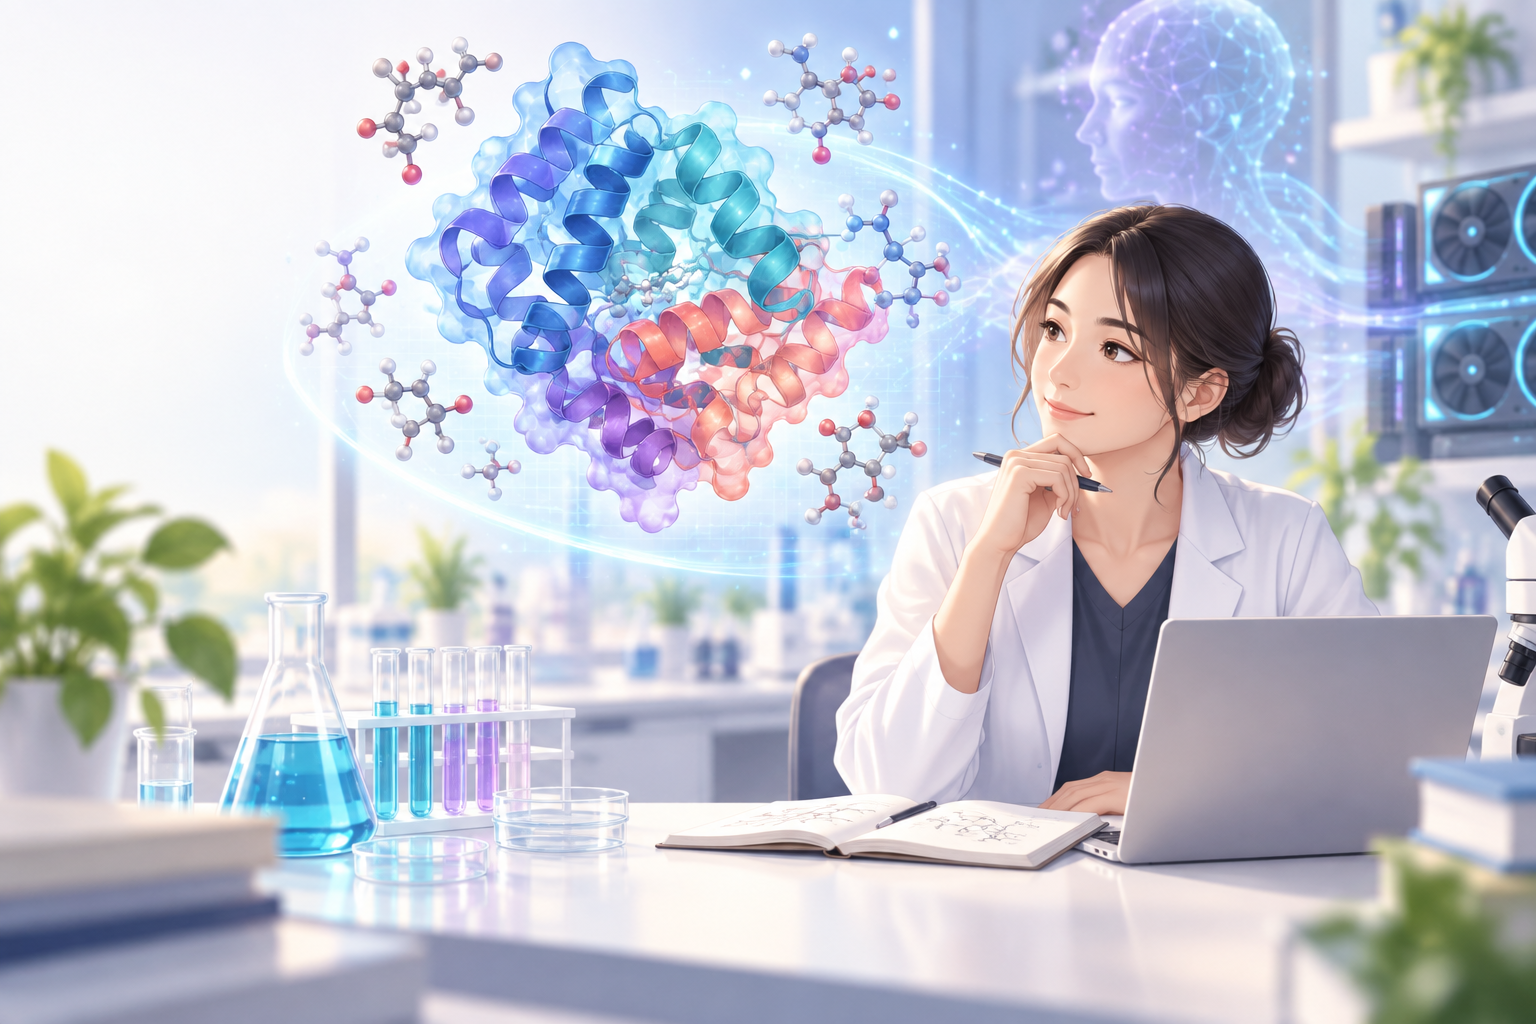
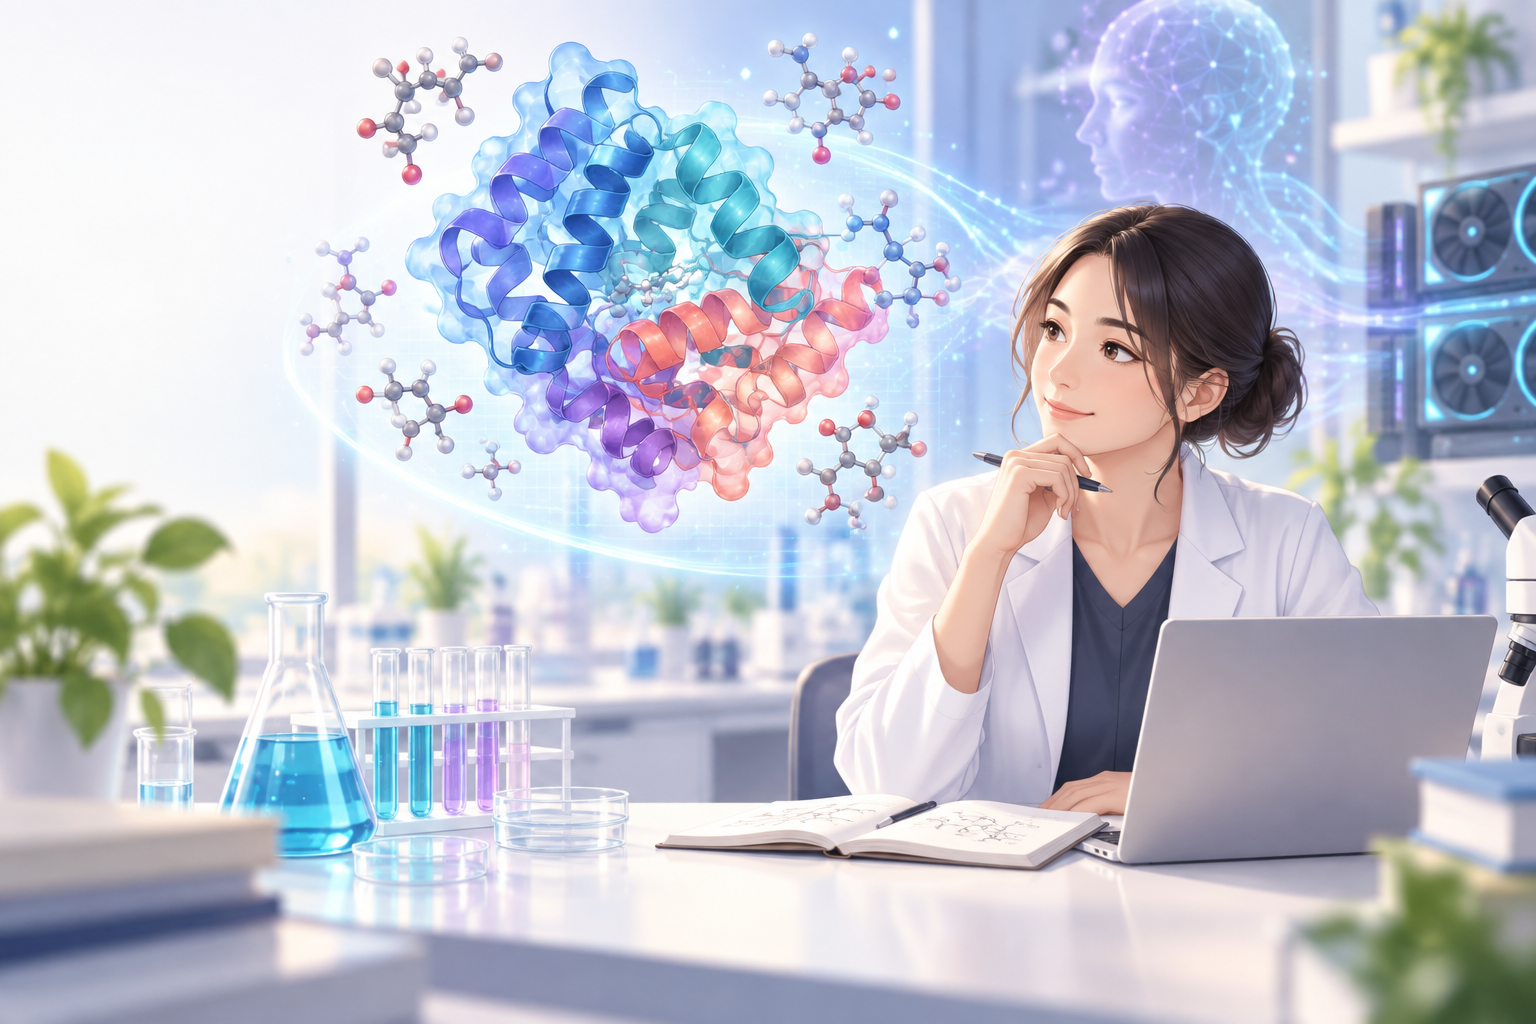
2026年9月17日、Anthropicは、Claudeを使ってオープンソースの生体分子モデリング用ソフトを最適化し、研究計算を高速かつ省メモリにした取り組みを公表しました。発表によると、30種類を超える生物学モデルを約4週間で最適化し、平均ではおよそ4倍の高速化を報告しています。タンパク質の構造予測や設計、ゲノム解析などに使われる計算は、分子が大きくなるほど必要な時間とメモリが急増します。そこで計算の「中身」を効率化することは、研究者が扱える問題の幅を広げる可能性があります。
ただし、ここで急いで結論づけてはいけません。速くなった計算は、薬が効くこと、安全であること、患者に使えることを示すものではありません。AIが候補を出し、研究ソフトが予測を返し、実験室で測り、専門家がデータを点検する。医療や創薬のように人の健康と生活に深く関わる領域では、このつながり全体を丁寧に保つことが重要です。
この記事では、今回の発表で何が高速化されたのか、研究の現場でどんな可能性があるのか、そして一般の読者や企業が見落としたくない確認点を整理します。
Anthropicが発表した「生体分子モデリングの高速化」とは
今回の中心は、AIが新しい薬そのものを発見した、という発表ではありません。すでに研究者が利用しているオープンソースの深層学習モデルを、より速く、より少ない計算資源で動かすためのソフトウェア最適化です。対象には、タンパク質の立体構造予測、タンパク質設計、ゲノム解析、タンパク質言語モデルなどが含まれます。
タンパク質は、アミノ酸が長くつながった分子です。体内で働くときの形や、ほかの分子との結びつき方を調べることは、病気の仕組みを理解したり、治療につながる分子を考えたりする出発点になります。ところが、形を扱う計算はとても重くなりがちです。発表では、分子間の幾何学的な関係を捉える「triangle attention」や「triangle multiplication」と呼ばれる処理が、時間とメモリを大きく消費すると説明されています。扱う系が2倍になれば、単純には8倍ほどの計算量・メモリが必要になる性質があるためです。
Anthropicは、こうした処理を効率化するカスタムカーネル群「FlashPairformer」を開発したとしています。カーネルとは、GPUのような計算装置で処理を速く動かすための低水準のプログラムです。研究者が毎回アルゴリズムを変えなくても、基盤となる処理が改善されれば、同じモデルをより現実的な時間とコストで試せることがあります。
発表には二種類の数字が示されています。一つは、精度のわずかな変化を許容した場合の平均約4倍の高速化です。もう一つは、出力を同一に保った条件での約2倍の高速化です。この違いは大切です。速度だけを比べると華やかに見えますが、研究では「どの条件で、どの程度、結果が変わったのか」を一緒に読む必要があります。モデルごとのデータ、評価指標、ハードウェア、再現手順を見て初めて、数字が自分の研究にどこまで当てはまるかを判断できます。
なぜ計算の速さと省メモリが研究の幅を左右するのか
生体分子の研究では、良いアイデアがあっても、計算待ちが長すぎると試行の回数が限られます。ある条件を変えたときに構造予測がどう変わるか、候補分子を何通り比較できるか、複数の手法で結果が一致するか。こうした確認は、研究の確からしさを高めるために必要ですが、計算資源が不足すると後回しになりやすい部分です。
高速化の第一の価値は、候補を増やせることではなく、比較と再確認に時間を回せる可能性があることです。たとえば一つのモデルだけで良い結果が出た場合、別のモデルや別の設定でも似た傾向が出るかを確かめる必要があります。高速化によってこの検証を省略してよいわけではありません。むしろ、余った計算時間を再現性の確認へ使えるなら、研究の質にとって望ましい使い方になります。
第二に、メモリ使用量が下がると、これまで大規模な計算環境が必要だった課題に取り組みやすくなる可能性があります。Anthropicは、1台のNVIDIA GPUノードで、1万トークンを超える生体分子系を扱える低メモリモードにも言及しています。ここでいうトークンは文章の単語数ではなく、アミノ酸や核酸、小分子、イオンなど、モデルが分子系を表すための要素です。大きな複合体を扱えることは、現実の生物学的な系へ近づく一歩になり得ます。
ただし、「大きな系を扱える」ことと「現実を正確に再現できる」ことは同義ではありません。データの偏り、学習時に見ていない分子、実験条件の違い、細胞内の複雑な環境など、予測の外側には多くの要因があります。計算が速くなったときほど、どの問いに答えられ、どの問いにはまだ答えられないのかを明確にする必要があります。
AIは研究者の代わりに結論を出すのではなく、試行錯誤を支える
今回の事例で注目したいのは、AIが研究の対象そのものだけでなく、研究に使うソフトウェアの改善にも使われている点です。AIは、コードを読み、繰り返し計算されている部分を見つけ、不要な分岐を整理し、より効率的な実装案を提案できます。これは研究者が長年行ってきた性能改善の仕事を不要にするものではなく、探索の速度を上げる補助になり得ます。
一方で、AIが提案した最適化コードにもバグや、特定条件だけで起こる精度低下が入り込む可能性があります。速さの比較では良く見えても、数値の丸め方が変わったり、まれな入力で破綻したりすれば、研究結果の解釈に影響します。そのため、コードレビュー、テスト、既知のベンチマーク、独立した再実行は欠かせません。公開コードがあることは検証の入口を広げますが、公開されているだけで正しさが自動的に保証されるわけではありません。
AIを使う研究では、「AIが出した答え」ではなく、「どんなデータと手順で、誰が、どこまで確かめた結果か」を共有する姿勢が重要です。特に企業が研究成果を外部へ説明するときは、速度向上の数字だけでなく、評価条件、精度への影響、失敗したケース、実験での確認範囲を区別して伝えることが信頼につながります。
創薬に期待が集まる理由と、計算だけでは越えられない段階
タンパク質の構造予測や分子設計は、創薬研究と関係が深い技術です。病気に関わる標的を調べ、結合しそうな候補を考え、実験で絞り込む。その初期段階を効率化できれば、研究者が検討する選択肢を増やせるかもしれません。今回の発表も、こうした研究基盤を軽くする取り組みとして理解できます。
しかし、コンピュータ上で有望に見えた候補が、そのまま医薬品になるわけではありません。分子が標的に結合するか、細胞や動物でどのように働くか、望ましくない作用がないか、体内で十分な濃度を保てるか、製造できるかなど、多くの段階があります。人を対象とする試験では、倫理、同意、設計、監視が必要です。日本で医薬品として承認されるには、品質・有効性・安全性に関する審査も関わります。
このため、AIによる分子予測を見たときには、「治療法が完成した」という印象だけで受け取らないことが大切です。今回の発表は計算ソフトの性能改善です。個別の病気に効く薬を実証した発表ではありません。研究の初期工程を速くする可能性と、臨床で使える医薬品になるまでの距離は、はっきり分けて考えるべきです。
医療情報として受け取る場合も、SNSの短い投稿や企業発表だけで治療を変更しないでください。診断、服薬、受診、健康上の判断は、主治医や薬剤師などの専門職に相談し、公的機関や学会の情報を確認することが基本です。研究ニュースは希望や理解のきっかけになっても、個人への医療助言にはなりません。
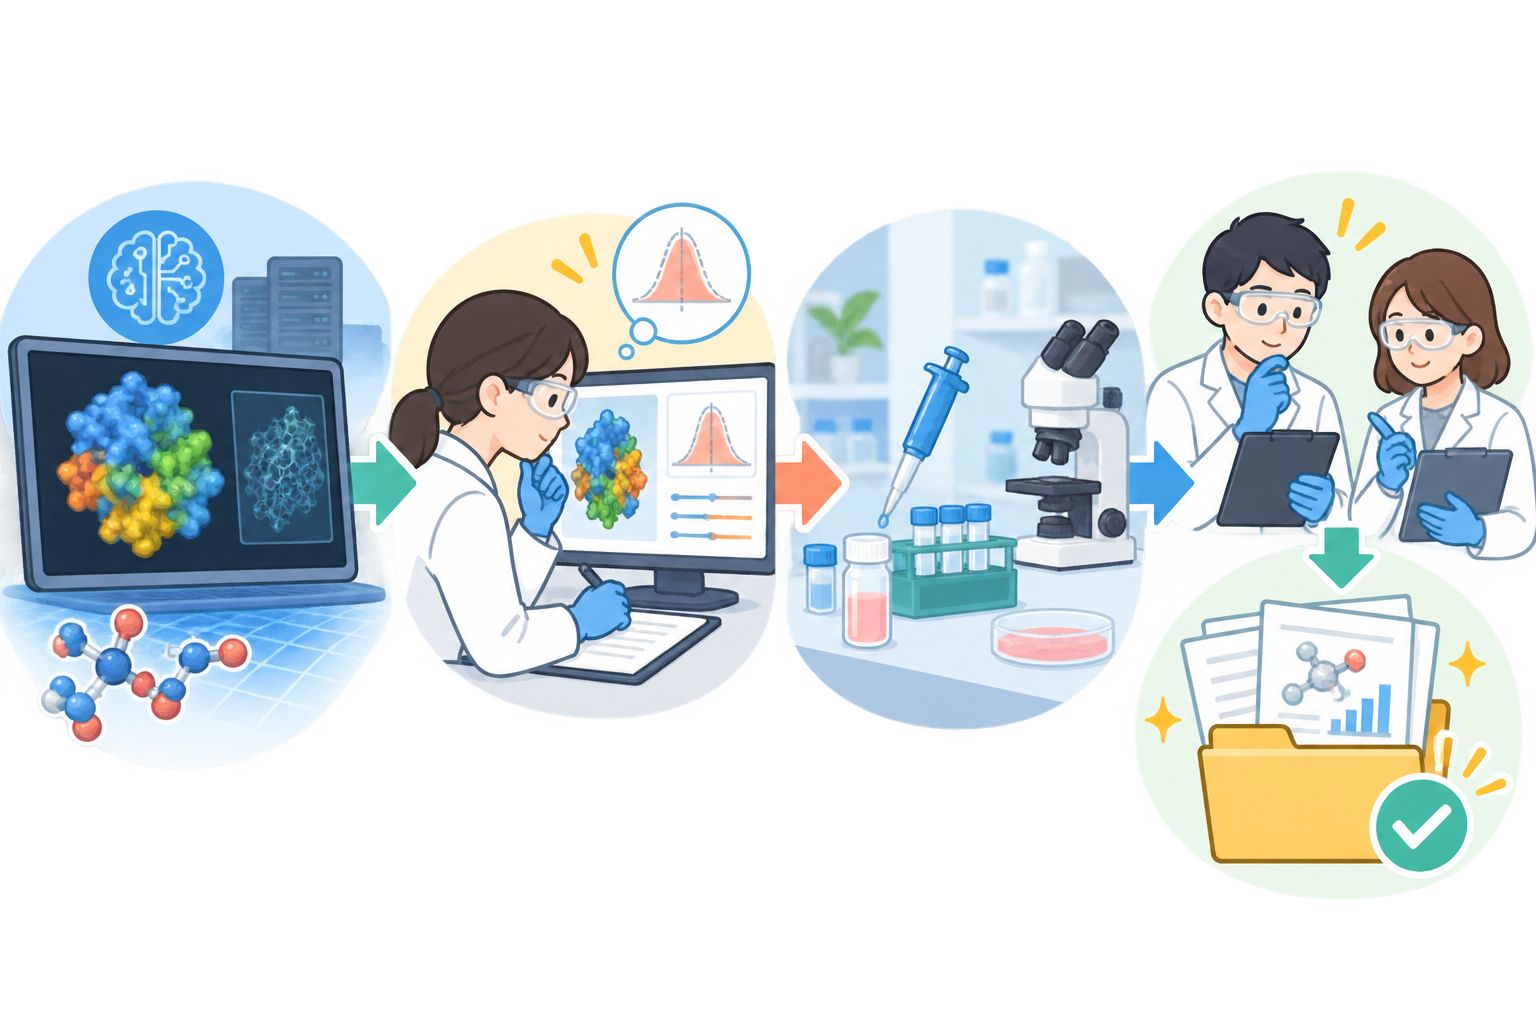
研究成果を読むときの4つの確認ポイント
1. 何が改善されたのかを分けて読む
モデルの精度、推論速度、メモリ使用量、扱える分子の大きさ、研究全体の成功率は、別々の指標です。今回のような最適化の発表では、主に速度とメモリ効率が対象です。「速くなった」という一文から、発見の精度や臨床上の有効性まで一足飛びに推測しないようにしましょう。出力を完全に一致させた条件か、精度の変化を許容した条件かも重要です。
2. 比較条件と再現性を確かめる
どのモデルを、どのGPUで、どのデータで、何回実行したのか。比較対象は何か。第三者が同じ環境で追試できるか。こうした情報は、専門家だけの細かな話ではありません。研究発表の信頼性を考える基礎です。Anthropicは最適化コードを公開するとしていますが、利用者側も導入前に自分のデータと環境で評価し、変更履歴と結果を記録する必要があります。
3. 実験による確認がどこまであるかを見極める
計算機上の評価を「in silico」、細胞や試験管などでの評価を「in vitro」、動物を使う評価を「in vivo」と呼ぶことがあります。どの段階の結果なのかで、意味合いは大きく変わります。今回の発表には、設計コンペで5,000超のデザインについてウェットラボ検証を支援する計画も記されています。これは計算だけで完結させず、実測との照合を重視する方向として読むことができます。ただし、今後の検証結果は現時点で確定していません。
4. 誰が責任を持ち、問題が起きたらどうするかを見る
研究用ツールでも、誤った予測が実験計画や投資判断、広報に影響することがあります。研究室や企業は、利用範囲、レビュー担当、異常値を見つけた場合の停止基準、データの扱い、外部公開前の確認手順を決めておくとよいでしょう。NISTのAIリスク管理の考え方も、技術を一度評価して終わりではなく、文脈に応じて継続的に管理する重要性を示しています。
研究室・企業が導入前に整えたい実務の流れ
AIによる最適化コードや生体分子モデルを導入するなら、最初から大きな研究判断に使うのではなく、小さな検証から始めるのが現実的です。まず、用途を具体化します。候補分子の優先順位づけなのか、既存モデルの推論時間削減なのか、教育・探索用なのかで、許容できる誤差や必要な証拠は変わります。
次に、導入前の基準を残します。従来の実装でかかる時間、使うメモリ、代表的な入力に対する出力、既知の失敗例を記録します。その後、新しい実装を同じ条件で動かし、速度だけでなく出力差、例外、再現性を比較します。性能が良くても、理由の分からない差異が出る場合は、いったん利用範囲を限定し、原因を調べるべきです。
さらに、研究データの権利と機密性にも注意が必要です。患者由来データ、共同研究の未公表データ、契約で利用範囲が決められたデータを外部サービスへ入力する場合、法令や契約、倫理審査、組織の規程を先に確認してください。モデルの性能改善と、データを預けてよいかどうかは別の判断です。匿名化したつもりでも再識別の懸念が残る場合があり、技術担当だけで決めないほうが安全です。
最後に、重要な結論には人のレビューを置きます。AIの候補は、研究者が確かめるべき問いを増やすために使えます。一方、医療、薬事、患者への説明、投資家への見通し、採用や資金配分など、影響の大きい判断をAIの出力だけで決めることは避けるべきです。分野の専門家、品質保証、法務・知財、倫理・個人情報の担当者が必要に応じて関わる設計が求められます。
これから注目したいのは「速さ」よりも検証可能な研究の広がり
Claudeを用いた生体分子モデリングの最適化は、AIが科学研究の周辺作業ではなく、研究基盤そのものを改善し始めていることを示すニュースです。計算時間とメモリの制約が下がれば、より多くの研究グループが比較、追試、探索に参加できる可能性があります。公開コードと実験検証の仕組みがうまく組み合わされれば、成果を特定の組織の中に閉じず、検証の輪を広げる助けにもなります。
その一方で、AIの提案が速く出るほど、人間側の確認が重要になります。計算上の候補を実験で確かめること。速度と精度を混同しないこと。データの扱いと責任の所在を明確にすること。医療や薬の話では、個別の健康判断を専門職と公的情報に結びつけること。この基本を守ることで、AIは「もっともらしい答えを急ぐ道具」ではなく、「より良い問いと検証を支える道具」になり得ます。
今回の発表を読む際は、平均約4倍という数字だけでなく、同一出力時には約2倍という条件の違い、公開されるコード、そしてこれから行われる実験検証にも目を向けてみてください。AIと計算資源の進歩を、研究の信頼性と社会への説明責任につなげられるかどうかが、次の焦点になりそうです。
よくある疑問:AIが速くすれば研究は自動化されるのか
「AIがコードを最適化し、分子を予測できるなら、研究者は不要になるのではないか」と感じるかもしれません。しかし実際の研究には、問いの立て方、先行研究との照合、測定法の選択、結果が意外だったときの解釈、倫理上の配慮、共同研究者との議論など、単純な計算に還元できない仕事が数多くあります。モデルは入力された条件の範囲で出力しますが、何を入力し、どの結果を重要と見なすかには専門知識と責任が伴います。
とくに生体分子の研究では、実験の失敗も重要な情報です。予測通りに結合しなかった、細胞では働かなかった、測定が再現しなかった、といった結果から、仮説や方法を見直します。AIは過去のパターンを基に候補や改善案を広げることはできますが、未知の現象を前にして何を疑い、次にどんな実験を設計するかは、研究チームの判断に支えられます。
また、最適化によって計算が速くなると、出力の量が増える場合があります。候補が増えれば選択肢は広がりますが、評価する人の時間が増えなければ、確認し切れない候補が積み上がるおそれもあります。そのため現場では、優先順位の基準、レビューの担当、根拠データの保存、外れ値の扱いをあらかじめ決めることが大切です。「たくさん出せる」ことを成果にせず、「どのように絞り、確かめ、説明できるか」を設計する必要があります。
一般の読者が研究ニュースと付き合うために
AIと医療・生命科学のニュースは、期待と不安の両方を呼びやすい分野です。読み手は、見出しにある「発見」「高速化」「設計」という言葉を見たら、次の三点を確認すると理解しやすくなります。第一に、対象は研究用の計算なのか、細胞・動物での実験なのか、人を対象とした臨床試験なのか。第二に、発表者自身の評価だけでなく、論文、技術報告、公開コード、外部の検証はあるのか。第三に、結果の限界や条件が説明されているかです。
今回の記事のテーマでいえば、Anthropicが示したのは主として研究ソフトの高速化です。そこから「新薬が完成した」「特定の病気が治る」と読むのは行き過ぎです。一方で、研究で必要な比較や探索にかかる負担を下げ、実験に進む前の候補選びを助ける可能性はあります。この二つを同時に理解することが、ニュースを過大評価も過小評価もしないための土台になります。
企業の広報や投資に関する情報を見る場合も同じです。技術の進歩は将来の収益や開発期間を必ずしも保証しません。個別企業の株式、治療、保険、契約に関する判断は、AI関連ニュースだけを根拠にせず、公式資料や専門家に確認し、自分の状況に合った情報を集めてください。期待を持つことと、根拠を確認することは両立します。