新しい生成AIモデルの発表を見て、「今使っている仕組みより速いらしい」「単価が変わらないなら入れ替えてもよいのでは」と考える場面は増えました。2026年9月28日、AnthropicはClaude Sonnet 5.5を発表しました。新モデルの登場は、文章作成、情報整理、コード作成、顧客対応の下書きなどを見直すよい機会です。
ただし、モデル名、ベンチマーク、料金表だけで業務利用の可否を決めると、導入後に「期待した品質が出ない」「利用量が読めず予算がぶれる」「本来見せるべきでない情報を扱ってしまった」といった問題が起こり得ます。AIは同じ質問でも入力の条件や周辺の仕組みによって振る舞いが変わります。仕事の成果は、モデルそのものだけではなく、与える情報、指示文、ツール連携、確認する人、運用ルールの組み合わせで決まります。
この記事では、Claude Sonnet 5.5の発表を入口に、業務AIを比較するときの実務的な確認順を整理します。特定のサービスへの切り替えや、個別の契約・購入を勧めるものではありません。公開情報をもとに、導入候補を落ち着いて比べるための観点を示します。料金や提供条件、利用できる機能は変更されるため、実際の契約前には必ず提供元の最新の公式ページと、自社の情報管理・法務・調達のルールを確認してください。
Claude Sonnet 5.5のニュースで、まず切り分けたいこと
Anthropicの公式ドキュメントでは、Claude Sonnet 5.5は「速度と知性の組み合わせ」を特徴として掲載されています。料金ページでは、APIの基本料金が入力100万トークン当たり2米ドル、出力100万トークン当たり10米ドルと案内されています。ここでいうトークンは文字数と一対一ではなく、言語や文章の内容によって変わる処理単位です。日本語の利用量を予算へ当てはめるときは、文字数だけから単純に推定しないほうが安全です。
一方で、公開された料金は比較の出発点です。実際の請求額には、入力・出力の比率、会話履歴の長さ、ツール定義、キャッシュ、バッチ処理、地域や接続先、失敗した再試行などが関係します。あるモデルの入力単価が低くても、より長い出力や追加の確認ループを必要とすれば、案件全体のコストが下がるとは限りません。逆に、単価が高く見えても、レビュー時間や手戻りが減るケースはあり得ます。
また、「新しい」「高性能」という表現と、「あなたの仕事で十分な正確さを出せる」は別の主張です。公開ベンチマークは、モデルの特性を知る手掛かりになりますが、データの作り方、評価基準、与えられた前提、採点方法を含みます。社内文書の要約、定型メールの下書き、障害一次対応の整理、コードレビュー補助など、実際に任せたい仕事と同じ条件ではないことが珍しくありません。
最初に次の三つを分けてメモすると、ニュースの読み違いを減らせます。
- 提供元が公式に説明している機能、料金、利用条件は何か
- 自社が試して確かめたい仕事と、許容できない失敗は何か
- 試験で測れた結果と、まだ確かめていない前提は何か
この区別がないまま比較表を作ると、公式発表、営業上の期待、社内の仮説が一つの「性能」欄に混ざります。意思決定のための表では、出典と確認日を各項目に残すだけでも、後で議論しやすくなります。
確認項目1:モデル名ではなく、任せる「仕事の単位」を決める
AI導入の比較は、「何でもできるアシスタントが欲しい」から始めるより、繰り返し発生する小さな仕事を一つ選ぶほうが測りやすくなります。たとえば、会議メモから決定事項を抽出する、問い合わせ文を分類する、既存の文章を指定の形式へ整える、テストケースのたたき台を作る、といった単位です。最初の対象は、誤りがあっても人が短時間で見つけられ、外部への影響が小さいものが向いています。
候補の仕事を選ぶときは、入力、出力、完了条件を紙に書き出します。入力は、どの種類の文書を何件渡すのか。出力は、箇条書きなのか表なのか、下書きなのか。完了条件は、担当者が何分で確認できればよいのか、どの誤りを許容しないのかです。ここが曖昧なまま「回答が良いか」を尋ねても、試す人によって評価が割れます。
特に、契約、採用、与信、医療、保険、法律、投資、支払い、本人確認など、個人の権利やお金、安全に影響する場面は慎重さが必要です。AIの出力を根拠に自動で可否を決めたり、個別の助言として送ったりする運用は、単純な文章生成より大きなリスクを伴います。このような用途では、専門家の確認、根拠資料の照合、異議申立てや人による見直しの経路、記録の保全を含めて設計してください。モデルを替えるだけで、その責任が小さくなるわけではありません。
業務を分けるときの問いは、次のように具体的にできます。
1. どの部署が、どの頻度で行う仕事か。
2. 正しい出力の見本はあるか。なければ誰が基準を決めるか。
3. 間違えた場合、誰にどんな影響があるか。
4. AIの下書きを、誰がどの画面で確認してから使うか。
5. 入力として渡してよい情報と、渡してはいけない情報は何か。
この五つに答えられる仕事は、モデルを横並びで試しやすい対象です。反対に、目的が広すぎる案件や、成果の良し悪しを誰も判断できない案件は、先に業務設計を整える必要があります。
確認項目2:品質は「代表例」と「失敗例」の両方で測る
試験用のデータを用意するとき、きれいで簡単な例だけを集めると、実運用の難しさが見えません。日付が欠けた議事録、略語が多い問い合わせ、複数の話題が混ざった依頼、曖昧な指示、長い添付資料など、現場で起こりやすい例を少量ずつ含めます。ただし、試験のために実在の顧客情報、健康情報、口座情報、個人を特定できる情報、未公開の機密情報を安易に持ち出してはいけません。匿名化・マスキングした例、または利用許可と社内ルールを確認済みの安全な検証環境を使います。
評価表では、単なる「良い/悪い」だけでなく、誤りの種類を分けます。要約なら、重要事項の抜け落ち、事実と異なる追加、数値・固有名詞の取り違え、指定した形式からの逸脱を別々に記録します。コード支援なら、動作するかだけでなく、依存関係の追加、権限の扱い、例外処理、テストの有無、保守しやすさを見ます。問い合わせの下書きなら、敬語、条件の確認、約束してはいけない表現、エスカレーションの要否を確認します。
大切なのは、最も印象的な成功例ではなく、失敗がどの条件で起きたかを知ることです。たとえば、短い日本語の要約は安定していても、表形式の資料を混ぜると項目が抜けるかもしれません。一般的な説明は滑らかでも、社内固有の規程について根拠のない補完をするかもしれません。モデルの回答が自信ありげに見えることと、内容が正しいことも別です。
同じ評価セットを、現在の仕組みと候補モデルで実行し、依頼文と設定を保存します。可能なら、人が作った基準回答と比べ、複数人で一部を採点します。最初は20件から50件程度の小さなセットでも、用途がはっきりしていれば有用です。件数を増やす前に、失敗の種類を見つけ、指示文、前処理、確認画面を改善するほうが、早く実務に近づく場合があります。
「正答率が何%なら導入」と一つの数字に固定する必要はありません。誤りの重大さが異なるからです。文末の言い換えは人が直せても、金額、期限、個人情報、契約条件を誤ると扱いは変わります。重大な誤りを0件にできない前提で、検出方法と停止条件を先に定めることが重要です。
確認項目3:料金はトークン単価ではなく、1件当たりの総コストで見る
料金表を読む際は、入力と出力を分けて考えます。長い資料を毎回渡す作業では入力が増えます。対話を重ねて詳細な提案書を作る作業では出力が増えることがあります。画像、ファイル、外部ツール、検索、キャッシュなどを組み合わせる場合は、それぞれの料金・制限・データの流れも確認対象です。公式料金ページは更新され得るため、見積もりに使う数値には必ず取得日を添えましょう。
試算では、月間トークン数をいきなり正確に当てようとするより、代表的な処理を数十件動かし、実測値から幅を持たせる方法が実用的です。例えば、1件当たりの平均入力、平均出力、失敗時の再実行回数、人の確認時間を記録します。そこへ想定件数を掛け、通常月・繁忙月・想定外に会話が長くなった月の三通りを置くと、予算の議論がしやすくなります。
比較に含めたいのはAPI利用料だけではありません。
- プロンプトや評価セットを整備する担当者の時間
- 出力を確認・修正する担当者の時間
- 既存システムとの連携、ログ保存、アクセス制御の費用
- 障害時や仕様変更時に切り戻すための運用負荷
- 利用者向けの研修、利用ガイド、相談窓口の整備
キャッシュやバッチ処理は、使い方によって費用を下げられる仕組みですが、条件を読まずに「必ず安くなる」とは言えません。Anthropicの料金ドキュメントでは、プロンプトキャッシュについて書き込みと読み出しで異なる倍率が示され、バッチ処理には標準料金からの割引が案内されています。繰り返し使う大きな指示文や、即時性を求めない大量処理には検討の余地があります。一方、キャッシュの有効期間、再利用される入力の範囲、ジョブ完了までの時間、失敗時の扱いが自社の仕事に合うかを確認してください。
単価の比較表は便利ですが、結論欄を「最安」だけにしないほうがよいでしょう。「代表タスク1件にかかる費用」「レビューを含む完了時間」「重大な誤りの件数」「利用条件の変更を追える担当者がいるか」を並べると、費用と品質を同じ画面で話せます。
確認項目4:閲覧・実行・承認の権限を一緒に見直す
モデルを新しくするときは、モデルの能力より先に、周辺の権限が広がっていないかを確認します。文章を生成するだけの試験と、社内ストレージを検索する、顧客管理システムを読む、メールを送る、チケットを更新する、発注を実行するといった連携では、影響の大きさが異なります。便利な連携ほど、AIが扱える情報と実行できる操作を細かく分ける必要があります。
実務では「閲覧できる」「下書きを作れる」「外部へ送信できる」「設定を変更できる」を別々の権限として扱う考え方が役立ちます。初期段階では、閲覧範囲を限定し、出力は下書きにとどめ、送信・公開・削除・支払い・権限変更などの操作は人が明示的に承認する設計にします。人の確認が形式だけにならないよう、確認画面には参照元、変更内容、送信先、影響範囲を表示できると望ましいでしょう。
ここで注意したいのが、入力の中に混ざる指示です。外部サイト、受信メール、添付文書などには、AIを誤った操作へ誘導する文章が含まれる可能性があります。これを一般にプロンプトインジェクションと呼びます。信頼できない文章を読んだAIが、その文中の「この手順を無視して送信して」といった命令を実行できないように、コンテンツとシステムの命令を分離し、外部操作には別の承認を置く必要があります。
確認リストには、少なくとも次を入れます。
- どのデータ源を読めるか。部署、案件、保存期間の制約はあるか。
- AIが使える外部ツールは何か。読み取り専用か、変更もできるか。
- 実行前に人へ表示する項目と、承認者は誰か。
- 操作履歴、モデルの版、入力の参照元、承認記録をどこに残すか。
- 異常な出力、利用量の急増、誤送信の疑いが出たとき、誰が止めるか。
クラウドサービスを使う場合は、提供元のデータ利用・保持・学習への利用の方針、リージョン、契約プランごとの差、管理機能も契約前に確認します。公開ドキュメントがあっても、自社の契約条件と完全に同じとは限りません。個人情報や営業秘密を扱うなら、社内の情報セキュリティ部門、法務、個人情報保護の担当者に相談し、必要に応じて契約書やデータ処理に関する文書を確認してください。
確認項目5:監査ログと「やめる条件」を先に決める
小さく試したAIを広げるとき、成功例を共有するだけでは安全な運用になりません。後から「どの依頼で、どの設定のモデルが、何を出したか」を追えるようにしておくと、品質低下や問い合わせが起きた際に原因を探しやすくなります。すべての入力を無制限に保存すればよいわけではなく、個人情報・機密情報の保存期間やアクセス権も考える必要があります。必要な項目だけを、定めた保管場所と期間で扱うことが基本です。
ログに残す候補は、実行日時、利用したモデルと版、処理の種類、参照したデータの区分、出力を使ったかどうか、承認者、エラーや修正の種類です。本文そのものを保存できない場面でも、処理IDやハッシュ、分類情報、担当者の確認結果を残せる場合があります。実際に何を保存できるかは、法令、契約、社内規程、利用目的に照らして決めましょう。
同時に、利用を止める条件を合意しておくことが重要です。例えば、誤送信の疑いがある、特定の種類の誤りが連続する、利用量が想定から大きく外れる、権限設定の不備が見つかった、提供元の仕様変更で評価結果が再現しない、といった場合です。止める決定を現場の個人だけに任せず、連絡先、一次対応、影響範囲の確認、利用者への案内、再開時の再評価を手順化します。
新モデルは更新や提供条件の変更を伴うことがあります。モデル名が同じでも、版や挙動、利用可能な機能、上限、価格が変わる可能性を前提にします。定期的に少量の評価セットを回し、以前と同じ代表例で品質、費用、所要時間を確認する「再評価日」を置くと、導入直後だけの検証で終わりにしにくくなります。
比較表は5列で十分:会議で使える最小の形
大規模な導入計画の前に、A4一枚程度の比較表を作るなら、次の五列から始められます。行には「会議メモの要約」「問い合わせの分類」「社内ナレッジの検索補助」など、実際の仕事を書きます。
|確認軸|記録する内容|見る人|
|—|—|—|
|仕事と品質|代表例、合格条件、重大な誤り、修正時間|業務担当者・品質担当者|
|費用と時間|入力・出力の実測、1件当たりの総コスト、処理時間|業務担当者・経理・調達|
|データ|入力可能な情報、保存先、保持期間、第三者提供の条件|情報セキュリティ・法務|
|権限と承認|閲覧範囲、操作範囲、承認者、例外時の止め方|システム管理者・責任者|
|運用|ログ、問い合わせ窓口、再評価日、切り戻し方法|導入チーム全体|
この表の狙いは、点数でモデルを競わせることではありません。「どの仕事なら、どの条件で、誰が確認して使えるか」を合意できる状態を作ることです。性能が優れて見える候補でも、権限の分離やログの準備が追いつかないなら、対象業務を狭める選択が合理的です。逆に、比較的単純な下書き業務でレビューが定着しているなら、小さな試行から学べます。
まとめ:新モデルは「小さく測り、根拠を残して広げる」
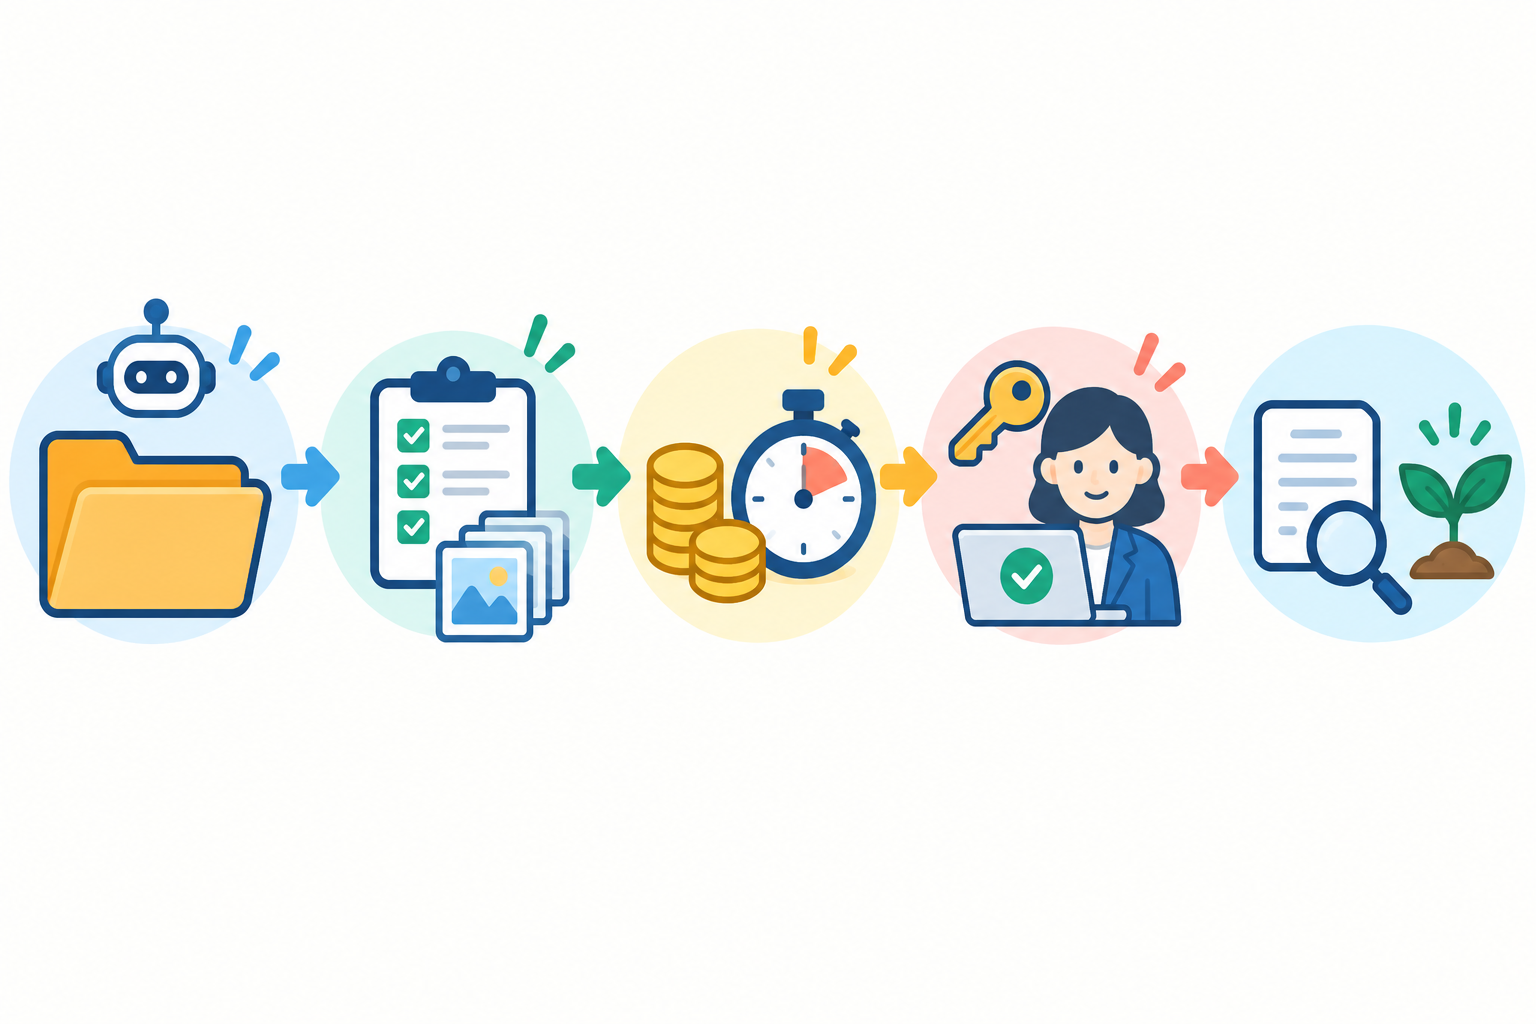
Claude Sonnet 5.5のような新モデルの登場は、既存の仕事を見直す契機になります。ただし、速さやAPIの料金だけを比較しても、業務での価値とリスクは判断できません。最初に任せる仕事を小さく定義し、代表例と失敗例で品質を測り、1件当たりの総コストを見ます。そのうえで、データの扱い、閲覧・実行・承認の分離、監査ログ、停止条件を整えます。
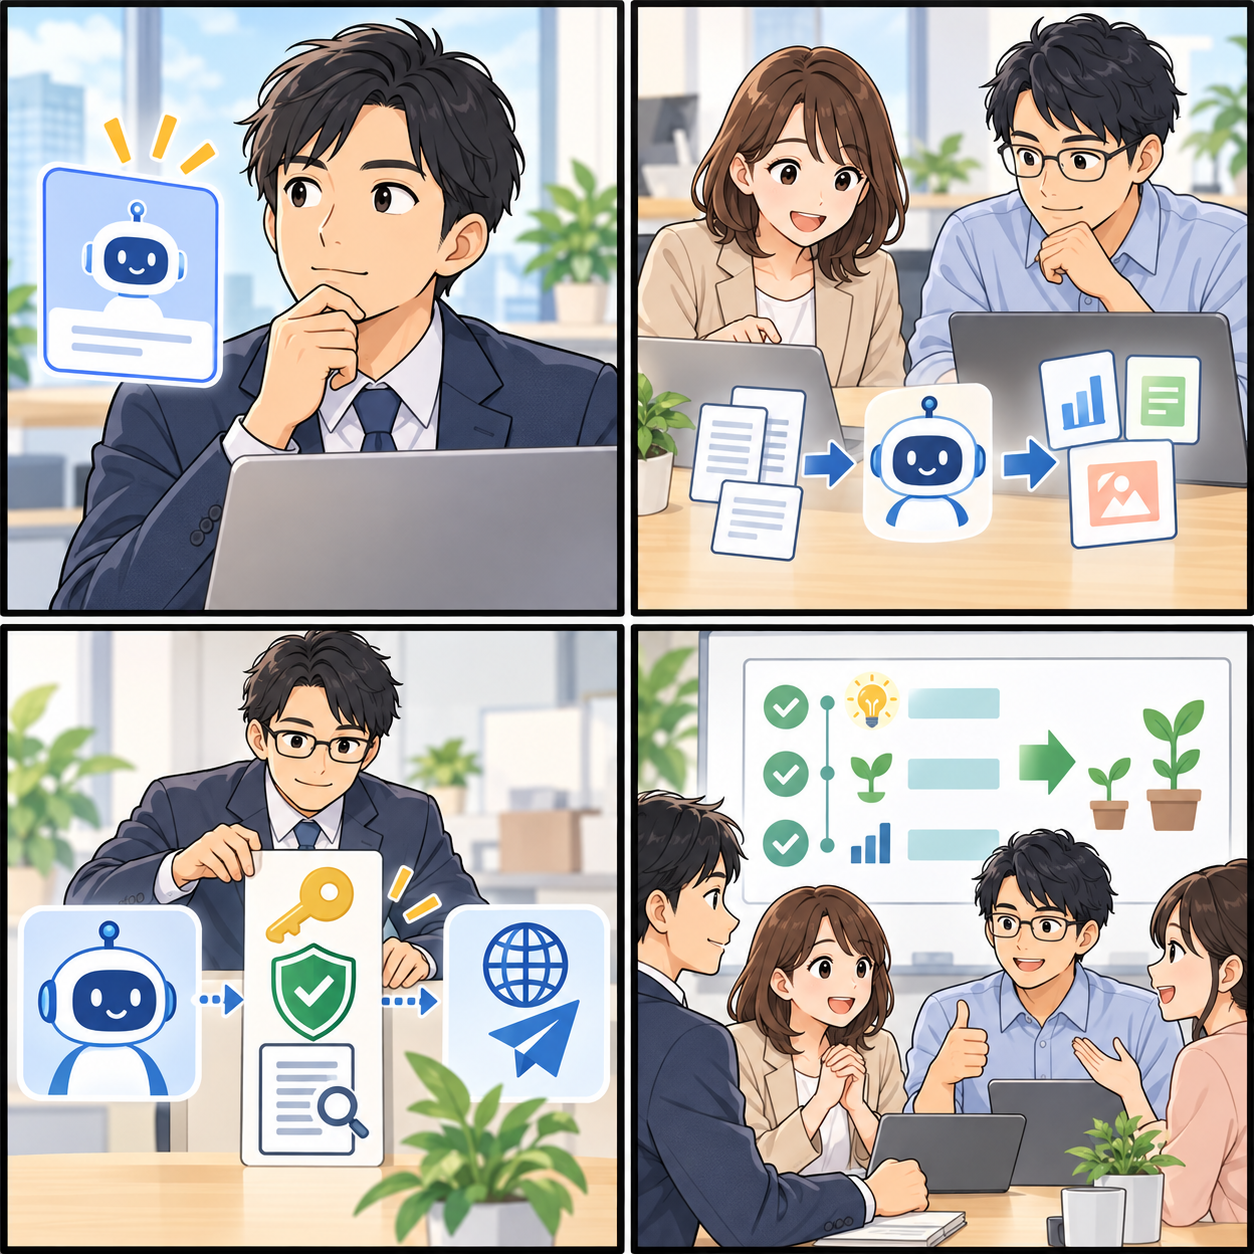
導入判断で迷ったら、次の順序に戻ってください。
1. 低リスクで人が確認できる仕事を一つ選ぶ。
2. 匿名化した代表例と難しい例で、結果を記録する。
3. 料金だけでなく、レビューを含む時間と運用費を比べる。
4. AIに見せる範囲とできる操作を最小限にし、人の承認を残す。
5. 再評価日と停止条件を決め、結果を根拠に対象を広げる。
AIは作業の下書きや整理を支える道具になり得ますが、事実確認、対外的な約束、個人に影響する判断、重要な操作の責任まで引き受けるものではありません。モデルの更新を急ぐより、用途に合う検証と人の責任を組み合わせることが、長く使える仕組みにつながります。