AIを業務に取り入れるとき、「どのモデルが賢いか」だけで選んでよいのでしょうか。社内の文書を要約する、ソフトウェアを作る、顧客からの問い合わせを補助する、といった用途では、回答の質だけでなく、どのデータに触れられるか、誰が使えるか、あとから作業を確認できるかが重要になります。とくに複数の部門や外部サービスをまたぐAIでは、便利な機能ほど運用の土台が問われます。
OpenAIとGoogle Cloudは2026年10月21日、OpenAIのフロンティアモデルとCodexのエージェント型ワークフローを、Google Cloudの「Model Garden」で提供する提携を発表しました。発表によれば、Google Cloudの利用企業は、既存のクラウド環境にあるアクセス制御、データガバナンス、監査の仕組みと組み合わせながら、OpenAIのモデルを利用できるようになります。
ただし、これは「どの企業でも今すぐ同じ条件で使える」という意味ではありません。Google Cloudの説明では、GPT-6 Astra、GPT-6.1 Sol、GPT-6 Lunaは、まず一部の企業向けの限定プレビューとして提供されます。利用できるモデル、地域、価格、データ保持の設定、利用条件は今後も変わり得ます。今回のニュースは、AIの選択肢が増える動きとして捉えつつ、導入前に何を確かめればよいかを考える機会でもあります。
OpenAIモデルがGoogle Cloudで使えるとはどういうことか
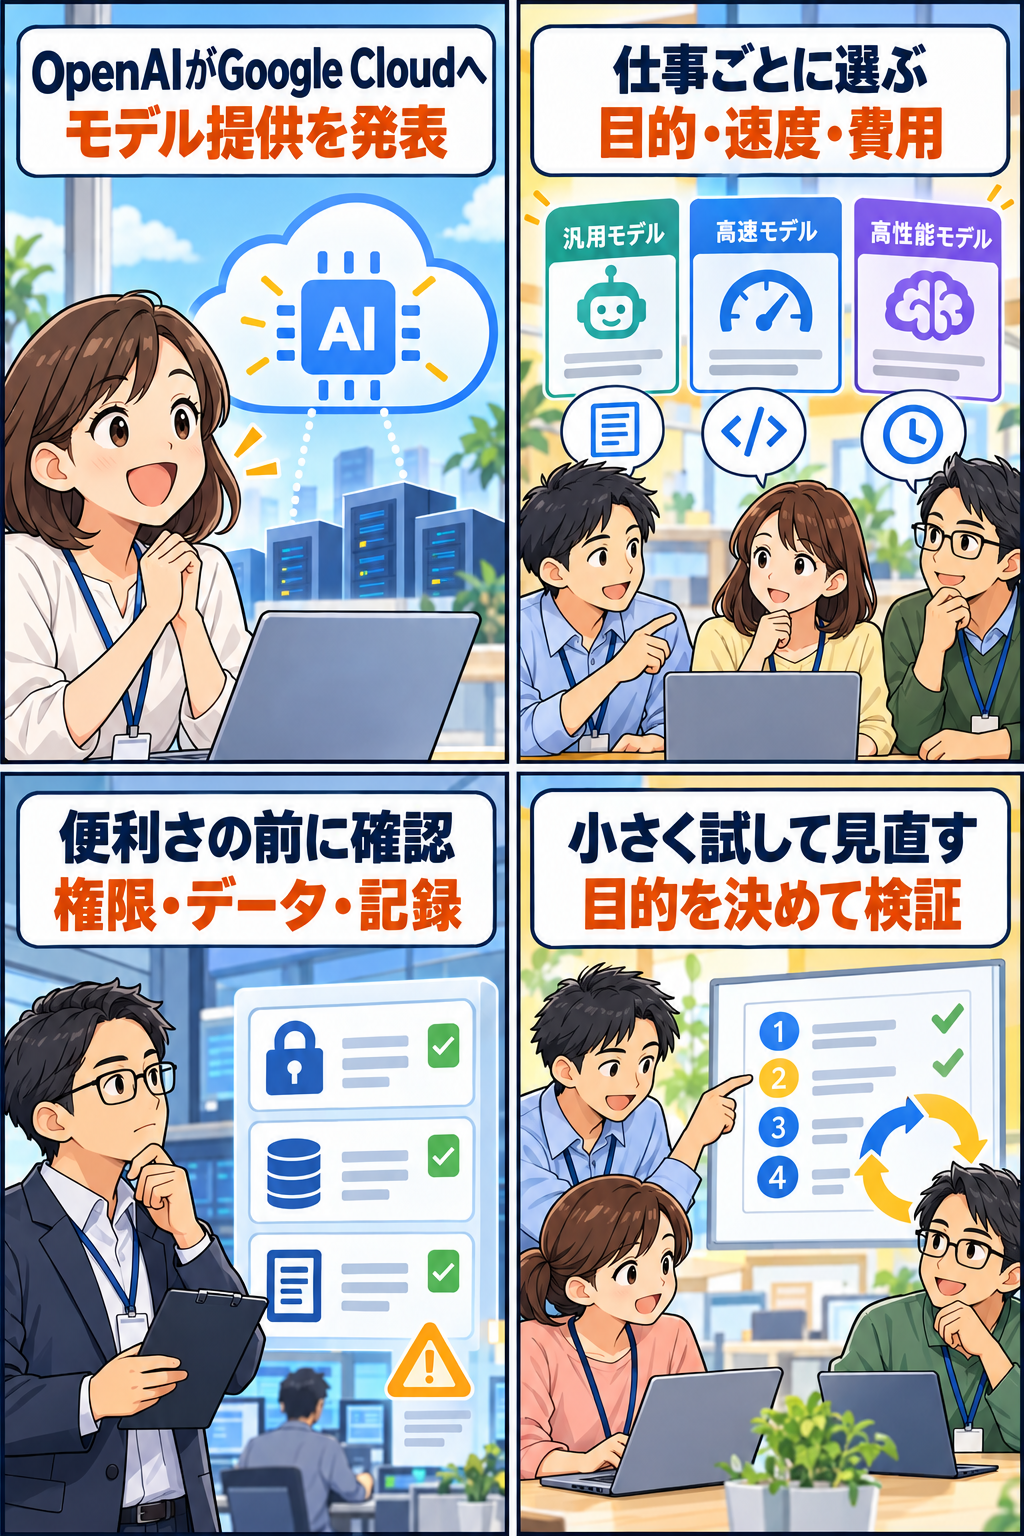
今回の発表の中心は、OpenAIのモデルをGoogle CloudのModel Gardenから選べるようにする計画です。Model Gardenは、企業が複数のAIモデルを比較し、アプリケーションや業務システムに組み込むための入り口として位置付けられています。OpenAIの発表では、フロンティアモデルとCodexのエージェント型ワークフローをModel Gardenに持ち込み、複雑なエージェント型の仕事を大規模に動かすことを目指すとしています。
Google Cloudの発表で挙げられた対象は、GPT-6 Astra、GPT-6.1 Sol、GPT-6 Lunaです。説明上、Astraはコーディング、コンピュータ操作、専門的な仕事、科学研究などに向けた高い能力のモデル、Solはより低いコストで幅広い業務を狙うモデル、Lunaは日常業務を大量に処理するための高速・費用効率重視のモデルとして紹介されています。これは提供側の位置付けであり、個々の会社・業務での精度、速度、費用を保証するものではありません。
また、購入はGoogle Cloud Marketplace経由となり、既存のGoogle Cloudの利用額コミットメントから支払える仕組みが案内されています。現場の担当者にとっては、請求や調達の流れをまとめられる可能性があります。一方、調達が一つにまとまることと、責任が一つにまとまることは別の話です。モデルの提供者、クラウド基盤の提供者、自社の運用担当者、データを預けた顧客や取引先の間で、どこまでを誰が担うのかは、導入ごとに整理する必要があります。
OpenAIはMicrosoftが引き続き同社の主要クラウドパートナーであると説明しています。今回の発表は、その関係が終わるという発表ではなく、企業がモデルを利用する経路を広げる動きです。「OpenAIかGoogleか」の二者択一ではなく、既存の技術環境・契約・セキュリティ要件に応じて、モデルと基盤の組み合わせを検討する場面が増える、と考えるほうが実態に近いでしょう。
なぜ企業は「モデルの選択肢」を求めるのか
AIの導入を始めた企業では、最初は議事録の要約や文章の下書きのような小さな用途から試すことが多いでしょう。しかし、利用範囲が広がると、一つのモデルだけですべての仕事を扱うのが適切とは限りません。短い定型文を数多く分類する仕事と、複数の資料を読み比べて開発を補助する仕事では、求める応答時間、費用、説明の必要性、誤りが起きた場合の影響が異なります。
たとえば、社内文書の検索補助では、最新の社内規程に正しくたどり着けることが重要です。ソフトウェア開発の補助では、生成されたコードが既存の設計や安全な実装に合っているかを、テストとレビューで確かめなければなりません。顧客対応の下書きでは、相手の個人情報や契約情報を必要以上に扱わず、最終送信前に人が内容を確認できることが必要になります。
Google Cloudは、性能、待ち時間、費用効率に応じてモデルを選び替えられることを利点として挙げています。これは、モデル名で意思決定を終えず、用途に合わせて選ぶという考え方です。ただし「最適」という言葉は、会社の目的によって変わります。コストが低いことが重要な仕事もあれば、誤答したときに大きな影響が出るため、より厳しいレビュー工程を優先すべき仕事もあります。モデルの比較は、ベンチマークの数字だけでなく、自社の実データを使わない安全な検証環境で、現実の業務条件に近い評価を行って初めて意味を持ちます。
モデルの切り替えが容易になるほど、もう一つの課題も生まれます。どの案件にどのモデルを使ったか、設定はいつ変わったか、出力はどの資料を根拠にしたかを記録しなければ、問題が起きた後に原因を追えません。選択肢の多さを活かすには、自由に使わせるだけでなく、利用目的と変更手順を整えることが大切です。
Model Gardenと企業のガバナンスはどうつながるのか
今回の発表で注目したいのは、モデルそのものだけでなく、企業向けのデータ管理と運用の説明です。Google Cloudは、顧客のプロンプト、文脈、出力を指定したデータ境界内に置き、基盤モデルの学習には使用しないと説明しています。また、ゼロデータ保持(ZDR)の選択肢は「近日提供予定」とされています。ここは言葉の印象だけで判断せず、実際の契約、提供地域、モデル、設定画面、ログやバックアップの扱いを確認すべき部分です。
同社は、専用のGoogle Cloudインフラ、分離されたゲートウェイ、将来のConfidential Compute、認証済みのID、統合監査ログ、VPC Service Controlsなども挙げています。これらは、誰が何にアクセスしたかを制限・把握するための仕組みとして役立つ可能性があります。しかし、仕組みが用意されていることと、自社で有効に設定されていることは同じではありません。広すぎる権限、共有アカウント、古い連携設定、見られていないログがあれば、技術的な機能だけでは守れません。
ここでいう「ガバナンス」は、難しい専門用語として身構える必要はありません。簡単に言えば、AIに任せる範囲を決め、責任者を置き、記録を残し、問題があれば止めて直せるようにすることです。AIに営業資料の下書きを任せる場合と、採用候補者の情報を整理する場合、医療・金融・法律に関係する問い合わせを扱う場合では、許容できる誤りや必要な人の確認が違います。用途を一括りにせず、影響に応じて扱いを変えることが出発点になります。
NISTのAIリスク管理フレームワークは、AIに伴うリスクを扱う際の考え方として、Govern(統治)、Map(状況とリスクの把握)、Measure(評価・追跡)、Manage(対応)という四つの機能を示しています。これは法的な合格証ではなく、企業が自社の状況に合わせて考えるための枠組みです。今回のように複数のモデルとクラウドを組み合わせる場合にも、目的、データ、影響、評価、運用中の見直しをつなげる視点として役立ちます。
導入前に確認したい七つのポイント
1. 解決したい仕事は具体的か
「AIを導入する」だけでは、必要なモデルも安全策も決められません。問い合わせの一次分類を短くしたいのか、開発者が社内のコードを理解しやすくしたいのか、会議資料のたたきを作りたいのかを、まず具体的にします。成果を測る指標も、単なる利用回数ではなく、作業時間、誤りの件数、確認にかかる時間、利用者の負担など、目的に結び付けて考えましょう。
AIが向かない仕事を見極めることも重要です。正解が一つに決めにくい評価、人の権利や機会を左右する判断、緊急時の案内などは、自動化の便利さよりも、説明・確認・異議申し立ての経路を優先する必要があります。AIの提案を使う場合でも、誰が最終判断をするかを先に決めます。
2. 入力してよいデータを区分できているか
AIに渡す情報には、公開情報、社内の一般情報、契約上の秘密、顧客情報、個人情報、特に慎重な取り扱いが必要な情報が混在します。すべてを同じように扱うのではなく、データの種類ごとに、入力可否、匿名化・仮名化の要否、保存期間、閲覧者、外部連携の可否を決める必要があります。
「社内だけで使うから大丈夫」とは限りません。プロンプトに氏名、取引先名、未公開の数字、アクセスキー、健康情報などが入れば、その情報はシステム内の記録・監査・保管の対象になり得ます。利用者が迷わないよう、入力してよい例・避ける例を短いルールとして示し、テスト環境では実データを使わない原則を置くとよいでしょう。
3. 権限は最小限になっているか
AIエージェントが社内の文書、メール、コード、チケット管理、顧客管理システムにつながる場合、便利さとともに権限の範囲が広がります。最初から全社の情報に接続するのではなく、目的に必要なデータだけに限定し、読み取りと書き込みの権限を分けます。送信、公開、購入、設定変更、顧客への回答といった外部への影響が大きい操作は、人の承認を挟む設計が基本です。
退職・異動・委託終了の際に権限を外せるか、サービスアカウントの鍵を誰が管理するか、緊急時に接続を止める方法があるかも確認します。AIの能力が高くても、不要な情報に触れられないようにする境界は、組織側が設計しなければなりません。
4. 出力の根拠と限界を確認できるか
AIの文章は自然に読めても、事実関係が正しいとは限りません。社内資料を参照する仕組みでは、どの文書のいつの版を使ったのか、引用箇所に戻れるか、情報が見つからないときに推測で埋めていないかを確認します。正確さが重要な業務では、回答をそのまま使うのではなく、根拠資料へのリンク、担当者によるレビュー、更新日の表示を組み込みます。
モデルを変えれば誤りがなくなるわけでもありません。検証では、普段の質問だけでなく、古い資料が混じるケース、質問が曖昧なケース、権限がない資料を求めるケース、意図的に誤った前提を含むケースも試します。期待通りに答えないとき、停止・差し戻し・人への引き継ぎができることを確認しましょう。
5. 監査ログを「見られる形」で残せるか
ログは、ただ保存するだけでは役に立ちません。誰が、どのAIサービスを、どの権限で、いつ利用したか。どの外部ツールを呼び出し、どの操作が実行されたか。問題が起きた場合に、その流れを必要な範囲で追えることが重要です。個人情報や機密情報をログに過剰に残さない配慮も必要になります。
記録を確認する責任者、異常を検知した際の連絡先、保存期間、閲覧できる人、監査の頻度を決めて初めて運用になります。モデルの切り替え、プロンプトのテンプレート変更、連携先の追加なども、影響を確認して記録できるようにすると、後で原因を調べやすくなります。
6. コストと利用量を予測・制御できるか
複数モデルを選べる環境では、費用の管理も導入設計の一部です。大量の文書を処理する、エージェントが繰り返しツールを使う、予期しない問い合わせが集中する、といった状況では利用量が増える可能性があります。部署別・用途別の予算、上限、アラート、再試行の回数、利用停止の条件を設けましょう。
低コストのモデルを選べば必ず全体費用が下がるわけではありません。出力の確認や修正に時間がかかれば、人の作業コストが増えることもあります。逆に、より高い性能のモデルを一部の重要な用途に限ることで、やり直しを減らせる場合もあります。料金・性能・人の確認を合わせて、実際の業務で比較することが大切です。
7. 問題が起きたときに止めて相談できるか
誤った回答、想定外のデータ参照、プロンプト注入のような外部からの指示、連携先の障害などは、導入後にも起こり得ます。現場が「AIの結果だから仕方ない」と抱え込まず、報告できる窓口を用意します。問題のあるエージェントや連携をすぐ止められるか、影響範囲をどう確認するか、利用者や顧客への連絡を誰が判断するかを、試験運用の段階から決めておきましょう。
NISTの枠組みでも、リスク管理は導入前の一回限りではなく、継続して行うものとされています。環境やモデル、使い方が変われば、前に行った評価だけでは足りなくなることがあります。定期的に用途・権限・ログ・評価結果を見直す習慣が、長く使うための安全策になります。
小さく始めるための実践的な進め方
最初の対象には、扱うデータが比較的限定され、結果を人が確認しやすく、失敗しても大きな外部影響が出にくい業務を選びます。たとえば、公開済みの社内ルールを検索しやすくする、研修資料の下書きを作る、テスト用コードの説明を補助する、といった用途です。いきなり顧客への自動送信や人事評価に結び付けるのではなく、AIの出力を下書きとして扱う範囲から始めると、問題を見つけやすくなります。
試験運用では、現場の利用者だけでなく、情報システム、セキュリティ、法務・個人情報保護、必要に応じて品質管理や経営の担当者も早い段階から関わります。それぞれが最後に確認するのではなく、用途とデータの設計を一緒に決めることで、後から大きな作り直しを減らせます。外部のサービスやクラウドを使う場合は、契約で定めるデータの利用目的、保管、削除、再委託、障害通知、サポート範囲も読み合わせましょう。
評価の際には、「AIが役に立ったか」だけでなく、「使わない場合と比べて何が変わったか」を見る必要があります。回答の正確さ、根拠のたどりやすさ、利用者の確認時間、例外の扱い、誤りを報告するしやすさ、コストを記録します。良い結果が出たとしても、対象業務やデータの範囲を広げる前には、もう一度リスク評価を行います。
限定プレビューという提供段階であれば、特に仕様変更に備えることが重要です。新しい機能やモデルが追加されたときに自動で業務へ影響しないよう、変更情報を確認する担当と手順を決めておきます。ベンダーの発表は導入検討の材料になりますが、自社のデータ・利用者・法令・契約に合うかどうかまで代わりに判断してくれるものではありません。
よくある疑問
Google Cloudを使っていれば、すぐにOpenAIモデルを利用できますか
Google Cloudの発表時点では、GPT-6 Astra、GPT-6.1 Sol、GPT-6 Lunaは一部の企業向けの限定プレビューとされています。利用可否、申請、対象地域、契約、料金、機能は変更される可能性があります。自社のGoogle Cloudコンソールで表示される内容や、公式の案内、担当者からの説明を確認してください。
「データは学習に使わない」と書いてあれば、何でも入力してよいですか
いいえ。発表にあるデータの扱いは重要な確認事項ですが、入力できる情報の範囲は、自社の規程、顧客や取引先との契約、個人情報保護の要件、設定、ログの扱いなどを合わせて判断する必要があります。特に個人情報、健康情報、未公開の事業情報、認証情報を扱う場合は、担当部署や専門家に確認し、必要最小限にすることが大切です。
AIエージェントに仕事を任せれば、人の確認は不要になりますか
不要にはなりません。エージェントは情報収集や手順の補助を効率化できる一方、誤った前提で動く、関係のない指示に影響される、例外を見落とす可能性があります。外部に送信する、契約を変更する、支払いに関わる、採用・評価・医療・法律・金融など重要な判断に影響する操作では、責任者による確認と停止手段を残す必要があります。
このニュースは投資や特定サービスの利用を勧めていますか
いいえ。本記事は公開された発表内容と、企業がAIを検討する際の一般的な確認ポイントを整理したものです。特定の企業、株式、クラウドサービス、AIモデルへの投資・契約・導入を勧めるものではありません。費用、性能、契約、法令への適合は、利用する組織の状況に応じて一次情報や専門家に確認してください。
まとめ:選べるAIほど、運用の設計が重要になる
OpenAIモデルがGoogle CloudのModel Gardenで提供されるという発表は、企業がAIを使う経路とモデルの選択肢が広がる動きです。Google Cloudの発表では、既存のアクセス制御、データ境界、統合監査ログなどと組み合わせる方向が示され、OpenAIの発表ではCodexを含むエージェント型の業務利用を後押しする構想が説明されています。
一方で、発表時点では対象モデルは限定プレビューです。機能・料金・提供範囲・データ保持の条件を一般化せず、導入時の公式情報と契約内容を確認する必要があります。モデルが選べるからこそ、業務の目的、入力データ、権限、根拠確認、監査ログ、費用、停止・相談の仕組みを先に整えることが重要です。
AI導入の成功は、もっとも新しいモデルを選ぶことだけでは決まりません。小さく試し、結果とリスクを記録し、必要なら止めて見直せること。人が責任を持つ判断を残すこと。その積み重ねが、便利さを持続的な価値に変える基盤になります。
参考資料
- OpenAI:OpenAI models are coming to Google Cloud(2026年10月21日)
- Google Cloud:Google Cloud brings OpenAI models to customers(2026年10月21日)
- NIST:AI Risk Management Framework
※この記事は2026年10月22日時点の公開情報に基づく一般的な解説です。サービスの利用条件、機能、データの取り扱い、法令・規制は変更されることがあります。契約、個人情報、雇用、医療、法律、税務、金融などに関わる個別の判断は、公式情報と担当者・専門職に確認してください。