AIに資料を探させ、予定を調整し、社内システムの定型作業まで任せる――そんな「AIエージェント」の使い方が現実味を増しています。便利になる一方で、気になるのは「そのAIは何にアクセスできるのか」「想定外の操作をしたら止められるのか」「後から経緯を確認できるのか」という点です。
2026年10月27日、IBMは企業向けAIエージェントについて、IDの確認、必要最小限のアクセス権、異常時の失効や停止、利用状況の評価を組み合わせる新たな機能群を発表しました。これは、AIに仕事を任せるほど、導入前の運用設計が重要になることを示すニュースです。
この記事では、発表された内容を手がかりに、AIエージェントが従来のチャット型AIとどう違うのか、なぜIDと権限の管理が必要になるのか、導入する側が何を確認すればよいのかを、できるだけ平易に整理します。特定製品の導入を勧めるものではなく、組織ごとの安全な検討に役立つ基本の見取り図としてお読みください。
IBMが発表したAIエージェント管理の要点
IBMの発表の中心は、AIエージェントを単なるソフトウェアの機能ではなく、業務システムの中で行動する「人ではない利用主体」として扱う考え方です。人が社内システムへ入る際には、通常、誰なのかを確かめ、業務に応じた権限を渡し、利用記録を残します。AIエージェントにも、似た管理を当てはめようとする内容です。
発表では、HashiCorp VaultにAIエージェント向けのID管理と認証情報の制御を広げること、watsonx Orchestrateで複数の環境にあるエージェントを見つけ、隔離し、評価する機能を示しています。IBMの説明によれば、エージェントごとに所有者、利用状態、与えた権限を記録し、必要な範囲だけにアクセスを絞る設計です。許可されていない情報への取得や操作を試みた場合には、アクセスを拒否し、セッションや認証情報を失効させることも想定されています。
ここで大切なのは、「AIを入れれば自動的に安全になる」という話ではないことです。発表は各機能の目的や提供予定を示すもので、実際の安全性は、接続先の設定、データの置き方、承認の流れ、担当者の監視、障害時の対応などに左右されます。一般提供のもの、公開プレビュー、技術プレビューのものも混在しています。自社で使える機能や適用範囲は、正式な製品資料、契約条件、運用担当者への確認が必要です。
AIエージェントは「答えるAI」と何が違うのか
チャット型AIは、質問に対して文章や要約、アイデアを返す使い方が中心です。もちろん、回答の正確性や個人情報の扱いには注意が必要ですが、最終的に送信・登録・購入などの操作をするのは人である場合が多いでしょう。
一方でAIエージェントは、目的を与えると、必要な情報を探し、複数のツールを呼び出し、条件に応じて次の作業へ進む形で使われます。たとえば、問い合わせ内容を分類して担当チームに振り分ける、在庫情報を照合して発注候補を作る、障害通知を読み取り、関連する手順書を探して担当者へ知らせる、といった用途です。設計次第では、カレンダー、顧客管理、ファイル保管、社内データベース、クラウド環境などに接続します。
この違いは、AIが扱う情報と、できる操作の範囲を広げます。便利さは「外部の道具を使えること」から生まれますが、同時に、誤った指示、あいまいな条件、意図しないデータ参照、権限の持ちすぎといった問題の影響も大きくなります。単に回答内容を読むだけでなく、AIが何を読み、どの操作を実行し、どこまで進めるのかを管理する必要が出てくるのです。
たとえば「月次の未処理案件を整理して」と依頼する場面を考えてみましょう。閲覧だけで一覧を作るなら、影響は比較的限定的です。しかし、顧客へ自動送信する、案件の担当者を変更する、請求データを更新する、外部サービスにアップロードするといった権限まで持つと、確認不足が具体的な損害や信用問題につながる可能性があります。AIが賢く見えるかどうかより、任せる仕事の境界を明確にすることが先になります。
なぜ「ID」が必要になるのか
人の利用者であれば、アカウント名、所属、役割、承認者を手がかりに、「誰が何をしたのか」を調べられます。AIエージェントにも固有のIDを持たせるという発想は、問題が起きたときに責任をAIへ押し付けるためではありません。エージェントの所有者、目的、接続先、権限、有効期限、変更履歴を結び付け、人が管理できる状態にするためです。
固有のIDがないまま、複数のエージェントが共通の管理者アカウントや共有のAPIキーを使うと、後から履歴を見ても、どのエージェントが操作したのか区別しにくくなります。退職・異動・業務変更があった際に、不要な権限を回収することも難しくなります。AIエージェントが増えるほど、一覧に存在しない「見えない自動化」が生まれやすく、管理の穴になります。
IBMは、エージェントごとに所有者やライフサイクル、付与された権限を記録する仕組みを説明しています。一般の組織がこの考え方を取り入れるなら、難しい製品名から始める必要はありません。まずは、AIエージェントの台帳を作り、名称、業務目的、オーナー、接続するサービス、扱うデータ、権限の期限、緊急停止の担当者を一つにまとめるだけでも意味があります。
台帳は作って終わりではありません。試験利用から本番利用へ移る時、接続先を増やす時、モデルを更新する時、担当者が変わる時に更新します。定期的に「今もこのエージェントは必要か」「この権限は必要か」を確認する機会を設けることで、便利さの陰に不要なアクセスが残ることを減らせます。
権限は「必要な分だけ」に絞る
AIエージェントの安全設計でよく出てくるのが、最小権限の原則です。これは、仕事をするのに必要な権限だけを与え、それ以外は与えないという考え方です。経理の資料を要約するエージェントに、人事情報の閲覧権限まで渡す必要は通常ありません。問い合わせの下書きを作るエージェントに、顧客データを削除する権限まで必要とは限りません。
権限を小さくすることは、AIを信用しないという意味ではありません。誤作動、設定ミス、外部ツール側の不具合、認証情報の漏えい、悪意ある入力など、さまざまな経路で問題が起き得ることを前提に、被害が広がる範囲を小さくする考え方です。人間のアカウント管理でも同じで、利用者に常に管理者権限を渡さないのと似ています。
IBMの発表では、短期間で期限切れになる認証情報や、不要になったときに失効させられる認証情報が説明されています。長期間使える共通の秘密情報を置きっぱなしにするより、用途と期間を限定できれば、万一の際に影響を抑えやすくなります。ただし、短期認証情報を採用すればすべて解決するわけではありません。発行する条件、保管方法、更新エラー時の業務影響、監査ログの確認方法まで含めて設計する必要があります。
導入時には、次のように権限を具体化すると検討しやすくなります。
- 読み取りだけでよいのか、作成・更新・削除まで必要なのか
- 対象はどの部署、どのフォルダ、どの顧客区分、どの時間帯なのか
- 一度の実行で扱える件数や金額に上限を設けるか
- 個人情報、契約書、認証情報、健康情報などを対象から外せるか
- 本番環境へ影響する操作には、人の承認を挟めるか
「全部できるエージェント」は一見便利ですが、用途が広いほど説明責任も確認範囲も大きくなります。小さな対象、読み取り専用、限定された時間帯から始め、記録を見ながら段階的に広げる方が、現実の業務に合わせて見直しやすいでしょう。
見つける・隔離する・止めるという三つの備え
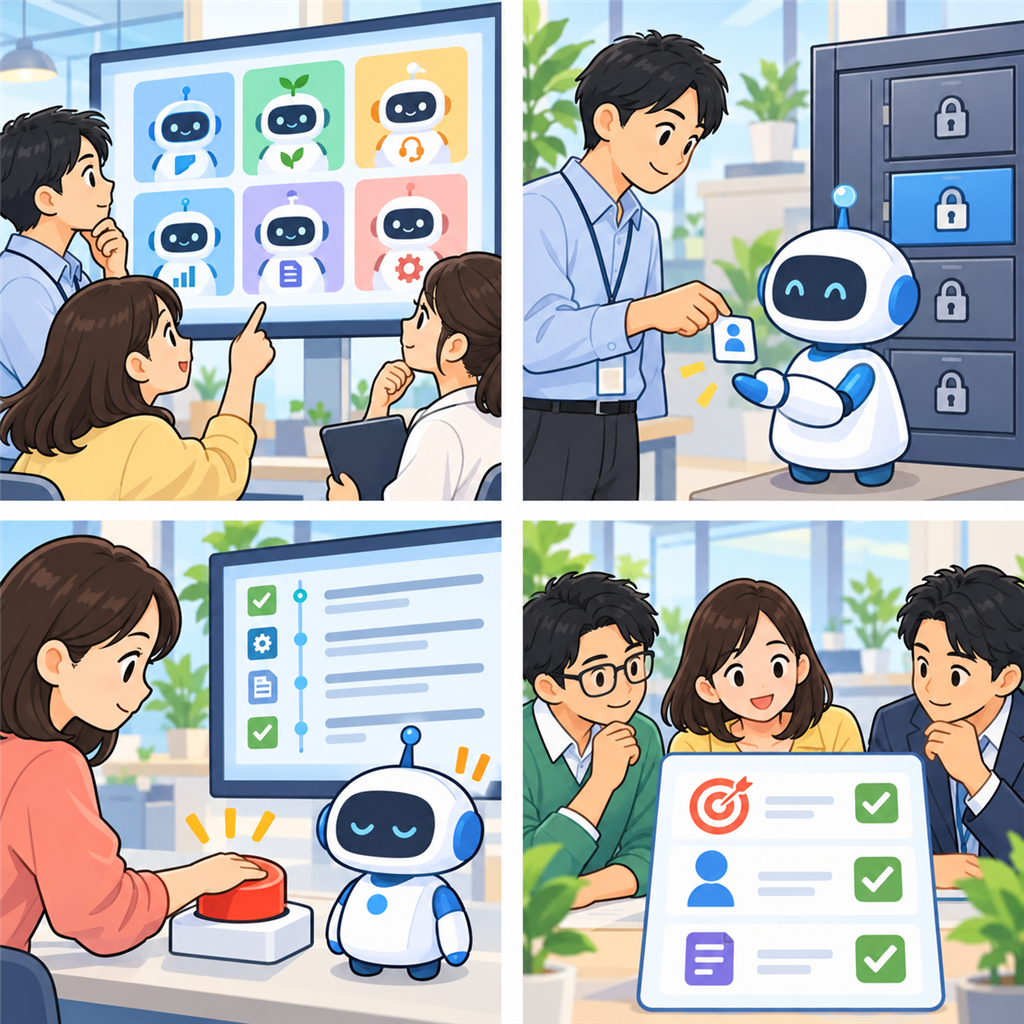
AIエージェントの管理では、問題が起きないようにする予防だけでなく、起きたときに早く気付いて影響を止める備えも必要です。IBMは複数の環境で作られたエージェントを発見する機能、他のエージェントに影響しないよう隔離する機能、停止用のスイッチ、導入前後の評価と監視を挙げています。
まず「見つける」は、組織にどんなエージェントが存在するかを知ることです。部門ごとに試験導入が進むと、情報システム部門が把握しないまま、さまざまな外部サービスとつながることがあります。これを一律に禁止するのではなく、申請・登録の窓口と、試験利用のルールを用意し、可視化できる状態にすることが重要です。現場が相談しやすい運用でなければ、実態を把握することは難しくなります。
次に「隔離する」は、あるエージェントの異常が他へ連鎖しないようにする考え方です。たとえば、検証用のエージェントを本番の顧客データベースへ直接つなげない、実行環境を分ける、接続先ごとに許可を設定する、といった方法があります。AIの出力に含まれる指示が外部ツールの操作へ影響する可能性もあるため、信頼できない入力をそのまま実行命令として扱わない設計も欠かせません。
そして「止める」は、緊急時に人が介入できることです。停止ボタンがあるだけでは不十分で、誰が、どの条件で、どの手順で止めるのかが共有されていなければ、いざというときに機能しません。停止後に認証情報を失効できるか、実行中の処理をどう扱うか、取引先や利用者へどのように連絡するか、復旧の承認者は誰かまで、あらかじめ決めておくと対応がぶれにくくなります。
評価と記録は「導入前」と「導入後」の両方で必要
AIエージェントは、導入前のデモでうまく動いても、実際のデータや例外処理、利用量の変化で予想外の挙動をすることがあります。IBMの発表にも、導入前に品質・正確性・準拠状況を試し、導入後も監視する考え方が含まれています。これは特定の製品に限らず、AIを業務で使う際の基本的な姿勢です。
導入前には、日常的な入力だけではなく、曖昧な依頼、矛盾した条件、権限のない操作要求、個人情報を含む入力、処理量の急増などを試します。何を正解とするか、どの時点で人へ引き継ぐか、どの操作を拒否するかを、現場・情報システム・法務やリスク管理など関係者で合意しておくと、評価が単なる「使えそう」という感想で終わりません。
導入後には、実行回数、失敗率、手動で差し戻した理由、例外対応の件数、利用コスト、権限エラー、外部サービスへの送信状況などを記録します。ログは、監視のためだけでなく、業務を改善する材料にもなります。ただしログには個人情報や機密情報が含まれることがあるため、閲覧できる人、保存期間、マスキング、持ち出しの制限も同時に決める必要があります。
評価指標を増やしすぎると現場が疲弊します。最初は、業務の目的に直結する少数の指標と、安全上見逃せない警告を選ぶのが現実的です。たとえば、問い合わせ振り分けなら「誤振り分けの割合」「人が修正した件数」「対応遅延」「機密情報を含む不適切な送信」のように、品質と安全を並べて確認できます。
便利さだけで判断しないための導入チェックリスト
AIエージェントの導入を検討するときは、「どのモデルが高性能か」だけでは判断できません。次の問いに答えられるかを確認すると、運用の抜けを見つけやすくなります。
1. 目的と担当者は明確か
「作業を自動化する」ではなく、どの業務の、どの手順を、どの品質まで支援するのかを定めます。業務のオーナー、技術の担当者、最終承認者、問い合わせを受ける窓口を分けて書き出します。AIに任せる範囲と、人が判断する範囲を文書で共有することが出発点です。
2. 扱うデータを分類したか
入力するデータ、参照するデータ、出力・保存されるデータを分けて確認します。公開情報、社内情報、個人情報、機微な情報、契約上制限のある情報では、必要な保護が異なります。外部のAIサービスへ送る場合は、保存・学習利用・国外移転・再委託などの条件を公式資料と契約で確かめ、必要に応じて担当部門や専門職に相談します。
3. 権限と期限を小さくできるか
エージェント専用のIDを用意し、共用の管理者アカウントを避けます。読み取り専用から始められるか、対象範囲を限定できるか、認証情報に期限を設けられるか、不要になったときにすぐ無効化できるかを確認します。人の異動やプロジェクト終了に合わせて見直す日程も決めておきます。
4. 承認と停止の手順があるか
メール送信、顧客情報の更新、発注、削除、公開、支払いに関わる操作は、影響の大きさに応じて人の確認を入れます。異常を検知した場合の停止方法、連絡先、復旧手順を、実際に使う人が試しておくことも大切です。「何かあれば止める」ではなく、具体的な権限と手順が必要です。
5. 記録を見直しに生かせるか
誰がいつ設定を変えたか、エージェントがどのツールを使ったか、どの操作が失敗・拒否されたかを追えるようにします。定期的にログを確認する担当と頻度を決め、問題が見つかったら、プロンプトだけでなく権限、接続、手順、教育を含めて原因を見直します。
6. 外部サービスとの境界を説明できるか
AIエージェントは一つのサービス内だけで完結せず、社内の文書保管、顧客管理、メール、クラウド、外部の検索サービスなどをまたいで動くことがあります。そのため、接続先ごとに「何のために接続するのか」「どのデータを渡すのか」「出力をどこへ保存するのか」を説明できる状態が必要です。特に、委託先や取引先の情報を扱う場合は、契約上の利用目的や持ち出しの制限と矛盾しないかを確認します。
接続は増やすよりも、必要性を一つずつ説明できることを優先します。使わなくなった連携は削除し、テスト用の接続が本番に残っていないかも定期的に点検しましょう。利用者から見て「AIがどの情報を使っているか」が分かる説明は、問い合わせや不安への対応にも役立ちます。
YMYL領域では「AIが実行できる」と「任せてよい」は別の話
医療、法律、税務、投資、保険、採用、教育、福祉、行政手続きなどは、誤りが生活や権利、金銭に大きく影響し得る分野です。AIエージェントが情報を集めたり、下書きを作ったり、必要書類の候補を示したりする支援は考えられますが、個別の結論や処分、契約、診断、投資判断をAIの出力だけで確定することは避けるべきです。
たとえば、医療では診断や受診判断を医療専門職と公的・公式情報で確認し、法律や税務では適用される制度や個別事情を有資格者・担当窓口に確かめます。採用では、選考基準、差別の防止、説明可能性、応募者の問い合わせ手段を整えます。金融や保険では、商品選択や契約条件を本人が公式資料で確認できるようにします。AIエージェントの役割を「判断を代替する者」ではなく、人の確認を助ける補助者として置くほど、責任の所在を保ちやすくなります。
また、重要な領域ほど、誤った処理を訂正する経路が必要です。利用者が異議を申し立てられるか、担当者へ到達できるか、誤った記録を修正できるか、影響範囲を通知できるかを設計します。安全性は、エラーをゼロと宣言することではなく、問題を早く見つけ、止め、説明し、直せる状態を作ることに近いものです。
今回のニュースから見える「AIを業務に入れる順番」
IBMの10月27日の発表は、AIエージェントを企業のデータや業務システムへつなぐ前に、ID、権限、可視化、隔離、評価、停止という土台を整える必要性を強調しています。製品の名称や機能は今後も変わっていくでしょう。しかし、誰が所有し、何をさせ、何に触れ、どこに記録が残り、異常時に誰が止めるのかという問いは、どのツールでも残ります。
導入を急ぐほど、「できること」の一覧に目が向きがちです。けれど、長く使える仕組みを作るには、まず影響の小さい業務から試し、権限を絞り、人の承認を残し、記録を見ながら改善する順番が有効です。現場の手間を減らすためのAIが、説明や復旧に大きな手間を生む状態は避けたいところです。
AIエージェントは、うまく設計すれば、情報を探す時間を減らし、定型作業を支え、担当者が本来の判断に集中する助けになります。その価値を持続させる鍵は、AIを万能な担当者として扱うことではなく、役割と境界を明確にし、人が確認・停止・改善できる仕組みを持つことです。新しい機能を試すときこそ、目的、権限、承認、記録、見直しの五つを、チームで一つずつ確かめてみてください。
小さな試行で得た気付きは、次の導入判断を確かにします。AIに任せた工程、任せなかった工程、止めた理由を残し、関係者と共有することが、便利さを安心して広げる土台になります。
焦らず、定期的に見直しましょう。安全が大切です。