2026年11月8日、AP通信は、米商務省のAI評価機関「CAISSI(Center for Advancing Innovation and Standards for Super Intelligence)」をめぐる状況を報じました。報道によると、同機関は常任の責任者が不在で、研究の公開を停止しており、職員がホワイトハウスの部署へ非公式に報告するよう求められたとされています。記事では、こうした運営が評価の独立性に与え得る影響を懸念する見方も紹介されています。
このニュースは、米国の一機関だけの人事や組織図の話に見えるかもしれません。しかし、AIが仕事、行政、教育、医療、金融、情報発信などに入り込むほど、「AIが安全か、役に立つか」を誰が、どんな条件で確かめるのかは、利用者にも関わるテーマになります。便利な機能の説明や企業の自己点検は大切です。一方で、提供する側とは少し距離を置いた評価、異なる立場からの検証、方法と限界を説明する仕組みがなければ、利用者は何を信じ、どこに注意すればよいのか判断しにくくなります。
この記事では、AP報道を出発点に、AIの安全性評価でいう「独立性」とは何かをやさしく整理します。CAISSIの実際の評価内容、今後の組織運営、個別のAI製品の安全性を断定するものではありません。特定の国や組織の政策を支持・批判することが目的でもありません。大事な場面でAIを使う際に、評価結果を読む人が確認したい観点としてお読みください。
11月8日の報道で何が伝えられたのか
AP通信が伝えたのは、米商務省の中に置かれたCAISSIの運営をめぐる報道です。CAISSIは、NIST(米国立標準技術研究所)の公式ページで、商用の高度なAIシステムに関するテストや共同研究を進める、政府内の窓口として説明されています。複数の連邦機関などと協力し、評価手法の開発や評価・査定を行う役割も掲げています。
APの報道では、同機関に常任の責任者がいないこと、研究の公表が止まっていること、職員がホワイトハウスのある部署に非公式の報告を求められたことが記されています。また、AIエージェントが現実の環境でどれほど安全に振る舞うかについて、標準化されたテストの手順がなお十分ではないという専門家の見解も紹介されています。ここで注意したいのは、報道された運営上の状況から、特定の評価結果やAIシステムの危険性を直接導けるわけではない、という点です。
ニュースを読むときは、「組織の独立性が失われた」「評価が無意味になった」といった強い結論へ急がないことが大切です。独立性は白か黒かではなく、責任者の任命、予算、評価計画、データへのアクセス、外部レビュー、報告の公開、異論を記録する手順など、いくつもの要素で支えられます。今回の報道は、その土台が利用者に見えることの重要性を改めて考える材料だと捉えられます。
AIの「安全性評価」は、点数を付けるだけではない
AIの評価と聞くと、正答率やランキングを思い浮かべる人が多いでしょう。たしかに、同じ問題を解かせて正解の割合を比べる方法は、モデルの特徴を知る手掛かりになります。しかし、現実の利用では、点数が高いことだけで安全とは言えません。質問の出し方が少し変わったときに答えが崩れないか、間違えたときにもっともらしく断定しないか、個人情報や機密情報を不必要に扱わないか、外部ツールを動かす場合に権限を越えないか、といった点も確かめる必要があります。
たとえば、予約、購入、メール送信、社内データ検索などを補助するAIエージェントを想像してみましょう。テスト用の予約を正しく作れるとしても、利用者の承認なしに確定してしまう、似た名前の相手へ情報を送ってしまう、例外的な条件を見落とす、といった問題があれば安心して任せられません。評価では、成功例だけでなく、失敗したときに止まるか、迷ったときに人へ確認するか、後から操作を追跡できるかを見る必要があります。
NISTのAIリスク管理フレームワークは、AIのリスクを一度のテストで終わらせず、統治、状況の把握、測定、管理という継続的な仕事として捉えます。これは「完璧なAIかどうか」を判定するための万能な合格印ではありません。目的、利用者、影響、データ、限界を明らかにし、運用中にも見直す考え方です。評価機関の役割は、派手な一つの数値を示すことよりも、どの条件で何を測れたのか、何はまだ測れていないのかを、判断に使える形で示すことにあります。
なぜ評価の独立性が問われるのか
独立性とは、評価する人が誰とも関係を持たないという意味ではありません。AIの技術評価には、開発者、利用企業、研究者、行政、利用者団体などの知識が必要です。ここでいう独立性は、結論があらかじめ決められたり、都合の悪い結果が出しにくくなったりしないように、判断の過程を守るための距離と手順を指します。
第一に、評価の設計を説明できることです。どのような用途を想定し、どんな失敗を試し、どのデータを使い、誰が合格基準を決めたのかが不明なら、結果だけを見ても意味を確かめにくくなります。第二に、望ましくない結果も扱えることです。性能が低い、偏りが見つかった、想定外の操作をした、といった結果を記録し、必要な範囲で公表し、改善へつなげられるかが重要です。第三に、外部からの疑問や再検証を受け止める窓口があることです。
提供企業が行う自己評価は、不要だという意味ではありません。開発段階で最も詳しい情報を持つ企業が、試験、監視、修正を繰り返すことは不可欠です。ただし、自己評価だけでは、検証の範囲や公開する情報が企業の判断に左右されます。そこで、第三者研究者による追試、複数組織が参加する共通テスト、利用者からの問題報告、行政や標準化機関による測定方法の整備などが補い合います。一つの主体にすべてを任せず、異なる視点が重なる状態が、実質的な独立性を支えます。
独立性を支える五つの要素
1. 評価の目的と範囲が先に決まっている
評価は「安全か」という大きな問いだけでは始められません。誰が、どの利用場面で、何を守りたいのかを決める必要があります。子どもが使う学習支援、採用候補者を扱う仕組み、医療情報の案内、企業内の文書検索では、確認するべき危険や影響が異なります。対象を曖昧にしたまま幅広い安全性をうたうと、測っていない領域まで安心だと受け取られるおそれがあります。
良い評価は、対象、対象外、前提条件を併記します。たとえば「この試験は読み取り専用の環境で実施し、外部への送信機能は対象外」と書かれていれば、読み手は結果を過大に解釈しにくくなります。範囲を限定することは弱さではなく、結果の使い方を正確にするための誠実さです。
2. 方法と根拠を後から確かめられる
再現性は、同じ条件で同じような結果が得られるかを確かめる考え方です。AIはモデルの更新、データの変化、入力の違いによって結果が揺れ得るため、完全に同じ結果をいつでも再現するのが難しい場合があります。それでも、評価日時、モデルの版、設定、入力の種類、採点手順、既知の限界を残せば、別の人が検討したり、後日の変化を比べたりしやすくなります。
すべてのテストデータや手順を公開できるとは限りません。公開すれば不正利用を助けたり、個人情報や営業秘密を損ねたりする場合があるからです。その場合でも、「何を非公開にしたか」「なぜ非公開なのか」「誰が確認したか」を説明する余地はあります。公開か秘密かの二択にせず、安全を守りながら検証可能性を残す工夫が問われます。
3. 結果を出す人と意思決定する人の関係が見える
評価担当者が、資金、組織上の指揮命令、成果目標によって結論へ圧力を受ける可能性はないか。これは人を疑うためではなく、制度として考えるべき問題です。利益相反の申告、判断理由の記録、複数の承認者、評価担当への専門的な裁量、異議申立ての経路などは、個人の善意だけに頼らないための仕組みです。
今回のCAISSIをめぐる報道が注目されるのも、評価機関がどこに報告し、どのように研究成果を発信するかが、外からの受け止め方に関わるためです。報告先が変わること自体から、特定の結論を推測することはできません。しかし、組織の役割、意思決定の線、公開方針が明瞭であれば、利用者や研究者は評価をより具体的に読み解けます。
4. 不都合な結果と不確実性を残せる
評価の信頼性は、良い結果を多く並べることだけでは高まりません。失敗例、未評価の領域、測定誤差、評価者間で見解が割れた点を残せるかが重要です。AIは、自然言語や複雑な現実環境を扱うため、想定していなかった使われ方で問題が起きることがあります。「問題なし」と短く書くより、「この条件では重大な問題は確認できなかったが、ここは未検証」と伝えるほうが、利用者は適切に判断できます。
もちろん、脆弱性の具体的な再現手順や、悪用を容易にする情報を無制限に公開すべきではありません。公開の仕方は、被害を広げない配慮とセットです。提供元への連絡、修正までの猶予、影響を受ける人への案内を組み合わせ、必要な情報を適切な時期に共有します。安全性評価における透明性とは、すべてを即時に公開することではなく、説明責任を果たしながらリスクを減らすことです。
5. 利用後も監視・修正できる
公開前の評価を通過しても、実際の利用環境では新しい問題が起こり得ます。利用者の属性、接続するサービス、入力の種類、業務の急な変更など、テストで再現し切れない要素があるからです。そのため、導入後に苦情や事故を受け付ける窓口、問題を調べる担当、緊急停止や権限縮小の手順、更新後の再評価が必要になります。
AIを外部ツールにつなぐ場合は特に、最初から広い権限を渡さず、読み取り専用、検証環境、承認のある操作から始める考え方が役立ちます。操作ログを確認でき、問題が起きたときに止められ、利用者が訂正を求められる状態を作る。評価はリリース前の門番ではなく、運用の中で安全性を保つ循環の一部です。
一般の利用者が評価情報を読むときの四つの質問
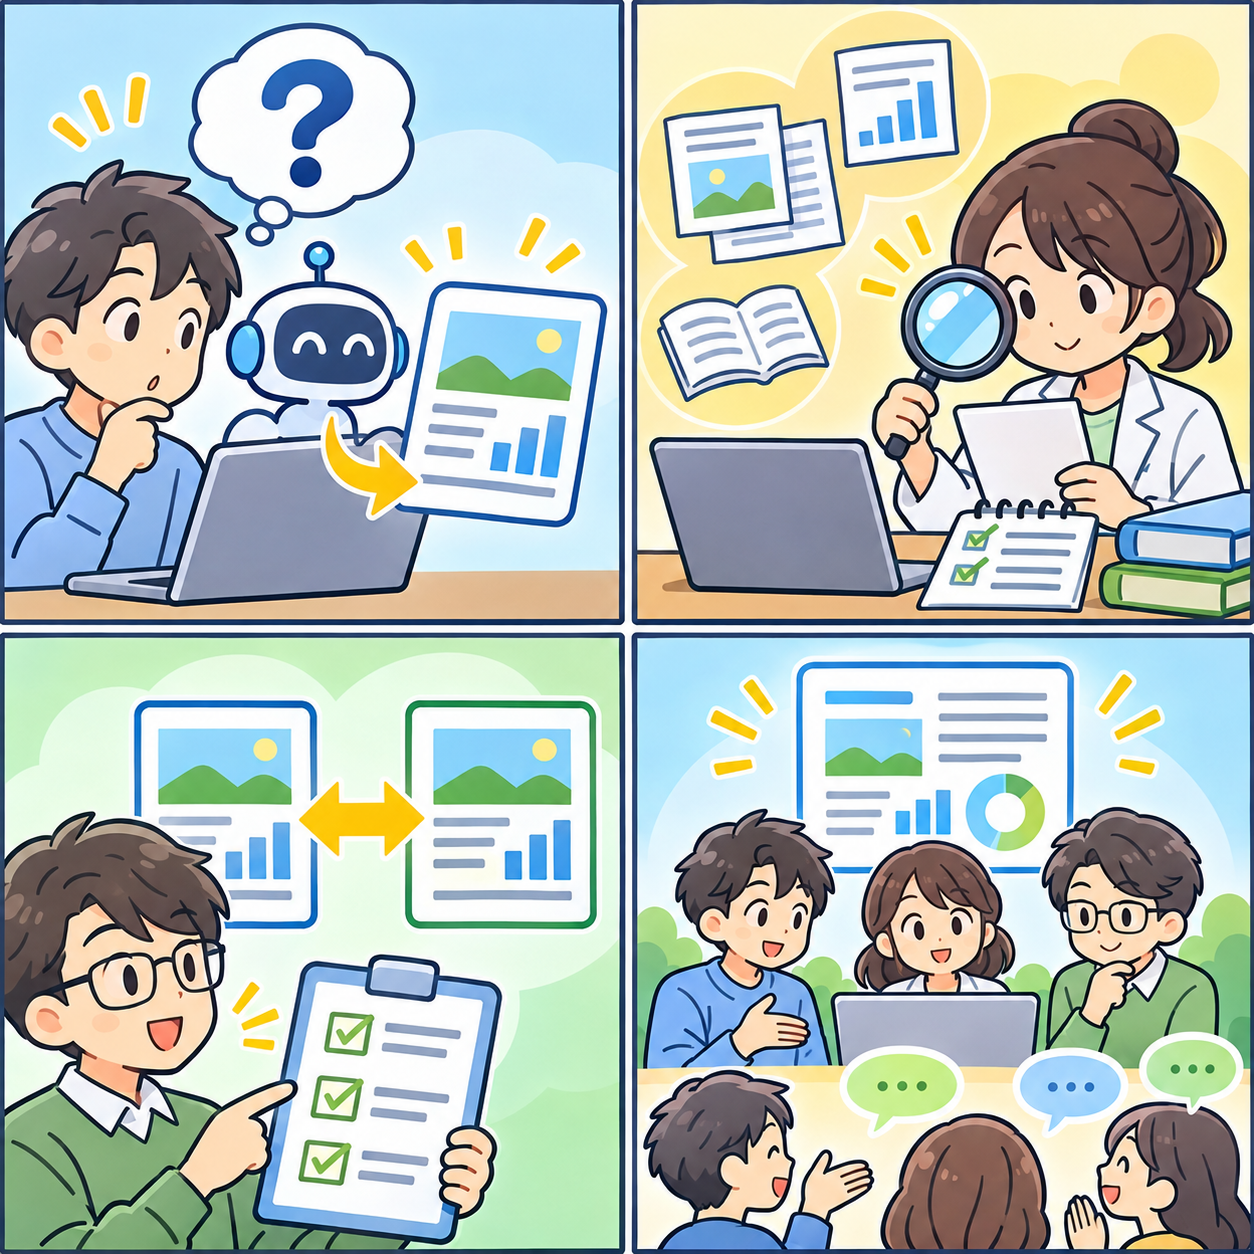
AIサービスの説明ページで「安全性をテスト済み」と書かれていても、それだけで判断する必要はありません。第一に、「何について試したのか」を見ます。誤情報、プライバシー、差別、外部操作、子どもの利用など、関心のあるリスクに触れているでしょうか。第二に、「どんな条件で試したのか」を確認します。実験室だけの結果なのか、実際の利用に近い環境なのかで、受け止め方は変わります。
第三に、「限界や未確認の点が書かれているか」を見ます。完璧さを強調する説明よりも、対象外や注意点が具体的に示されているほうが、利用者は自分の状況と照らせます。第四に、「困ったときの窓口と訂正の道筋があるか」を確認します。誤った内容、意図しない処理、不適切な扱いに気付いたとき、報告先や停止方法が分からなければ、利用者はリスクを減らせません。
重要な判断をAIに任せるときは、特に慎重さが必要です。医療、法律、税金、投資、保険、採用、教育、福祉、行政手続きなどでは、AIの回答や評価情報だけで結論を確定しないでください。公式情報、担当窓口、必要に応じた医療従事者や有資格の専門職など、人による確認を組み合わせることが大切です。緊急性のある健康・安全上の心配がある場合は、AIとの対話を続けるより、地域の緊急通報や医療機関、適切な相談窓口を優先してください。
企業や行政が確認したい実務上のポイント
AIを調達・導入する側は、ベンダーの評価資料を受け取るだけで終わらせず、自分たちの利用条件に引き直して考える必要があります。まず、データの種類と接続先を洗い出します。個人情報、機密情報、認証情報を扱うのか。AIが閲覧だけをするのか、送信、更新、削除まで行うのか。次に、失敗の影響を考えます。誤った提案が出るだけなのか、業務の停止、利用者への不利益、法令・契約上の問題につながるのかで、必要な評価の深さは変わります。
導入前には、小さく試し、人が結果を確認し、異常時の停止手順を試験することが有効です。契約では、モデルや機能の変更通知、ログの保管、インシデント連絡、データ利用、再委託、監査に関する扱いを確認します。評価資料に第三者の関与がある場合でも、その範囲、時点、テスト条件が自社の使い方と一致するとは限りません。「評価済み」という一語を、個別環境での保証と読み替えない姿勢が必要です。
また、評価を担当する部署だけに負担を集中させないことも重要です。現場、情報システム、法務、個人情報保護、セキュリティ、品質管理、利用者対応の担当が、どの問題を誰へ渡すかを共有します。反対意見や利用停止の提案を出しても不利益を受けにくい経路があれば、問題が小さいうちに表面化しやすくなります。これはAIに限らず、複雑な技術を安全に扱うための基本です。
「独立」と「連携」は対立しない
評価の独立性を重視すると、開発企業や行政との連携を避けるべきだと思われることがあります。しかし、実務では両方が必要です。開発者は設計、学習データの扱い、更新予定、既知の弱点など、外部の評価者だけでは得にくい情報を持っています。行政や公共機関は、社会的な影響、制度との整合、複数分野への波及を考える視点を持ちます。利用者や市民団体は、実際の困りごとを早く見つけることがあります。
重要なのは、情報を共有することと、結論を一方が決めることを分ける点です。評価者が必要な情報へアクセスでき、質問や追加検証を求められ、望ましくない結果も記録できること。開発者や依頼者が評価方法と限界を読めること。意見が割れた場合に、少数意見や未解決の論点を消さずに残すこと。このような手順があれば、連携はむしろ評価の質を高めます。
たとえば航空機、医薬品、食品、建築物など、社会への影響が大きい領域では、設計者、検査者、規制当局、現場の利用者が異なる役割を担います。AIはそれらと同じ制度をそのまま当てはめられるわけではありませんが、「作る人」「測る人」「使う人」「ルールを整える人」の役割が一つに溶け過ぎないようにする発想は参考になります。技術の速度に合わせて、情報共有と検証の距離を両立させることが課題です。
評価結果の読み違いを避けるために
評価レポートを読むときには、数字の大きさだけでなく、比較の条件を確認しましょう。たとえば、あるAIが特定の試験で高い成功率を示しても、試験問題が実際の利用より単純であったり、利用者が十分な前提知識を持つ場合だけを想定していたりするかもしれません。反対に、厳しい条件のテストで失敗が見つかったとしても、その失敗がどの利用者に、どれほどの頻度と影響を及ぼすのかは別に調べる必要があります。
「第三者評価」という表現も、内容を確かめる必要があります。第三者が設計に関与しなかったこと、資金源を開示していること、評価対象へのアクセスが十分だったこと、結果の公表を妨げられなかったこと、追試が可能なことなど、独立性には濃淡があります。第三者という言葉だけで自動的に信頼度が決まるわけではありません。反対に、企業内の評価であっても、明確な手順、外部監査、公開可能な記録、異議申立ての仕組みがあれば、読み手が根拠を検討しやすくなります。
また、評価は時間とともに古くなります。AIモデルの更新、接続先の追加、利用規約の変更、利用者層の広がりによって、以前の試験結果がそのまま当てはまらなくなる場合があります。資料に日付や版が記されているか、変更後に再評価する方針があるか、利用中の問題を集めているかを確認することが、最新の状態を知る助けになります。
評価を読む側にも、分からないことを分からないまま残す姿勢が必要です。比較できない数字を無理に順位へ並べず、根拠が不足しているなら追加の説明を求める。導入を急ぐ事情がある場合でも、対象を限定し、見直し日を決め、止める条件を先に置く。こうした小さな手順が、評価結果を現場で安全に生かす力になります。
まとめ:評価を信頼するには、結論より過程を見る
11月8日のAP報道は、米国のAI評価機関CAISSIの運営と独立性をめぐる論点を伝えました。報道された状況だけで、個別のAIや評価制度全体を決めつけることはできません。一方で、AIの安全性を語るとき、誰が評価し、どの条件で測り、結果と限界をどう説明し、異論や問題報告をどう扱うかが重要だと改めて示しています。
信頼できる評価は、便利な結論だけを示すものではありません。目的と範囲を明らかにし、根拠をたどれるようにし、利害関係を見える化し、不確実性を残し、導入後も監視と修正を続けるものです。利用者も組織も、「安全性を確認した」という言葉を入り口にして、評価の過程を尋ねる習慣を持つことができます。AIの能力が高まるほど、結論を急がず、比較・説明・改善の道筋を保つことが、安心して使うための土台になります。