Googleは2026年11月9日、第8世代のTPU(Tensor Processing Unit)に二つの新しいシステム、「TPU 8tx」と「TPU 8i Max」を加えたと発表しました。TPUは、AIの学習や推論に使う計算基盤です。今回の発表でGoogleが強調したのは、機密性の高いデータを扱う推論と、非常に長い文書・コード・映像の文脈を扱う処理という、AIを業務に取り入れる際に目立ってきた二つの課題でした。
一つは、金融、行政、研究、製造などで扱う情報を、AIの処理中もどう守るかという課題です。もう一つは、AIエージェントが長い契約書、ソフトウェアのコードベース、会議記録、複数の資料をまたいで作業するとき、必要な情報を途切れずに扱えるかという課題です。いずれも、AIが「賢い」だけでは解決しません。データを何に使うのか、誰がアクセスできるのか、どこで人が確認するのかまで含めて設計する必要があります。
この記事では、Googleの発表内容を整理したうえで、機密AIや長文処理という言葉を過大に受け取らず、業務で確認したいポイントを分かりやすくまとめます。Googleが示す性能や機能は同社の発表に基づくものであり、すべての組織・用途で同じ速度、費用、安全性、導入効果を保証するものではありません。
TPUとは何か:AIを動かす「計算基盤」の話
TPUはGoogleが開発してきたAI向けのプロセッサー群です。一般的なパソコンのCPUや、画像処理・AI処理でよく使われるGPUと同じく、計算を担う部品ですが、AIモデルの学習や推論で繰り返される計算を効率よく扱うことを目的に設計されています。ここでいう推論は、学習済みのAIに文章要約、検索支援、画像の分類、コード補助などを実行させる段階を指します。
利用者から見れば、「AIの答えを速く返すための裏側の仕組み」と考えると分かりやすいでしょう。ただし、基盤の性能が上がることと、AIの答えが必ず正しくなることは別の話です。計算基盤は待ち時間、扱えるデータ量、消費電力、運用コスト、セキュリティの選択肢に関係します。一方で、回答の正確さは、モデル、入力、参照するデータ、指示、評価方法、人の確認などにも左右されます。
Googleによると、第8世代TPUでは、先に大規模学習向けの「TPU 8t」とリアルタイム推論向けの「TPU 8i」を発表していました。今回追加されたTPU 8txとTPU 8i Maxは、新しいチップそのものというより、既存のシリコンを含む計算、ネットワーク、メモリー、ホストCPU、セキュリティを組み合わせた「システム」の選択肢として説明されています。この違いは重要です。半導体の世代交代を待たなくても、AIの使い方に合わせて周辺を組み替えることで、必要な性質に近づけるという考え方だからです。
ここで、一般の利用者が自社の端末を買い替える必要がある、と受け取る必要はありません。今回の発表は主にクラウドや大規模なAI基盤を利用する組織に関わるものです。企業や開発者がAIサービスを選ぶ際には、そのサービスの背後にどの計算基盤があるかよりも先に、契約条件、保存場所、入力データの扱い、利用権限、障害時の対応、費用体系を確認するほうが実務では役に立ちます。
発表の要点:8txは機密性、8i Maxは長い文脈を意識
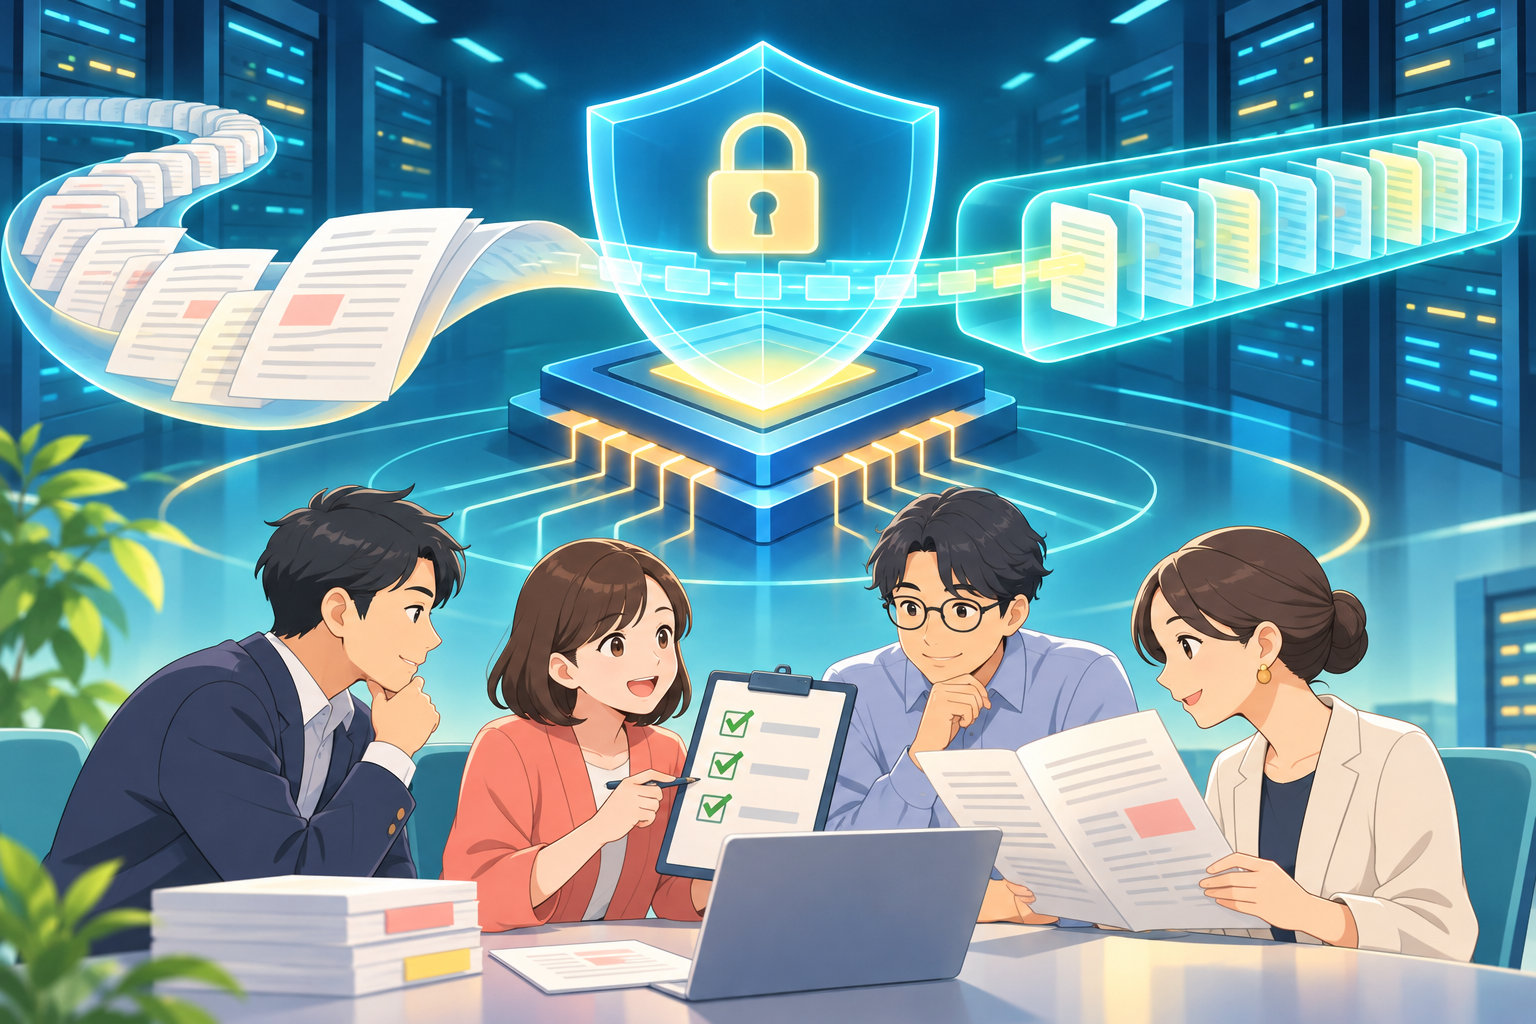
Googleの11月9日付の公式発表では、TPU 8txを「安全で機密性の高い推論」と小規模学習に最適化したシステム、TPU 8i Maxを「大規模なコンテキストウィンドウ」とラック当たりの高い計算密度を狙うシステムとして紹介しています。分かりやすく言えば、8txは扱う情報を守りながらAIを実行したい場面、8i Maxは多量の前後関係を保ちながらAIを動かしたい場面を意識した設計です。
8txについてGoogleは、通常は保存中やネットワーク通信中に暗号化されているデータも、コンピューターが処理する際にはメモリー上で扱われる点に触れ、処理中のデータとモデルの重みを保護・隔離するためのハードウェア層の機能を掲げています。規制対応が必要な組織や、独自モデルと機密データを扱う組織を想定した説明です。同社はTPU 8tと比べて最大2倍低いレイテンシーをうたいますが、これはGoogleの比較条件に基づく数値であり、アプリケーション、ネットワーク、モデル、同時利用数、データの準備方法によって実際の体感は変わります。
8i Maxについては、二つのTPU 8iを一つのパッケージに組み合わせ、8iに比べて計算能力、SRAM、HBM帯域をそれぞれ2倍にすると説明されました。SRAMやHBMは、AIが次の計算に必要な情報を素早く出し入れするための高速なメモリーに関係します。長い資料を読ませたり、多数のAIエージェントが同じプロジェクトを参照したりする場面では、計算能力だけでなく、必要な情報を待たせずに供給できるかがボトルネックになりやすい、とGoogleは説明しています。
この二つを並べると、「安全なAI」と「長文を読めるAI」が一つになったようにも見えます。しかし、製品や構成の選択と、業務ルールの選択は切り分けるべきです。8txを選んだからといって、誰でも社内文書を入力してよいことにはなりません。8i Maxを使えるからといって、大量の資料を一度に渡すことが最善とは限りません。目的、データ分類、権限、確認責任を決めないまま、基盤の能力だけを頼りに範囲を広げることは避けたいところです。
「機密計算」は何を守り、何を守らないのか
機密計算という言葉は、聞こえ方が強いため「これで情報漏えいは起きない」と受け取られがちです。ですが、現実の安全性は一つの部品だけで決まりません。処理中のデータを保護する仕組みは重要な層の一つですが、入力する前、処理を依頼する人、出力を受け取る人、保存されたログ、権限の設定、外部との連携など、守るべき場所は複数あります。
たとえば、従業員が顧客名簿、診療情報、未公開の決算資料、採用候補者の情報を、利用が許可されていないAIサービスへ貼り付ければ、処理中の保護だけでは問題を解決できません。まず「何を入力してよいか」「どのサービスならよいか」「誰が承認するか」を決める必要があります。共有リンクの設定ミス、退職者アカウントの残存、画面のスクリーンショット、端末の紛失、外部ツールへの自動送信も、別の経路で起こり得ます。
また、暗号化や隔離は、AIの内容上の誤りを防ぐ機能ではありません。契約書を要約するAIが条項を読み落とす、調査資料に存在しない出典を付ける、顧客対応の文面が意図と異なる、といった問題は、計算基盤の保護とは別に起こり得ます。機密性と正確性、可用性、公平性、説明可能性は、関連はしても同じではありません。安全という言葉を一つにまとめず、どのリスクに何の対策を置くのかを分けて考えることが大切です。
特に、医療、法律、税務、投資、保険、雇用、教育、福祉、行政手続きなど、個人の権利・健康・財産に影響する領域では、AIが出した説明や自動処理だけで結論を確定してはいけません。公式情報、担当窓口、資格を持つ専門職、組織内の責任者による確認が必要です。AIに資料の整理や質問の下書きを任せることはあっても、最終判断の責任や異議申し立ての窓口までAIへ渡さない設計が求められます。
長いコンテキストが役立つ場面と、過信しないための工夫
コンテキストとは、AIが一度の処理や会話の中で参照する前後関係や情報の範囲です。長いコンテキストを扱えると、分割された資料を何度も貼り直す負担が減ったり、複数の議事録と仕様書を比較しやすくなったりする可能性があります。ソフトウェア開発であれば、大きなコードベース、仕様変更の履歴、テスト結果を関連付ける用途が考えられます。研究や調査では、多数の資料から論点の候補を出す補助にも使えます。
一方、文脈に入れられる量が増えても、AIがすべてを同じ精度で理解し、重要度を正しく判断する保証はありません。長い資料の中には古い版、重複、例外規定、機密情報、誤記、権限の異なる内容が混ざることがあります。大量に渡せるからといって、整理せずに投入すると、かえって根拠を追いにくくなり、不要な情報まで扱わせることになります。
実務では、まず資料の目的と版をそろえることが有効です。「最新版の運用手順だけを比較する」「この四半期の会議記録から決定事項だけを抽出する」「公開済みの技術文書に限定する」といった範囲を決めます。AIへの依頼も、単に「全部要約して」ではなく、「根拠となるページ番号や文書名を併記し、不明な箇所は不明と示す」「結論と推測を分ける」「原文にない補完をしない」と具体的にします。
長いコンテキストは、AIに判断を委任するためのものではなく、人が確認すべき情報を見つけやすくするための補助と捉えるのが安全です。重要な要約は原文に戻って照合する。提案された変更はテスト環境で検証する。契約・人事・医療のような影響が大きい文書では、担当者が原資料を読む。この基本を省略しないことが、処理能力が上がるほど重要になります。
AIエージェントを使うなら、権限と停止方法を先に決める
Googleの発表は、複数の手順をまたぐAIエージェントの利用拡大にも触れています。AIエージェントは、質問に答えるだけでなく、検索、データベース照会、ファイル作成、チケット登録、コード修正などを連続して実行する仕組みを指すことがあります。長い文脈や低い待ち時間が役立つ場面がある一方、できる操作が増えるほど、誤操作が及ぼす範囲も広がります。
導入前に確認したいのは、「何ができるか」より「何をさせないか」です。たとえば、閲覧は許可しても削除は許可しない、下書きは作れても送信は人の承認を必要とする、テスト環境だけで実行する、金銭の支払い・雇用判断・契約締結は自動化しない、といった境界を先に決めます。権限は役割ごとに最小限にし、広い管理者権限を常時渡さないことが基本になります。
次に、実行の記録と停止方法です。いつ、誰の指示で、どのデータにアクセスし、どんな操作をし、どの結果を返したかを追える形にしておくと、問題が起きた際に影響範囲を確認できます。異常な入力、想定外の出力、過剰なアクセス、費用の急増があったときに、速やかに処理を止め、権限を取り消し、人が引き継げる手順を用意します。便利な自動化ほど、止める練習と復旧手順が必要です。
「機密の計算基盤だから、エージェントに広い権限を渡しても大丈夫」という考え方は危険です。基盤の保護、ID管理、アクセス制御、承認フロー、監査ログ、教育、事故対応は互いに補い合うものです。米国国立標準技術研究所(NIST)のAIリスク管理フレームワークも、AIのリスクを導入時だけでなく、管理、把握、測定、対処という循環で扱う考え方を示しています。組織の規模にかかわらず、使い始めた後に見直す前提を持つと、導入の判断が現実的になります。
導入前に確認したい七つの項目
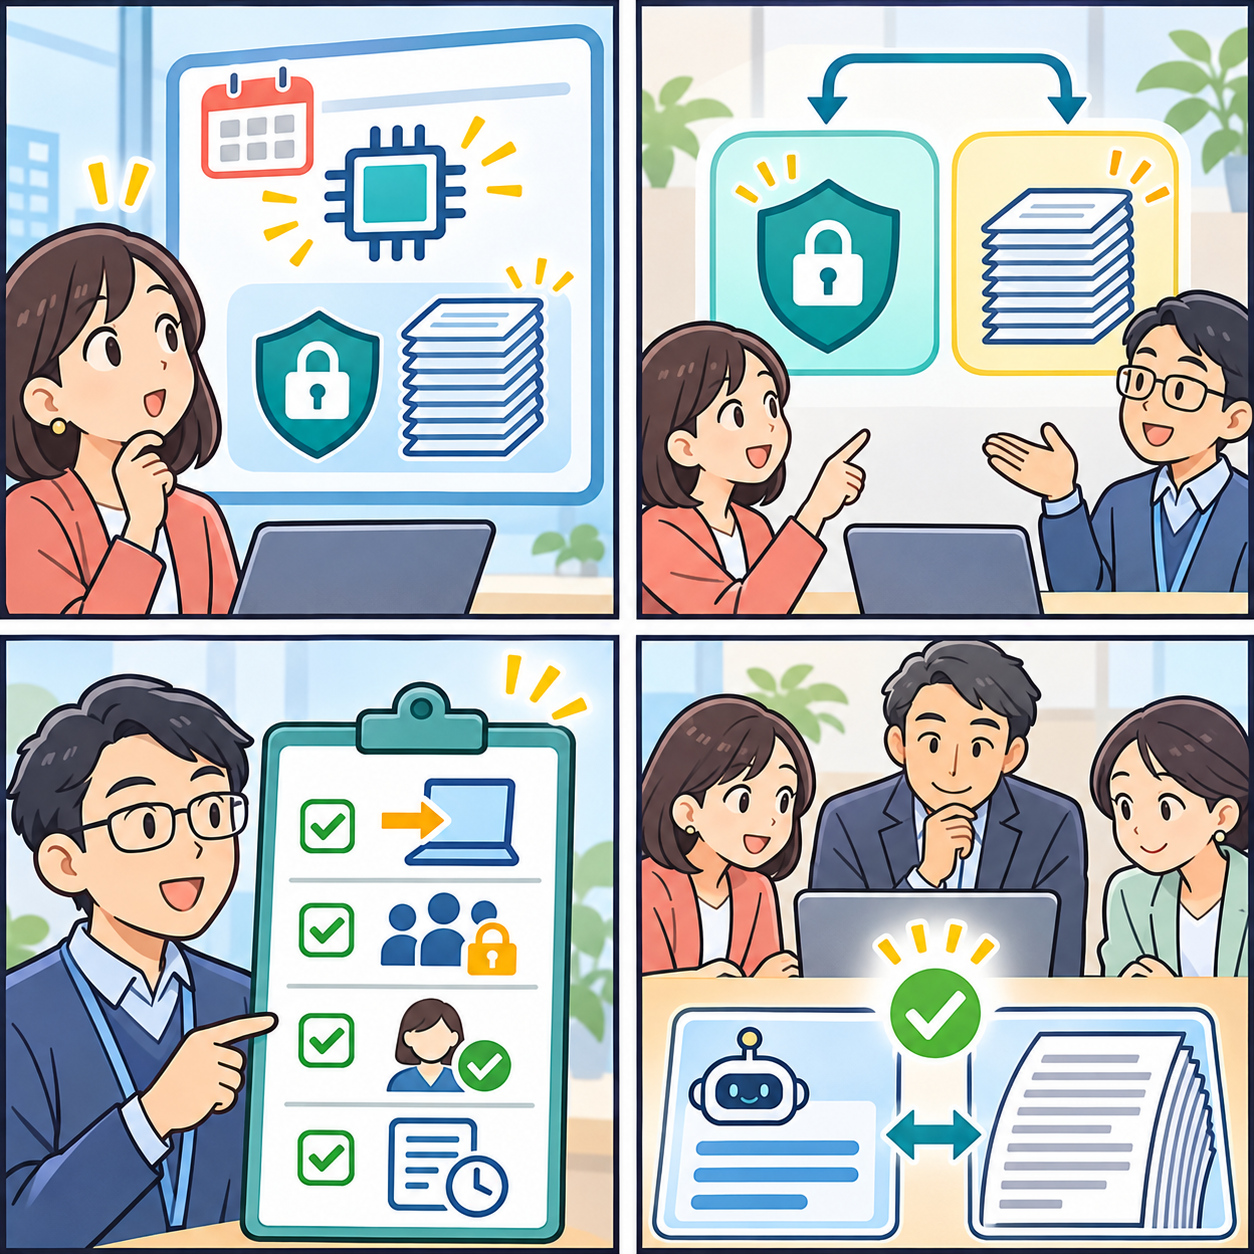
新しいAI基盤やAIサービスを評価するときは、性能表だけで比較しないことが重要です。次の七つを、導入担当、情報システム、現場、法務・セキュリティなど関係者で確認すると、見落としを減らせます。
1. **目的と利用者**:何の作業を短くしたいのか、誰が使うのかを具体的にします。「AIを導入する」ではなく、「公開済みマニュアルから社内問い合わせの下書きを作る」のように対象を絞ります。
2. **データの分類**:公開情報、社内限定、個人情報、営業秘密などを分け、AIへ渡してよい範囲を定めます。利用規約や委託先、保存地域も確認します。
3. **権限と連携先**:閲覧、編集、送信、削除、外部連携を分け、必要最小限の権限にします。APIキーや共有アカウントの管理も含めます。
4. **出力の検証**:回答の根拠を示せるか、原資料に戻って確認できるか、誤りを訂正する担当は誰かを決めます。重要な文書は二重確認を置きます。
5. **人の承認**:顧客への送信、支払い、契約、採用、診療、評価など、影響の大きい操作をAIだけで完了させない境界を決めます。
6. **記録と監視**:入力・出力・操作・設定変更を、個人情報や機密の取り扱いに配慮しつつ記録します。利用量、失敗、例外、苦情を定期的に見ます。
7. **停止と相談**:異常時に誰が止め、どこへ報告し、利用者がどう相談するかを決めます。事故を責めるだけでなく、再発を防ぐ見直しにつなげます。
七つすべてを最初から完璧にそろえるのが難しい場合もあります。そのときは、公開情報だけを使う小さな検証から始め、操作範囲を狭くし、結果を人が全件確認する形にします。効果とリスクが見えてから、対象データや連携を段階的に広げるほうが、後から取り返しのつかない設定を避けやすくなります。
コストと環境への視点も忘れない
高性能なAI基盤は、単に速くなるためだけの話ではありません。利用量に応じて計算資源、ストレージ、ネットワーク、監視、運用人員の費用が変わります。特にエージェントが長い処理を繰り返したり、大量の資料を毎回読み込んだりすると、予想を超える利用量になることがあります。見積もりでは、モデル利用料だけでなく、データの準備、ログ保管、検証、障害対応、教育にかかる時間も含めて考えましょう。
Googleは8i Maxについて、既存のラック設置面積や電力当たりで多くの計算能力を配置できると説明しています。ただし、特定の構成の効率が、個別の企業全体の電力使用量や環境負荷を直ちに下げるとは限りません。処理量が増えれば、総消費量が増える可能性もあります。環境への影響を考えるなら、待機中の処理を止められるか、不要な再実行を減らせるか、用途に対して過大なモデル・文脈を使っていないかも確認の対象です。
費用の上限を設定し、利用量の急増を知らせる通知を置き、試験環境と本番環境の予算を分けるといった実務的な対策も役立ちます。AIが便利だからといって、無制限に資料を投入し続けるのではなく、必要な範囲へ整理して渡すことは、情報管理とコスト管理の両方につながります。
日本の利用者が受け取れるヒント
今回のGoogleの発表は、主にクラウドのAI基盤を利用する組織向けです。日本の一般的な利用者の端末にすぐ新しい機能が追加されるという話ではありません。しかし、「AIを使えるか」から「どの情報を、どの条件で、誰の確認のもとで使うか」へ議論が移っていることを知る材料にはなります。
職場で生成AIを使う人は、まず自分が扱う情報の区分を確認してください。公開済みの文書、個人情報、取引先から預かった情報、未発表の企画、ソースコードでは、許可される入力先が異なる可能性があります。ルールが分からないときは、推測で入力せず、情報システム部門や責任者に尋ねましょう。便利な要約機能であっても、入力した時点で外部サービスへ送られる場合があります。
個人で使う場合も、AIに渡す内容を整える習慣が役立ちます。住所、連絡先、健康情報、口座情報、他人の画像や会話、勤務先の非公開情報は、安易に貼り付けないこと。長い資料を扱うなら、公開してよい版だけを選び、原文を保管し、AIの要約と見比べること。重要な連絡や申請を作るなら、送信前に自分か信頼できる人が読み直すこと。こうした小さな手順が、技術の変化に左右されない安全策になります。
まとめ:基盤の進化を、人の確認を強くする機会に
Googleが発表したTPU 8txとTPU 8i Maxは、AIがより機密性の高いデータや、より長い文脈を扱う方向へ進んでいることを示すニュースです。8txは処理中のデータ保護を意識した機密推論、8i Maxは長い文脈と高い計算密度を意識した構成として説明されています。性能や提供条件は今後も変わり得るため、導入を検討する際は必ず公式の最新情報、契約条件、実測結果を確認してください。
大切なのは、計算基盤が進化しても、情報を渡してよいか、出力を信頼してよいか、どの操作に人の承認を置くかという問いがなくならないことです。機密計算は安全設計の一部であり、入力ルール、最小権限、記録、停止、原資料の照合と組み合わせて初めて力を発揮します。AIに任せる範囲を少しずつ広げながら、人が確認し、必要なら止め、訂正できる状態を保つ。それが、AIの基盤を実務で役立てるための現実的な出発点です。