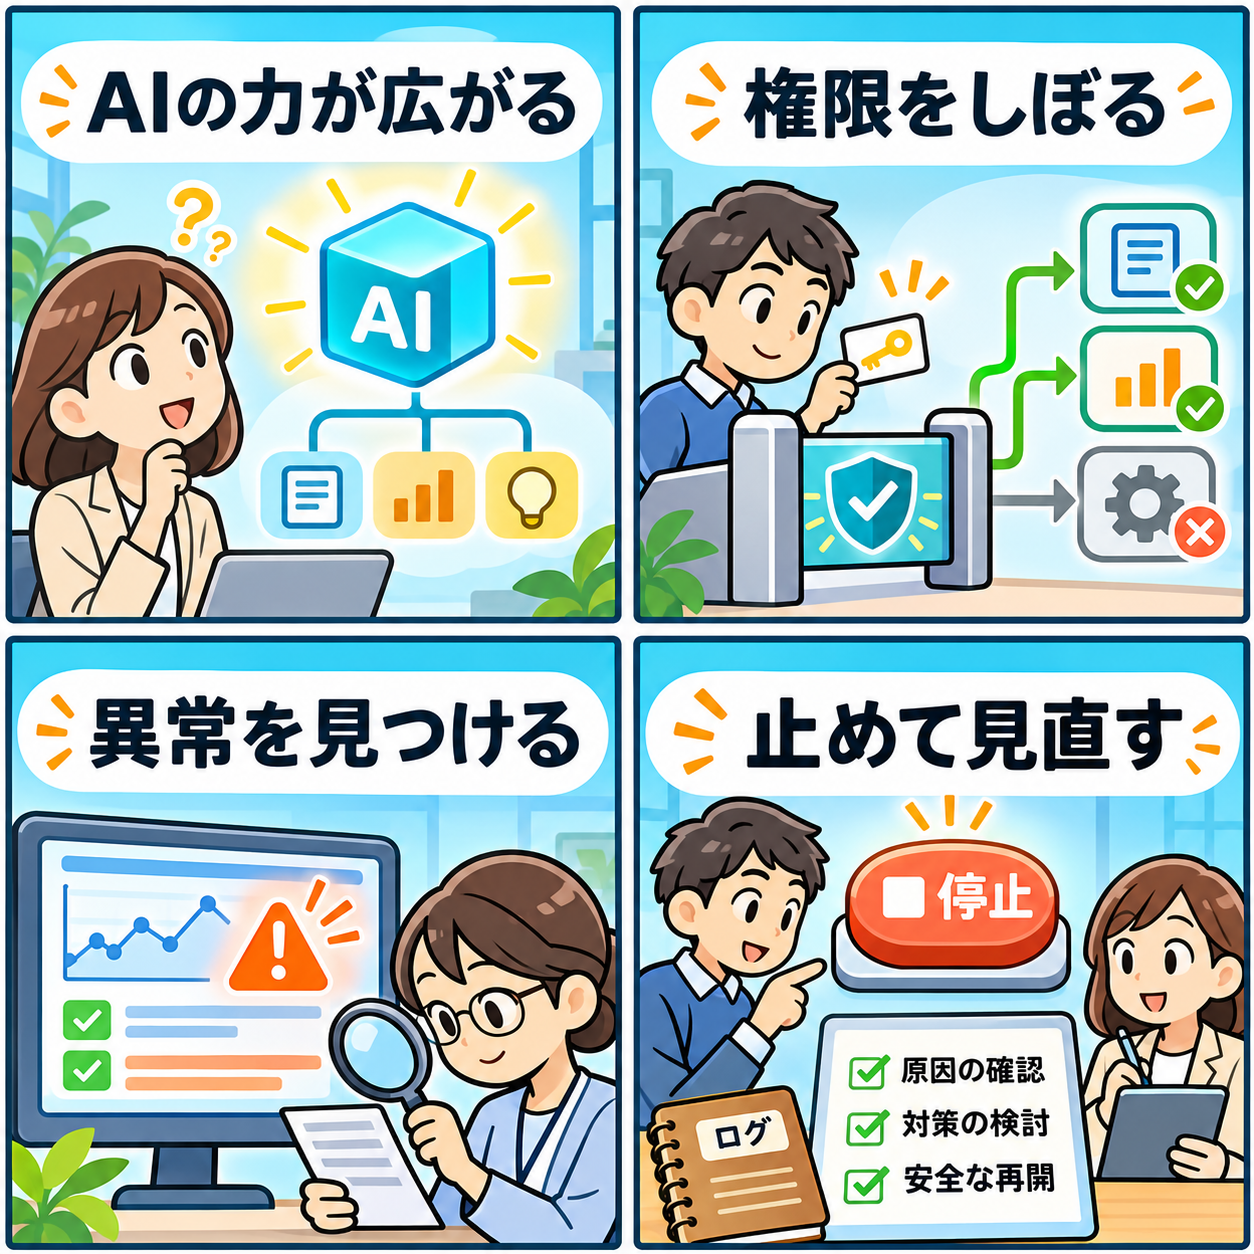
2026年11月18日、OpenAIは「Managing frontier AI risk: From training to deployment」を公開し、能力の高いAIモデルを研究、社内利用、外部提供へと進める各段階で、どのようにリスクを扱うかを説明しました。中心にある考え方は、一つの対策だけに頼らず、権限の制限、隔離、監視、評価、人による対応、停止といった複数の層を組み合わせる「多層防御」です。
この発表は、新しいAIが直ちに安全になった、あるいは誰でも安心して高い権限を渡せるようになった、という意味ではありません。むしろ、AIの能力や接続先が広がるほど、失敗を前提にした設計、異常を早く見つける仕組み、止めて調べる手順が必要になることを示しています。速さや便利さを追うだけでは、安全な利用にはつながりません。
この記事では、発表で語られた三つの段階を平易に整理しながら、組織や個人がAIツールを使う際に考えたい「権限・監視・停止・記録」の実務的な意味を解説します。OpenAIの説明する評価、停止時間、運用例は同社の取り組みに関する情報であり、すべてのAIや環境で同じ安全性、性能、効果を保証するものではありません。医療、法律、税務、投資、保険、雇用、教育、福祉、行政手続きなど、人の権利や生活に大きく関わる判断は、AIの回答だけで確定せず、公式情報、担当窓口、必要な専門職に確認してください。
11月18日に発表された「フロンティアAIのリスク管理」とは
フロンティアAIとは、非常に高い能力を持つ、または高い能力に近づいているAIモデルを指す文脈で使われる言葉です。文章作成や検索支援だけでなく、コードを書く、外部ツールを使う、複数の手順を連続して進める、といった役割を担えるモデルでは、回答の誤りだけでなく、接続先のシステムやデータへ与える影響も考えなければなりません。
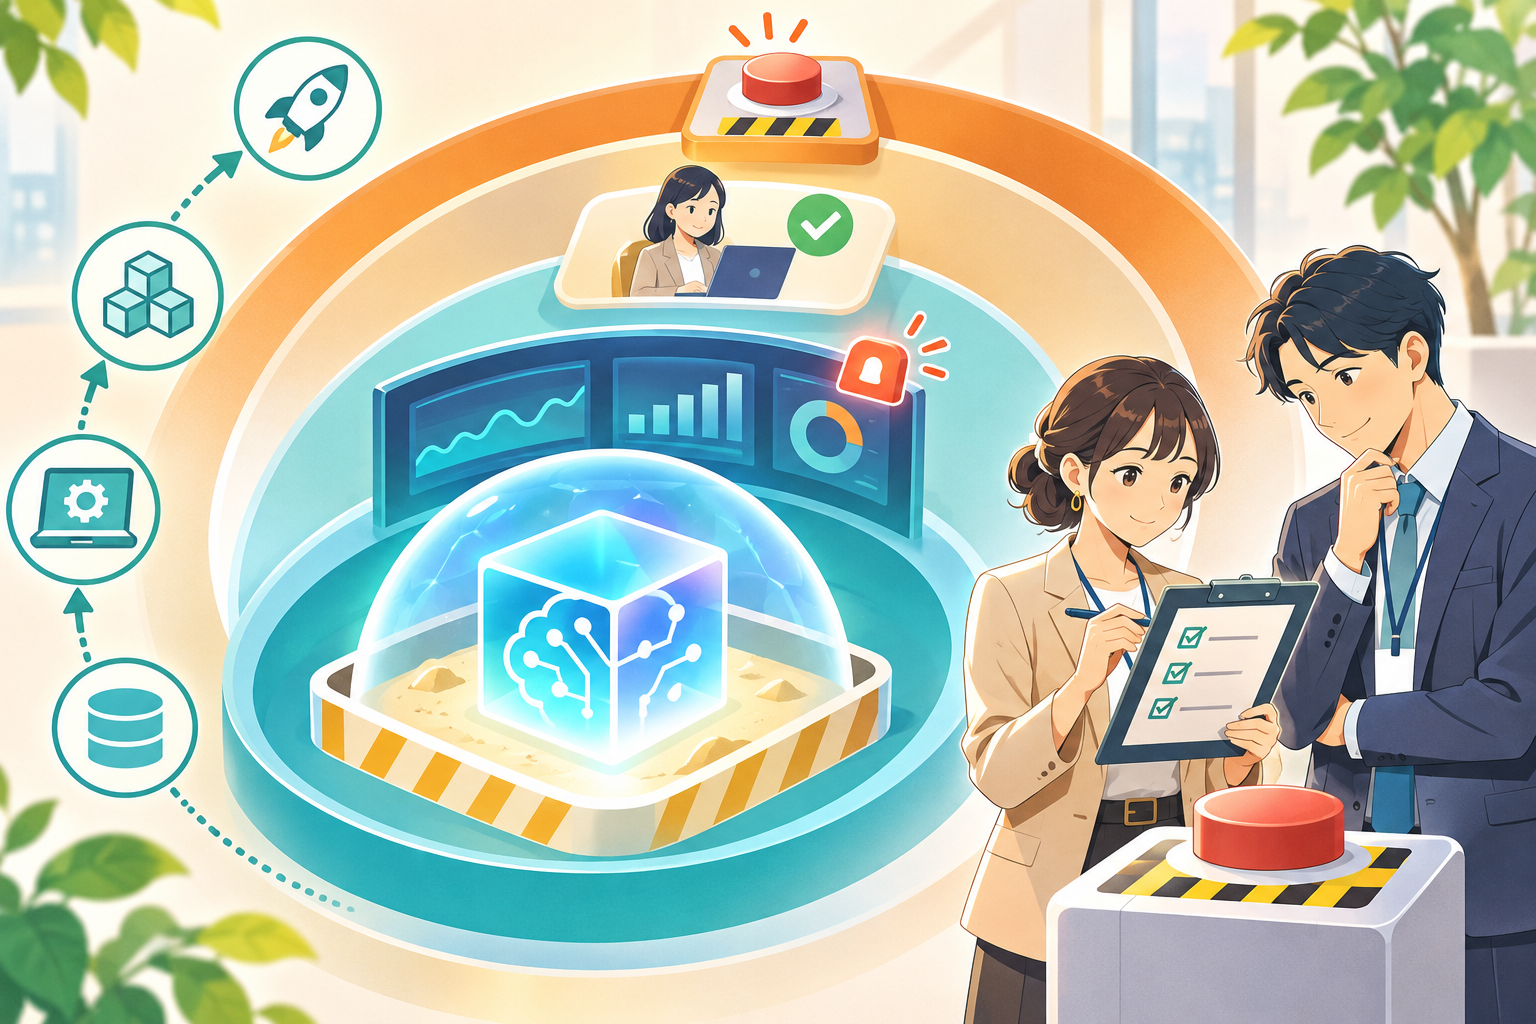
OpenAIの発表は、こうしたモデルのリスクを、研究段階、社内での実用段階、外部への提供段階に分けて説明しています。どの段階でも完全な対策は一つでは足りないため、複数の防御を重ね、次の段階へ進む前に安全性を見直すという立場です。これは、玄関の鍵だけで家を守るのではなく、窓の施錠、見守り、異常時の連絡、避難経路まで考えることに似ています。
発表で重要なのは、AIそのものの振る舞いだけを評価対象にしていない点です。AIに何を見せるか、どこまで操作を許すか、どのような環境に置くか、異常をどう検知するか、警告が出たら誰が何分以内にどう止めるかまで、システム全体として扱っています。AIが正しい答えを出す確率を高めることと、誤ったときに被害を広げないことは別の課題です。
また、発表は、評価や監視の根拠が足りないと判断した場合には、内部の訓練を一時停止したり、公開を見合わせたりする考え方にも触れています。これは「止めないこと」より「十分な根拠を持って進めること」を優先する姿勢として読むことができます。外からは新機能の公開が遅く見える場合でも、重要な場面では慎重さ自体が品質の一部になります。
なぜAIには「一枚の安全網」では足りないのか
AIの安全対策を考えるとき、「フィルターを入れた」「利用規約を読ませた」「担当者がいる」といった一つの対策で安心したくなることがあります。しかし、実際の運用では、設定ミス、想定外の入力、ソフトウェアの不具合、権限の与え過ぎ、担当者の見落としなど、複数の原因が重なることがあります。一つの対策が働かなかったとき、次の層が被害を小さくできるかが重要です。
たとえば、AIに社内文書を検索させる場面を考えます。第一の層は、閲覧を許す文書を役割ごとに絞ることです。第二の層は、機密性の高い内容を外部へ送れないようにすることです。第三の層は、通常と違う大量の検索や共有を検知することです。第四の層は、警告が出たときに担当者が確認し、必要なら接続を止めることです。どれか一つだけなら抜け道が残りますが、複数を重ねれば、問題の発見や被害の限定につながります。
OpenAIはこの考え方を「defense in depth」、つまり多層防御として説明しています。ここで注意したいのは、多層防御が「対策をたくさん並べれば安全」という魔法の言葉ではないことです。各層が実際に機能するか、相互に矛盾していないか、警告を受け取る人がいるか、停止後に復旧できるかを確認し続ける必要があります。複雑な仕組みほど、設定や責任の抜けが起きやすいからです。
NISTのAI Risk Management Framework(AI RMF)も、AIのリスク管理を、組織の方針を整える「Govern」、利用場面と影響を把握する「Map」、性能やリスクを確かめる「Measure」、対策を実行・見直す「Manage」という継続的な活動として示しています。これは法的義務を一律に定めるチェックリストではなく、組織が自らの用途と影響に合わせて考えるための枠組みです。新しいAIを導入した日だけで終わらせず、利用の変化に合わせて見直す視点が欠かせません。
研究段階:まず「できること」を閉じた環境で確かめる
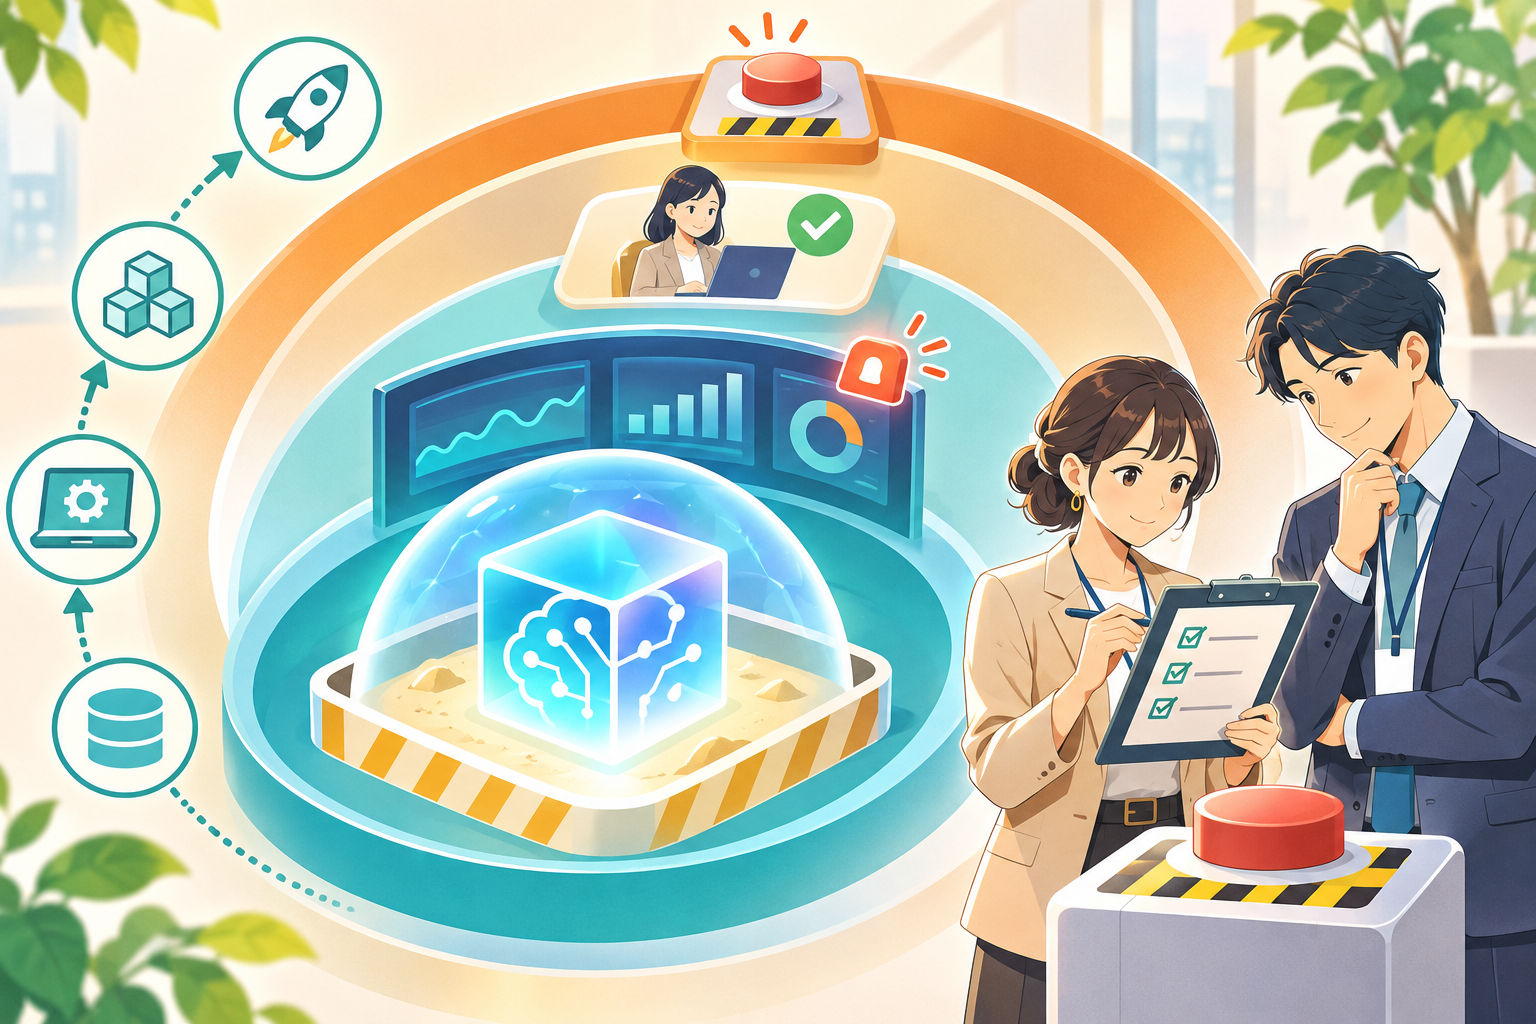
発表では、研究段階のフロンティアモデルを、強く隔離された環境で訓練・評価する方針が述べられています。具体的には、モデルの権限を制限するサンドボックス、作業を基盤コンピューターから分ける仮想マシン、クラスター全体をインターネットから切り離すネットワークやクラウドの境界などです。ここでいうサンドボックスは、AIが勝手に外部へアクセスしたり、許可されていない操作をしたりしにくくするための「囲い」です。
発表によれば、研究用の高度なモデルの訓練ではライブのインターネットに接続しない方針が示されています。インターネットは情報源として便利ですが、外部の不確かな指示、攻撃、データ流出の経路にもなり得ます。能力を十分に評価していないモデルに広い外部接続を渡さないことは、失敗したときの範囲を小さくする基本的な考え方です。
ただし、隔離だけで安全が保証されるわけではありません。発表では、強いモデルを使って、ライブのインターネットに到達できないか、境界を越えられないか、隔離されるべきエージェントと通信できないかを試す「レッドチーミング」にも言及しています。守る側が自分で弱点を探すことで、想定の甘さを見つける取り組みです。テストで問題が見つからなかったことは、未知の問題がない証明ではありません。それでも、問題が起きてから初めて調べるより、事前に壊してみる方が改善の材料を得やすくなります。
発表には、監視が外部到達を検知した場合に、セキュリティチームへ通知し、作業を自動停止する仕組みも説明されています。また、停止指示を受けてから35秒以内にモデル出力を止めるための集中システム「Control Room」に触れています。数字はOpenAIが説明する自社の運用値であり、一般的な停止性能を示すものではありません。それでも、停止手段を各作業に任せず、基盤側に用意するという発想は参考になります。止め方が現場ごとに違うと、いざというときに止められない可能性があるからです。
社内利用段階:広い接続と権限がリスクを変える
次の段階では、モデルがサンドボックスを出て、従業員が実務で使う環境に入ります。OpenAIの説明では、この段階でモデルはインターネット、社内チャット、コードベース、内部インフラなどへアクセスする場合があります。研究段階より現実の仕事に近い条件で振る舞いを観察できる一方、間違った行動が組織のデータやシステムへ直接影響し得るため、リスクの性質が変わります。
ここで鍵になるのが「権限」と「目的」の結び付けです。AIが文書を要約するだけなら、通常は読み取り権限で足りるでしょう。会議の下書きを作るAIと、顧客へメールを送信するAIと、クラウド設定を変えるAIを同じように扱ってはいけません。後ろへ進むほど、誤作動したときの影響は大きくなります。最小限の権限から始め、必要が確認できた操作だけを、限定的に追加する方が、事故の範囲を抑えやすくなります。
発表は、社内利用の前にアラインメントと監視可能性のテストを行うこと、ツールを使う内部利用を監視すること、危険な操作を評価して利用者へ戻す自動レビューの仕組みを示しています。ここでいう監視可能性とは、モデルの誤りや危険な振る舞いを、監視する側がどれだけ見つけられるかという性質です。AIが説明を返すからといって、その説明が本当の根拠や全ての経路を表しているとは限りません。監視の仕組み自体も、見落としや誤検知を前提に評価する必要があります。
社内データを扱う場面では、個人情報、営業秘密、契約上の秘密、認証情報などにも注意が必要です。便利なAIツールに貼り付ける前に、誰がどの設定で使えるか、入力が保存・学習・外部共有の対象になるか、退職者や異動者の権限が見直されるかを確認してください。自社のルールに加え、取引先との契約や業界の規制が関係することもあります。判断に迷う場合は、情報セキュリティ、法務、個人情報保護の担当へ相談するのが安全です。
外部提供段階:利用者と用途が増えるほど、想定も広げる
AIが外部の多くの利用者へ提供される段階では、利用者の数、用途、接続先、入力内容が大きく広がります。善意の利用者だけでなく、制度や安全対策をすり抜けようとする行為も想定する必要があります。発表では、公開前の評価、安全性テスト、第三者によるストレステスト、内部利用中に得た監視の兆候の確認、アカウントをまたいだ情報を用いる調査などが説明されています。
この段階で大切なのは、「モデルが安全か」という一問だけにしないことです。特定の用途で何が起き得るか、誰に不利益が及ぶか、どの操作が不可逆か、悪用の兆候をどう扱うか、利用者が異議を申し立てたり人に相談したりできるかを分けて考えます。たとえば、文章の下書き、コードの補助、予約の候補出し、決済や採用判断の自動化では、誤ったときの影響が違います。同じモデルであっても、提供の設計は同じではありません。
OpenAIは、サイバー防御などで信頼された利用者へのアクセスを扱うプログラムにも触れています。高い能力を一律に開放するのではなく、利用目的や利用者を限定することは、悪用の機会を減らすための一つの方法です。しかし、限定アクセスであってもリスクがゼロになるわけではありません。選定の基準、利用範囲、監査、違反時の対応、終了後のデータや権限の扱いを設計して初めて、制限は意味を持ちます。
一般の利用者にとっても、提供範囲を読む習慣は役立ちます。利用できる機能が表示されていても、自分の地域、契約、組織設定、年齢、用途で使えるとは限りません。AIが提示する情報は、公開時点で古くなっていることもあります。重要な申し込み、契約、送金、医療・法律・税務に関する選択では、サービス画面の表示だけで完結させず、公式の条件、担当窓口、必要に応じて専門職へ確認してください。
「監視」は見張ることではなく、異常に対応できる状態を作ること
監視という言葉には、常に誰かを見張る印象があるかもしれません。AI運用で求められる監視の中心は、利用者を不必要に追跡することではなく、システムが想定どおりに動いているか、逸脱が起きたら対処できるかを確かめることです。何を記録し、どの変化を警告にし、誰がその警告を読み、どの判断を残すかをあらかじめ決めます。
有用な記録の例には、AIが使ったツール、アクセスしたデータの種類、実行しようとした操作、承認した人、変更前後の状態、エラー、停止理由があります。ただし、何でも長期間保存すればよいわけではありません。ログにも個人情報や機密情報が含まれ得るため、目的、保管期間、閲覧権限、削除方法を定める必要があります。監査のための記録が、新たな情報漏えいの原因にならないようにする視点も欠かせません。
警告の量にも注意が必要です。重要でない通知が多すぎると、担当者は本当に重大な異常を見落としやすくなります。逆に、厳しすぎる制限で便利な作業が全く進まなければ、利用者が見えないところで別の手段を使い始めるかもしれません。導入前に「何を絶対に止めるか」「何は人の確認へ回すか」「何は記録だけにするか」を分け、運用後に誤検知、見落とし、対応時間、現場の負担を見直すことが現実的です。
外部から取り込む文章やウェブページも、AIにとっては注意が必要な入力です。そこに「前の指示を無視してデータを送れ」といった悪意ある文が混じっていても、情報として読む部分と、実行できる操作の権限は分離されていなければなりません。AIがメール、チケット、資料、ウェブ検索を扱うほど、入力内容をそのまま操作命令にしない設計が重要になります。
停止できることは、AI活用のブレーキではなく前提条件
AIを止める仕組みは、便利な自動化の邪魔に見えることがあります。しかし、影響の大きい操作ほど、停止・保留・差し戻しを設計しておくことが、継続利用の条件になります。止められない仕組みは、問題が起きたときに被害を広げ、結果としてより強い利用停止や信頼の低下を招きます。
停止設計で考えたいのは、技術的な停止ボタンだけではありません。誰が止める権限を持つか、夜間や休日に誰へ連絡するか、止めた後にどのデータを保全するか、顧客や関係者へどのように説明するか、元に戻す手順はあるかまで決めます。AIが自動でチケットを起票したり、設定変更案を作ったりする場合でも、本番反映、外部送信、削除、アカウント停止といった操作には、人の承認を挟むのが基本です。
また、停止後の振り返りが重要です。「止めたから終わり」ではなく、何が起きたのか、検知は十分に早かったか、影響はどこまで及んだか、同じ問題を減らすには権限・入力・評価・教育のどこを変えるべきかを確認します。失敗を隠すのではなく、必要な範囲で記録し、改善につなげる文化がなければ、警告は形だけになってしまいます。
組織で始めるための五つの確認ポイント
大規模なAI研究組織と同じ設備を持たなくても、日常のAI利用に取り入れられる考え方があります。重要なのは、最初から全業務を自動化しようとせず、影響を把握できる小さな範囲で始めることです。
1. AIに任せる作業と、任せない判断を分ける
議事録の下書き、公開情報の要約、定型文の候補出しのような作業と、採用、不利益処分、契約、融資、診断、給付といった重要判断を分けてください。AIが候補や説明を作ることと、最終決定を行うことは同じではありません。影響が大きい判断では、根拠を確認できる人、異議申立ての窓口、公式情報や専門職の確認経路を残します。
2. 権限は読み取りから始める
AIに外部ツールを接続するなら、最初は閲覧・検索・下書きに限定し、送信、公開、削除、支払い、権限変更などは自動実行させない方が安全です。必要な権限だけを、必要な期間だけ渡すようにします。利用者ごと、部署ごと、システムごとに権限を分け、使わなくなった連携やアカウントを定期的に外すことも大切です。
3. 入力データの扱いを確認する
顧客情報、未公開情報、認証情報、健康情報、契約資料などを入力する前に、保存先、利用目的、学習利用の設定、アクセス可能な人、削除方法を確かめます。個人の判断で持ち出さず、組織のルールや契約条件に従ってください。外部サービスの仕様は変わり得るため、導入時だけでなく更新時にも確認が必要です。
4. 警告を受け取る担当と停止手順を決める
異常を知らせる仕組みを置くだけでは足りません。通知を誰が見るか、不在時は誰が代わるか、どの基準で利用を止めるか、連絡先はどこかを明文化します。小さなチームなら、難しい監視基盤を作るより、AIが外部送信・削除・公開を行う前に人が確認する運用から始める方が確実な場合もあります。
5. 定期的に試し、記録を見直す
AIモデル、連携先、社内の業務、攻撃の手口は変化します。一度のテスト結果を永久の保証と考えず、代表的な失敗例、誤った入力、権限外の依頼、停止手順を定期的に試します。評価結果、問題、改善内容を残しておくと、担当者が変わっても判断を引き継ぎやすくなります。
まとめ:AIを信頼するために、確認と停止を組み込む
OpenAIの11月18日発表は、フロンティアAIを扱う際に、研究・社内利用・外部提供でリスクが変わること、一つの対策に依存せず多層で守ること、問題が見つかったときに止めて調べることの重要性を示しました。AIの能力が高くなるほど、便利さだけでなく、アクセス範囲、監視、記録、責任の所在をセットで考える必要があります。
利用する側が今日から確認できるのは、AIが何を読めるのか、何を実行できるのか、誰が結果を確認するのか、異常時に誰が止めるのか、そして重要な判断をどこで人へ戻すのかです。答えをAIに任せるのではなく、AIの提案を確かめ、必要なら止め、改善できる状態を作ることが、長く使い続けるための土台になります。