2026年11月15日のAIニュースでは、Google Researchが紹介したAntigravityの`/teamwork`を使う複数AIエージェントの研究・開発支援が注目されました。報告の中心にあるのは、ひとつのAIに長い仕事を丸ごと頼む代わりに、調査、仮説づくり、計算、実装、見直しなどを複数のAIエージェントへ分け、人の研究者が方向づけと確認を担うという発想です。
「AIがチームで動く」と聞くと、もう人が確認しなくても研究や業務が進むように感じるかもしれません。しかし、公式の説明を丁寧に読むと、重要なのはAIの数ではありません。結果を確かめられる課題を選び、証明支援系の検査、既存のテスト、シミュレーター、実機の測定といった外部の物差しを使い、人が目的と合格条件を持つことが前提になっています。
この記事では、Google Researchの報告を手がかりに、複数AIエージェント協働とは何か、なぜ検証が中心になるのか、一般の仕事や学習で応用するときは何を決めておけばよいのかを整理します。研究成果や製品の性能、安全性、利用可能な地域・料金を保証する記事ではありません。AIが出した内容は、用途に応じて一次資料、担当者、専門職、独立したテストで確認してください。
Google Researchが示した「複数AIで取り組む」形
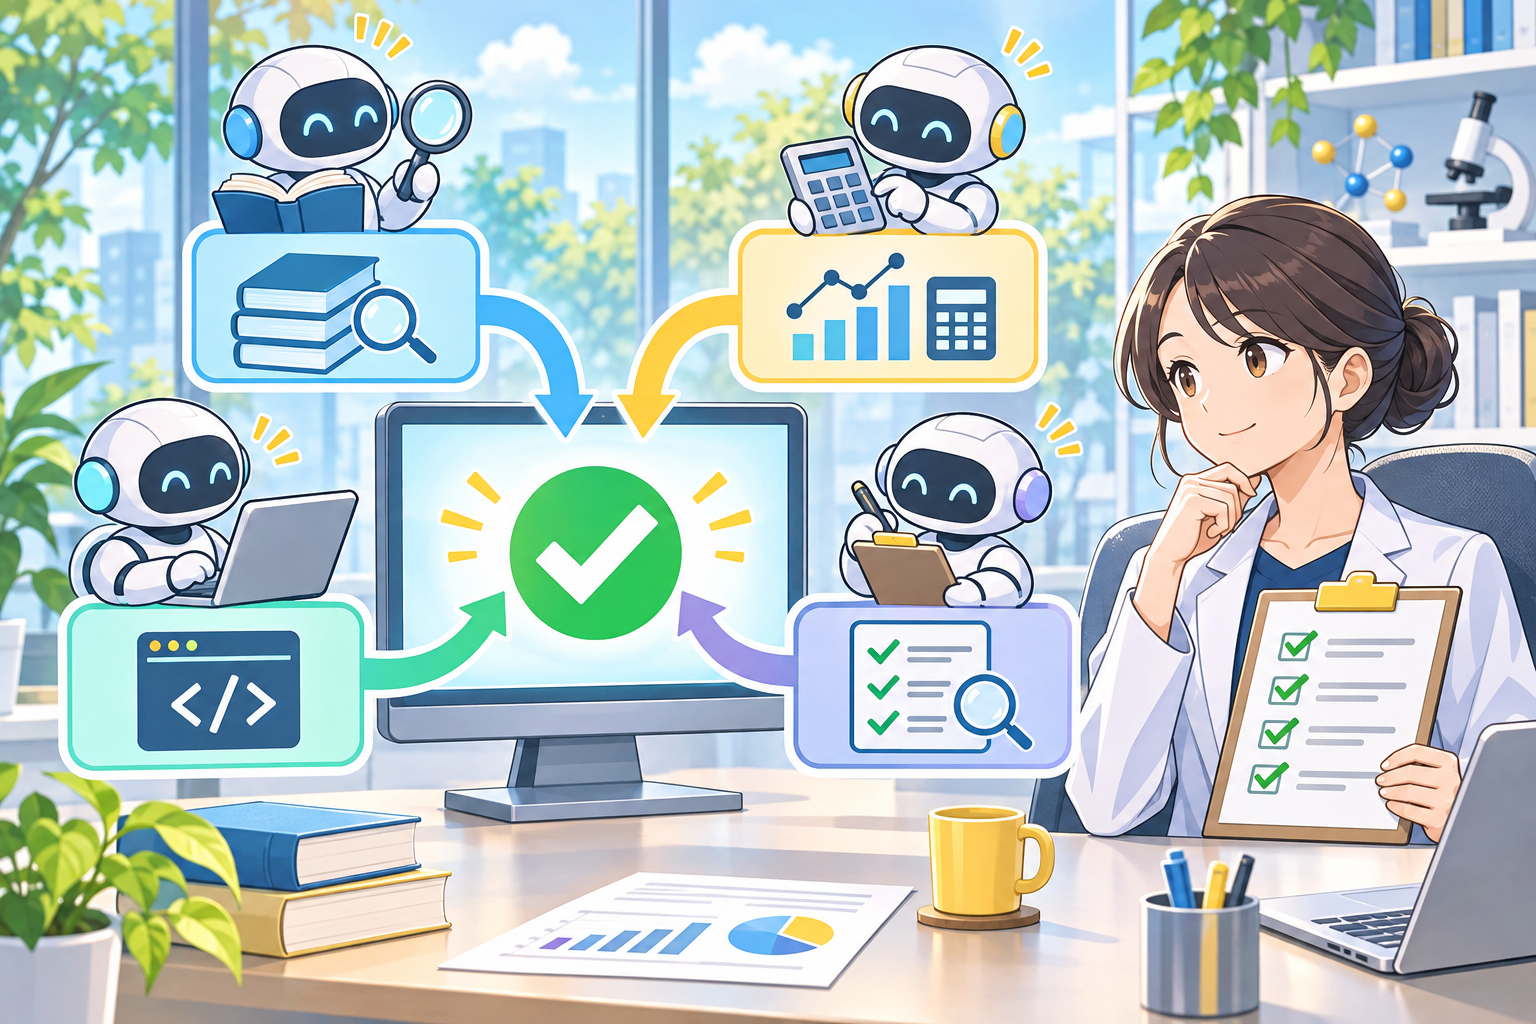
Google Researchは2026年11月13日、Antigravityの`/teamwork`という複数エージェントのワークフローを使い、数学、形式検証、分子構造、システムソフトウェア、機械学習の工学作業で進めた取り組みを紹介しました。ここでいう複数エージェントは、画面上にチャットボットを並べるだけの話ではありません。ひとつの難しい問題を小さな仕事へ分け、それぞれの担当が途中結果を出し、別の担当や検証器が確かめ、最終的に人が採否を判断する進め方です。
たとえば研究では、最初に「何を証明したいか」「どの条件なら成功といえるか」を人が定義します。次にAIが文献や既知の手法を探したり、複数の方針を試したりします。その案を別のAIが反例の観点から点検し、形式的な証明なら証明支援ソフト、プログラムなら既存のテストやコンパイラ、性能ならベンチマークや測定機器で確かめます。この流れなら、文章として説得力があるだけの答えではなく、事前に決めた物差しを通った成果だけを次へ渡しやすくなります。
Googleが紹介した事例には、学術的な問題の形式化や、ソフトウェア実装の改善があります。ただし、これは「複数のAIを走らせれば、どの仕事でも解ける」という意味ではありません。問題の定義があいまいだったり、正しさを測る方法がなかったり、関係者の価値判断が必要だったりする仕事では、AIを増やしても迷いが消えるわけではありません。むしろ、似た誤りを含む案が大量に集まり、人の確認負担が増える可能性もあります。
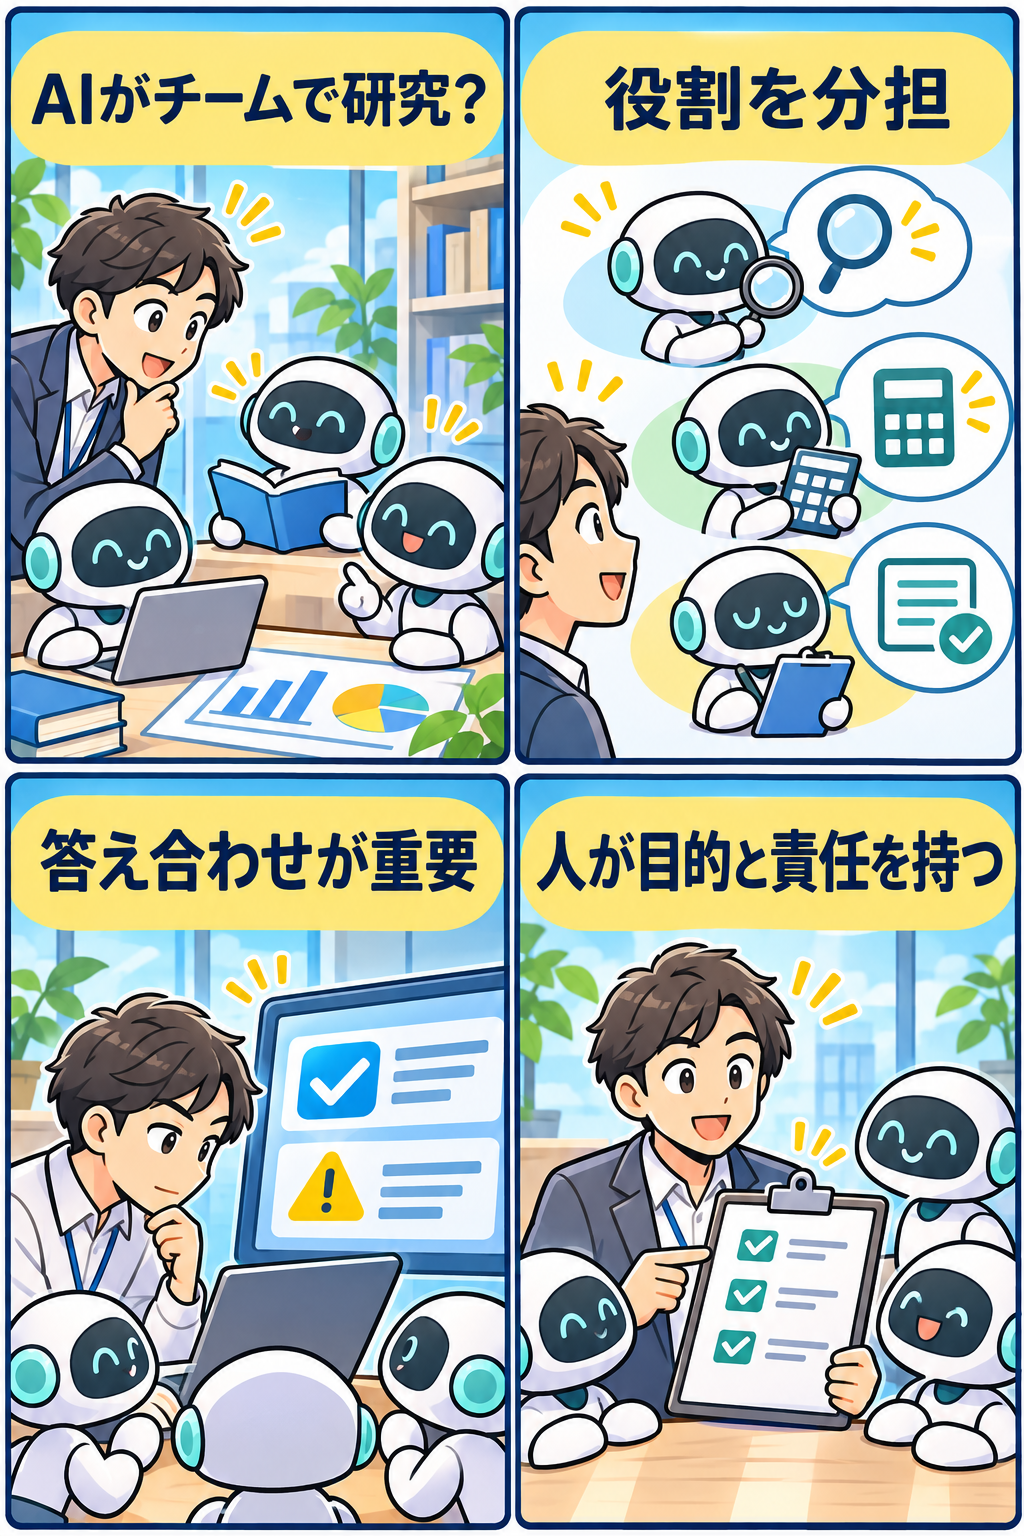
ニュースとして押さえたいのは、AIが人間の研究者を置き換えたという話ではなく、長い作業を「探索」と「検証」に分け、協働の形を設計しようとしている点です。AIは候補を広く出す役に向きます。一方で、何を問題として扱うか、失敗したときに誰へ影響が出るか、どの不確実性を許容しないかは、人が決める領域として残ります。
1人のAIと、役割を分けたAIは何が違うのか
一般的な生成AIとの会話では、利用者が質問を一つ送り、AIが一つの回答を返します。この形は、文章の下書き、要約、アイデア出し、プログラムのたたき台などには便利です。しかし、作業が長くなるほど、一つの会話だけに依存する弱点も見えてきます。前提を取り違える、途中で目的を忘れる、都合のよい情報だけを拾う、もっともらしい誤りを最後まで引きずる、といったことが起こり得ます。
複数エージェントの考え方では、こうした長い作業を一人の万能担当に集中させません。たとえば、調査担当には出典と公開日を集めさせ、実装担当には限定された仕様のコードを書かせ、レビュー担当には「間違いを探す」ことだけを任せます。さらに、調査担当の説明をそのまま採用せず、レビュー担当が一次資料を開けるか、引用が文脈に合っているかを見るようにします。役割が違えば、同じ答えを繰り返すだけの状態を減らせる可能性があります。
ただし、役割分担にはコストがあります。各担当へ渡す情報を整える必要があり、途中の出力を統合する人も要ります。担当同士が矛盾した場合、どちらを採用するのかを決める基準も欠かせません。短い定型作業まで大がかりなチームにすると、かえって時間、利用料金、管理の手間が増えるでしょう。AIを複数にすることは目的ではなく、作業の性質に合わせた手段です。
仕事で試すなら、最初は「結果を後から比較できる小さな作業」が向いています。公開済みの資料から論点を抽出する、テストケースを複数の視点で作る、会議メモから未決事項だけを拾う、といった仕事です。反対に、取引の可否、採用、診断、法的な判断、税務、融資、投資助言など、個人の権利や生活に大きく影響する結論は、AIエージェント同士で多数決を取って決めるものではありません。必要な資格・権限を持つ人と公式情報による確認が必要です。
なぜ「答え合わせ」がいちばん重要になるのか
生成AIは自然な文章を作るため、誤っていても自信がありそうに見えることがあります。複数のAIを使った場合も、この性質が自動的になくなるわけではありません。同じ資料、同じ指示、同じ偏りを持つモデルに依頼すれば、複数の出力が似た誤りへ集まることもあります。「3人のAIが同じことを言った」ことは、三つの独立した根拠があることと同義ではありません。
ここで役立つのが、答えとは別に置かれた検証器です。形式数学なら、定められた規則に従って証明が通るかを機械的に検査できます。ソフトウェアなら、既存の単体テスト、統合テスト、静的解析、セキュリティ検査、実行時の監視が候補になります。性能改善なら、同じ入力・同じ環境での比較測定が必要です。AIが「できた」と言うことではなく、あらかじめ決めた検査に通ったことを、採用の根拠にします。
ただし、検証器にも範囲があります。テストに通ったプログラムが、実際の利用者にとって使いやすいとは限りません。形式的に仕様へ一致しても、仕様そのものが古い、偏っている、倫理的に不十分ということはあります。測定値が良くても、入力データの偏り、環境の違い、維持費、権限の問題が残る場合があります。検証は魔法の印ではなく、「何を検査できて、何を検査できないか」を明らかにするための仕組みです。
そのため、AIチームを設計するときは、最終出力の前に次の三つを分けて記録すると役立ちます。第一に、AIが出した候補。第二に、それを確かめた手段と結果。第三に、人が採用・保留・却下を決めた理由です。この三つが混ざると、「AIが言った」「テストに通った」「人が承認した」が同じ強さの主張に見えてしまいます。記録を分ければ、後から問題が起きたときも、どの段階を直せばよいか追いやすくなります。
研究の成果を日常の仕事へ持ち込むときの注意
研究の事例は魅力的ですが、そのまま事務、営業、広報、教育、開発へ移せるとは限りません。研究では、課題が比較的明確で、検証に使える数式、実験、テスト、データセットが用意されている場合があります。一方、日常の仕事では「顧客にとって失礼でないか」「社内ルールに合うか」「今この場で出してよい情報か」といった文脈判断が多く、単純な正誤だけでは決まりません。
たとえば記事作成の補助に複数AIを使うなら、担当を「資料の公開日確認」「一次資料の抜き出し」「見出し案」「誤解を招く表現の点検」に分けることはできます。しかし、出典のない数字を採用しない、引用の意味を変えない、当事者の不利益につながる推測を広げない、といった編集上の責任は人が持ちます。AIが書いた下書きを別のAIに褒めさせるだけでは、独立した確認にはなりません。
ソフトウェア開発でも同じです。実装担当、テスト担当、ドキュメント担当を分けると、作業の見通しはよくなるかもしれません。けれども、AIに本番環境の広い権限を渡す、顧客情報をそのまま入力する、テスト不足の変更を自動公開する、といった設計は危険です。最小権限、承認の段階、変更履歴、戻す手順、異常時の停止を人が用意して初めて、実務に近づきます。
特に、医療、法律、税務、保険、金融、雇用、教育、福祉、行政などでは、AIの出力だけで個別の結論を確定しないでください。複数のAIが同じ提案をしても、必要な情報が欠けている、制度が更新されている、当人の事情が違う可能性があります。健康に関する判断は医療機関や薬剤師、法律・税務は資格を持つ専門職や公的窓口、投資・保険・雇用は契約先や担当機関など、適切な相談先で確認することが大切です。
導入前に決めたい5つのこと
複数AIエージェントを試すとき、最初に高度な指示文を作り込みたくなるかもしれません。それより先に、次の五つを短く決める方が安全で実用的です。
1. 目的と「やらないこと」
目的は「AIで効率化する」ではなく、「公開済み資料から候補を集め、人が一次資料で確認する時間を減らす」のように具体化します。同時に、AIへ任せないことも書きます。たとえば、外部への送信、本番データの更新、契約の確定、本人評価、個別の助言は人の承認なしでは行わない、といった線引きです。目的と禁止範囲がないと、エージェントが便利そうな近道を提案したときに、断る基準がなくなります。
2. 入力してよい情報
どの担当にも同じ情報を渡すほど便利とは限りません。氏名、連絡先、健康情報、口座情報、未公表の売上、契約書、ソースコード、顧客とのやり取りなどは、社内規程、契約、サービス設定を確認しないまま入力しない方がよい情報です。まずは公開情報や匿名化したテストデータで試し、必要最小限の情報だけを扱います。機密性の高い作業では、利用するサービスのデータ取り扱い、保存期間、学習利用の設定、アクセス権、監査記録を組織の担当者と確認します。
3. 役割と引き継ぎ方法
「調査」「作成」「反証」「検証」「最終確認」のように、役割を重複しすぎない形で置きます。各担当が次の担当へ渡すものも決めます。調査担当ならURL、公開日、引用した箇所、わからない点。実装担当なら変更ファイル、実行したテスト、未解決の制約。レビュー担当なら指摘の根拠と優先度です。引き継ぎが文章だけだと、後の担当が前提を誤解しやすいため、構造化した一覧やチェックリストを用意すると役立ちます。
4. 合格条件と人の承認点
AIに「よい成果物を作って」と頼むだけでは、完了の意味が人によって変わります。引用が一次資料に対応している、指定したテストが通る、個人情報が含まれない、数値の出典が追える、外部公開は担当者が承認する、といった合格条件を作業前に決めます。また、どの地点で人が止められるかも重要です。下書きの時点、権限を使う前、外部へ送る前、本番へ反映する前など、取り消しやすい場所に承認点を置きます。
5. 記録、停止、振り返り
利用したモデル、指示、参照した資料、出力、検証結果、承認者を必要な範囲で残します。ログを無制限に残せばよいわけではないため、個人情報や機密情報を含む記録の保管期限・閲覧権限も決めます。誤った出力、想定外の権限利用、費用の急増、外部サービスの不調を見つけた場合は、すぐ止める手順と連絡先を用意します。導入の成功は、AIが止まらず動くことではなく、問題を見つけたときに安全に止め、直して再開できることです。
「AIが複数なら信頼度も上がる」は本当か
複数の回答が一致すると安心感は高まります。しかし、その一致は信頼性の証明ではありません。全員が同じ誤った前提を読んでいる、同じ学習上の偏りを共有している、先に出た回答を後続のAIが追随している、といった場合には、見かけ上の合意が生まれます。人間の会議でも、異論を言う役がいなければ誤った結論へ進むことがあります。AIチームにも同じ構造があります。
だからこそ、レビュー担当には「結論を補強する」だけでなく、「反例を探す」「出典を開いて確認する」「条件を変えたら崩れないかを見る」といった反証の役を与えることが有効です。また、元の回答を見せずに別の担当へ同じ問題を解かせ、後から差分を比べる方法もあります。ただし、それでも完全な独立性は保証できません。重要な結論ほど、AIの外側にある一次資料、実験、テスト、利用者への確認、専門家のレビューを組み合わせる必要があります。
NISTのAIリスク管理の考え方でも、AIのリスクは技術だけで完結しません。利用目的、影響を受ける人、データ、運用、組織の責任分担、監視と見直しが関わります。複数エージェントの構成は、うまく使えば役割と確認を明確にするきっかけになります。反対に、責任の所在をぼかしたまま自動化だけを増やすと、「どのAIが悪かったか」を探すだけで、根本の設計問題が見えなくなります。
小さな検証から始めるための進め方
初めて試す場合は、成果を急いで外部公開や本番処理へ結びつけないことが大切です。まず、公開済みの資料だけを使った小規模な課題を一つ選びます。たとえば、複数の公的資料から更新日と変更点の候補を集める作業なら、調査担当に候補を出させ、確認担当には元ページを開いて日付と記述を照合させます。人は、照合の結果と引用箇所を見て、候補を採用するか決めます。この段階では、AIの回答が正しい回数よりも、間違いをどの工程で見つけられたかを記録する方が重要です。
次に、失敗した例を一つずつ分類します。出典が古かったのか、指示があいまいだったのか、担当間の引き継ぎで情報が欠けたのか、検証条件が弱かったのかを分けます。原因がわかれば、AIの数を増やす前に、入力の形式、役割の境界、チェック項目を直せます。改善の順番は「より強いモデル」より「より明確な目的と検査」を先に置く方が、利用者にも説明しやすくなります。
また、関係者がいる仕事では、試行の目的と扱う情報を共有しておきます。AIを使ったこと自体を隠すと、後から出典や判断経緯をたどれず、修正が難しくなります。反対に、どの工程でAIを補助に使い、誰が最終確認をしたかが分かれば、利用者や同僚も必要な範囲で点検できます。小さく試し、記録を見て、危険な使い方は止める。この繰り返しが、複数AIを便利さだけでなく信頼性の面からも評価する土台になります。
これから確認したいポイント
Google Researchの報告は、AIを一問一答の道具から、長い作業を支える協働相手へ広げようとする動きを示しています。研究や開発において、探索役のAIと検証役の仕組みを組み合わせる発想は、今後さまざまな製品や仕事へ入ってくるでしょう。一方で、発表された事例の環境、データ、専門家の関与、検証方法が、自分の職場や学習環境と同じとは限りません。
読者がまず確認したいのは、AIが何体動くかではなく、次の四点です。第一に、AIへ任せる目的が具体的か。第二に、入力してよい情報と権限が限定されているか。第三に、成果を確かめる独立した方法があるか。第四に、最終的に誰が責任を持って承認・停止・訂正するか。この四点が決まれば、AIの出力を過信せず、便利な部分を小さく試すことができます。
AIは候補を増やし、調べる速度を上げ、見落としを減らす助けになり得ます。しかし、正しさ、妥当性、公平さ、法令や契約への適合まで自動的に保証するものではありません。複数AIエージェントのニュースを、万能な自動化の到来として受け取るのではなく、「人の目的と検証をどう設計するか」を考える材料として見ることが、現実的な第一歩です。
まとめ
- Google Researchは、人の研究者と複数AIエージェントが役割を分け、外部の検証器やテストを使う取り組みを紹介した。
- 複数のAIが同じ結論に達しても、独立した根拠があるとは限らない。出典、テスト、反例確認を分けることが重要。
- 導入では、目的、入力情報、役割、合格条件、人の承認点、停止手順を先に決める。
- 医療、法律、税務、投資、雇用など重要な個別判断は、AIの出力だけで確定せず、公式情報や担当窓口、必要な専門職に確認する。