AIといえば、巨大なデータセンターで動くサービスを思い浮かべる人が多いかもしれません。けれども今は、PCや小型の機器の近くで動かす「小型モデル」も、会話や簡単な作業の補助に使えるようになりつつあります。通信が不安定な場面で応答を待ちにくい、毎回クラウドへ情報を送ることに慎重になりたい、機器の中で完結する体験を作りたい――そんな課題に対する選択肢です。
NVIDIAは2026年10月23日、会話型エージェント向けのオープンな小型言語モデル「Nemotron 3.5 Bolt E4B 4GB」を公開しました。発表によると、同モデルは会話、複数回にわたるツール利用、指示への追従を想定し、対象のワークロードでは約4GBという小さなメモリー規模での利用を目指しています。PC、組み込み機器、ロボットやIoTなど、応答の速さや機器側での処理を重視する場面が主な想定です。
ただし、「端末で動く」という言葉だけで、情報が自動的に安全になるわけでも、AIの答えが正しくなるわけでもありません。モデルの品質、必要なハードウェア、入力情報の扱い、接続するツールの権限、送信や実行を誰が確認するかは、用途ごとに別途考える必要があります。この記事では発表内容を整理しながら、小型AIを便利に使うために押さえたい確認点を、専門用語をできるだけほどいて紹介します。
Nemotron 3.5 Bolt E4B 4GBはどんなAIモデルなのか
まず、名称にある「4GB」は、一般に日常の利用で必ず4GBだけあれば動くという単純な保証ではありません。NVIDIAの発表は、量子化したモデルを対象ワークロードで約4GBの規模に収めることを掲げています。実際に必要なメモリーは、使うソフト、会話の長さ、同時に動かす処理、GPUやCPUの構成、モデルの形式によって変わります。手元のPCなら必ず快適、古い端末でも必ず使える、と受け取らないことが大切です。
このモデルは、単に一問一答を返すだけの用途ではなく、会話を続けながら必要に応じてツールを呼び出す「エージェント」的な利用を意識しています。たとえば、利用者の要望を聞き、アプリ内の検索機能で候補を探し、結果を短く説明し、次の確認を促す、といった流れです。NVIDIAは、会話向けのモード、複雑な依頼で考える量を調整する機能、ツール利用、64kのコンテキスト、35言語への対応を特徴として挙げています。
ここでいうコンテキストとは、AIが一度に参照できる会話履歴、指示、ツールの説明、検索で得た情報などの範囲です。長い会話や資料を扱えることは便利ですが、長く入れれば正確になるとは限りません。古い指示や関係のない情報が混じれば、AIが意図を取り違える可能性もあります。必要な情報を選び、出力の根拠を人が追えるようにする設計が、モデルの大きさに関係なく重要です。
発表では、音声・端末アシスタント、ゲームなどの対話型キャラクター、ロボットや産業用IoTの人と機械をつなぐ画面といった利用例が紹介されています。こうした場面では、数秒待って長い文章を返すより、利用者の短い問いに自然に返し、必要なら機能を呼び出し、途中で人の確認を待つことが求められます。小型モデルは、最高のベンチマーク値だけでなく、応答までの時間、消費電力、機器との相性、運用のしやすさを含めて選ぶ発想を後押しします。
なぜ「端末で動かすAI」が注目されるのか
端末側で処理するAIは、一般に「ローカルAI」や「オンデバイスAI」と呼ばれます。入力から回答までのすべて、または一部を利用者のPC、スマートフォン、工場の機器、車載機器などで処理する方法です。クラウド型のAIと競争するだけの仕組みではありません。長い資料の分析や最新情報の検索はクラウドが得意な場合があり、短い音声応答やオフラインに近い補助は端末側が向く場合があります。用途で使い分けることが現実的です。
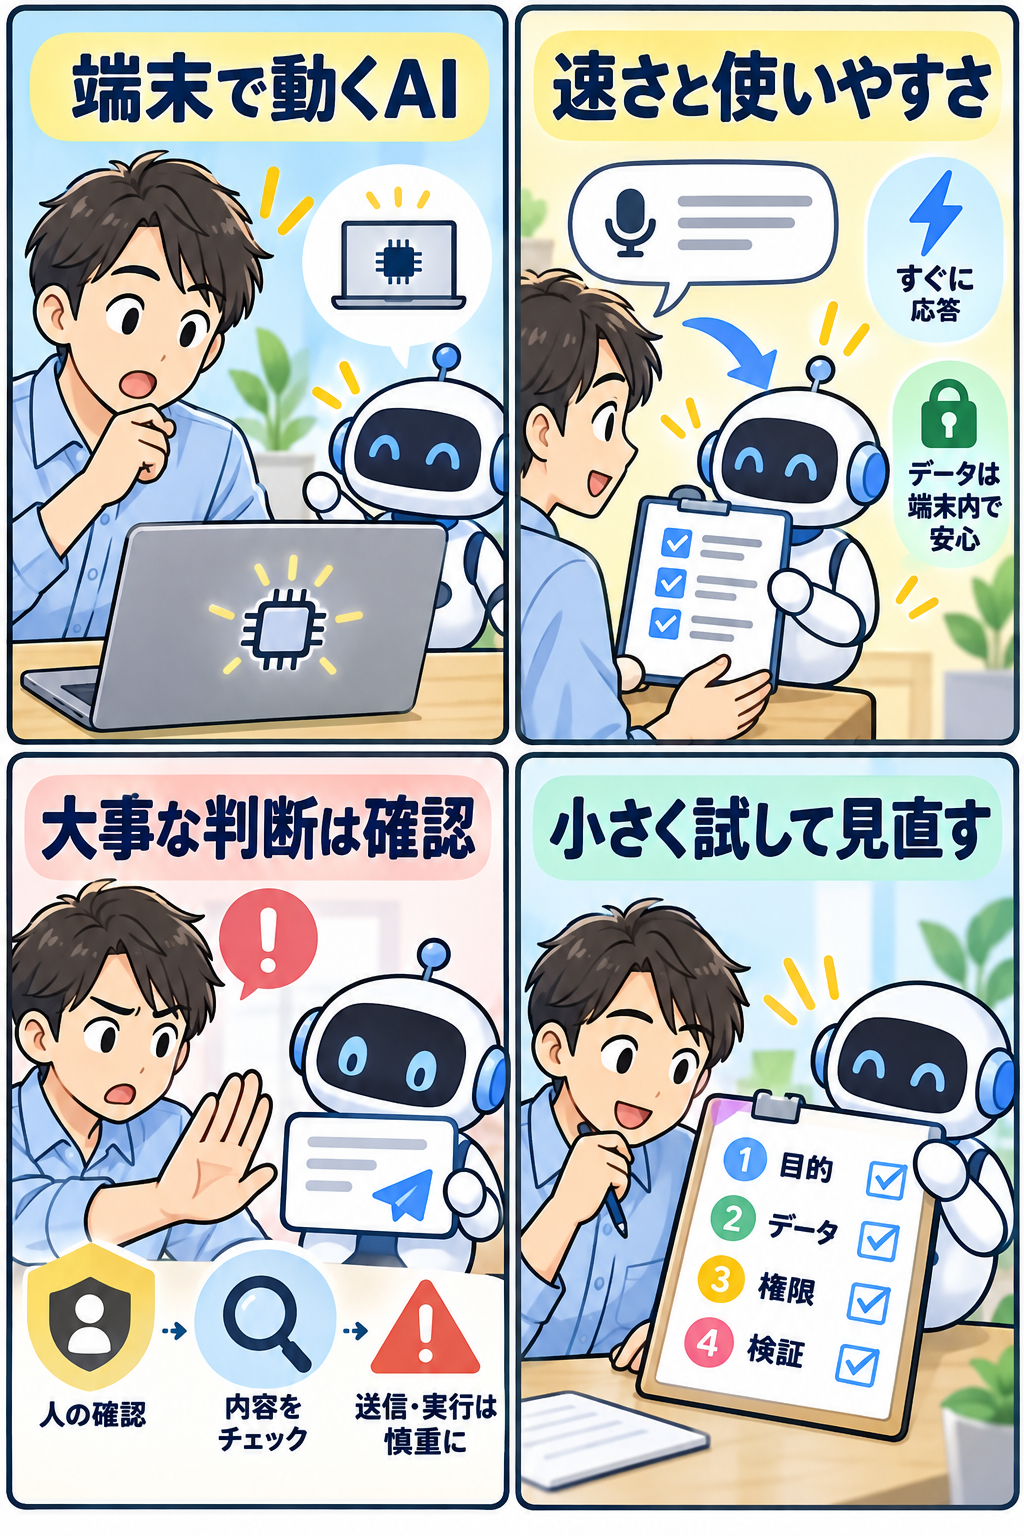
一つ目の利点は、応答の待ち時間を短くできる可能性です。音声で操作する補助や、画面上の小さな案内では、会話の間が長いと使いにくくなります。ネットワークを往復する量を減らせれば、利用者が「操作したらすぐ反応した」と感じられる体験につながることがあります。ただし、実際の速度は端末性能、モデルの設定、入力の長さ、ほかのアプリの負荷で大きく変わります。カタログ上の速度だけでなく、自分の使い方に近い条件で測る必要があります。
二つ目は、データの流れを設計しやすくなる点です。機器の中で完結する処理を選べるなら、毎回外部サービスに送らなくても済む情報が出てくるかもしれません。しかし、アプリがログを保存する、検索や外部ツールを呼ぶ、更新時に通信する、利用者が別のサービスへ貼り付ける、といった経路は残ります。「ローカルだから大丈夫」とは言えません。どの情報がどこへ送られるのか、ログやバックアップはどう扱われるのかを確認することが必要です。
三つ目は、用途に合わせた小さな実験をしやすいことです。公開済みの取扱説明書から質問候補を作る、社内の機器に表示する簡易案内を整える、ゲーム内の会話を試作する、といった範囲なら、影響を限定して検証できます。最初から顧客情報、決済、雇用、医療、契約の判断までつなぐ必要はありません。目的を一つに絞り、役に立つか、誤りを見つけられるか、止められるかを確かめてから次へ進むほうが、結果的に遠回りを減らせます。
発表にある性能値はどう読めばよいか
NVIDIAは、Nemotron 3.5 Bolt E4B 4GBが前世代の同社小型モデルと比べ、主要な会話型エージェントのベンチマークで平均約40%高い品質を示したと説明しています。また、比較対象より最大約80%少ない出力トークンで回答できるケースがあるとしています。これらは開発元が選んだベンチマーク、測定環境、設定に基づく結果です。発表そのものに、ハードウェア、推論ソフト、構成によって結果が変わるとの注意もあります。
ベンチマークは、モデルを比較する手掛かりにはなりますが、導入後の正確さや費用を一つの数字で約束するものではありません。ベンチマークでの正答が高くても、自社固有の略語、古いデータ、例外的な手続き、曖昧な音声、意地悪な入力で同じように動くとは限りません。逆に、総合スコアが最も高いモデルでなくても、限定した定型作業なら使いやすいことがあります。
特に注意したいのは、「出力トークンが少ない」ことと「必要な説明が常に足りる」ことは別だという点です。短い回答は、音声対話や画面の案内では読みやすい反面、根拠や条件を省いてしまうかもしれません。重要な手順では、簡潔な通常モードと、根拠を表示して人が確認するモードを分ける、といった設計も考えられます。速さを求める場所と、説明を残す場所を同じ基準で評価しないことが大切です。
性能を確かめる際は、提供元の資料に加えて、自分たちの実例を少数用意します。正解が分かる質問、曖昧な質問、答えないほうがよい質問、権限のない操作を頼む質問、途中で利用者の条件が変わる会話などです。結果を「正しい・誤り」の二択だけでなく、迷ったときに聞き返したか、分からないと答えたか、勝手に外部操作しなかったかという観点でも確認します。こうした評価は派手ではありませんが、実運用での安心につながります。
小型AIで広がる使い方と、任せすぎない線引き
身近な例では、端末の設定を案内するアシスタントが考えられます。「画面を暗くしたい」「次の予定を見たい」といった依頼に対し、AIが候補の操作を示すことは便利です。ただし、設定変更の確定、予定の送信、連絡先への通知といった外部に影響する操作は、利用者が内容を見て承認できる形が望ましいでしょう。AIに実行権限を渡すほど、誤解や誤操作の影響も大きくなるためです。
職場では、製品マニュアルを検索して現場の作業者に短い手順を示す使い方があります。ここでも、AIが原典の版数、更新日、該当箇所を示し、作業者が公式の手順書を開けるようにしておくと確認しやすくなります。安全に関わる作業、設備の操作、品質判断では、AIの回答を最終手順に置き換えてはいけません。責任者が定めた手順、教育、停止条件を優先してください。
趣味や家庭では、音声でのメモ整理、家電の操作案内、ゲームの会話などが分かりやすい用途です。音声や会話は親しみやすい一方で、AIが理解しているように見えることで、利用者が過度に信用しやすくなります。健康、子どもの教育、進路、家計、投資、保険、法律、税金など、生活に大きく影響する相談は、AIの自然な回答だけで決めないでください。公式情報、学校・行政の窓口、医師・薬剤師、税理士・弁護士など、内容に応じた専門家へ確認することが欠かせません。
NISTのAIリスク管理フレームワークは、AIによるリスクを個人、組織、社会への影響として扱い、設計・開発・利用・評価のなかで継続的に考える枠組みを示しています。小型モデルになったから、こうした考え方が不要になるわけではありません。むしろ端末や現場に近い場所でAIを使うほど、誰が管理し、どう更新し、異常時にどこで止めるかを具体的に決める必要があります。
導入前に確認したい7つのポイント
1. 何を助けてもらうのかを一文にする
「AIを入れる」ではなく、「公開済みの説明書から、利用者が確認するための操作候補を短く出す」「会議の録音ではなく手入力したメモを要点ごとに並べ替える」のように書きます。対象が明確なら、成功の基準、許容できない誤り、必要な権限、最終確認者を決めやすくなります。利用回数が増えることではなく、利用者の手間や間違いがどう変わったかを見ます。
2. 入力する情報を分類する
公開情報、社内一般情報、個人情報、認証情報、取引先から預かった情報、未公開情報を一緒に扱わないことが基本です。端末処理を選んでも、アプリのログ、同期、クラッシュレポート、連携先のAPIなど、データが動く経路を確認します。氏名、住所、健康情報、口座情報、パスワード、APIキー、個別契約の内容は、特に慎重に扱うべき情報です。迷ったら入力しないというルールと相談先を用意しましょう。
3. 権限は必要最小限にする
最初は読み取り専用、下書き作成だけ、テスト用のデータだけに限定します。メール送信、購入、予約変更、顧客情報の更新、設備操作などは、AIが単独で確定しない設計にします。利用者ごとの権限を分け、異動・退職・委託終了の際に外す手順も決めます。便利だからと広い権限を渡すのではなく、必要になった権限だけを後から追加するほうが、問題の範囲を小さくできます。
4. 回答を原資料に戻して確認できるか
AIが答えた内容の出どころを、利用者がたどれるようにします。参照した文書名、更新日、該当箇所を表示する、答えがないときは推測せず「確認が必要」と返す、といった工夫が有効です。価格、仕様、納期、制度、契約条件は変わり得ます。AIの要約ではなく、最新の公式資料や責任者の確認を基に判断してください。
5. 失敗を報告し、停止できるか
誤った回答、関係のないデータの参照、意図しない操作、入力ミスが起きたときに、誰へ知らせ、何を止め、どの記録を確認するかを決めます。報告した人を責めず、早く共有する雰囲気が重要です。AIの更新、接続先の変更、モデルの差し替えでも振る舞いは変わり得ます。導入時だけでなく、定期的にヒヤリハットを見直しましょう。
6. 費用と運用の手間を一緒に測る
端末で動かす場合は、モデルの利用料だけでは終わりません。対応機器、メモリー、電力、配布方法、更新、セキュリティ対策、問い合わせ対応、検証時間が必要になります。クラウド型と比べるときも、通信費だけでなく、管理する手間や障害時の対応を含めます。少数の利用者と短い期間で試し、処理時間、修正回数、困った場面を記録すると、感覚だけではない判断ができます。
7. できないことを利用者に伝える
AIが誤る可能性、扱わない情報、承認が必要な操作、相談先を短く明示します。使う人が「分からないときは止まる」ことを選べる設計にするのが重要です。音声で話すAIや人らしいキャラクターは、つい人格や専門性を感じさせます。だからこそ、AIが持つ権限と限界を画面や手順に見える形で置き、人の判断を残す必要があります。
ローカルAIとクラウドAIは、どう使い分けるとよいか
端末で動く小型AIが登場しても、すべてをローカルに移す必要はありません。大規模な検索、最新の外部情報との照合、多人数で共有する知識の管理、複雑な画像や長文の処理などは、クラウド型サービスのほうが適することがあります。逆に、短い会話、決まった機器の案内、通信が不安定な場所での補助、端末から出さない範囲で試す下書きには、小型モデルが合うかもしれません。
使い分けで重要なのは、「どこで動かすか」よりも「何を外に出してよいか」「失敗したときに何が起こるか」です。たとえば、端末上のモデルが社内資料を読んでいても、外部検索や翻訳の機能を呼び出した瞬間に情報の流れが変わります。反対にクラウド型であっても、契約、管理設定、アクセス制御、ログ管理を整えれば、組織のルールに沿って利用できる場合があります。方式の名前だけで安全性を判断せず、データの経路と運用を図にして確かめると分かりやすくなります。
もう一つの視点は、更新です。端末に入れたモデルやアプリは、いつ誰が更新するのか、更新で回答や権限の振る舞いが変わったときにどう確かめるのかを決めなければなりません。脆弱性への対応や、古い説明書を参照し続けないための情報更新も必要です。オフラインで動くことは利点になり得ますが、更新を止めたままにする理由にはなりません。配布元、ライセンス、サポート範囲、更新履歴を確認し、戻せる手順を残すことが長い運用を支えます。
最初の試行で見ておきたい小さなチェック
初めて試すときは、答えの品質だけを見るのでは不十分です。利用者が依頼を言い直さずに済んだか、返答に必要な前提が抜けていないか、誤ったときに訂正できたか、処理が止まったときに困らなかったかも観察します。例えば10件程度の代表的な依頼を用意し、正解があるもの、情報不足で聞き返すべきもの、断るべきものを混ぜます。担当者が結果を見比べれば、モデルの得意・不得意が見え始めます。
送信や実行を伴う機能は、最初は「提案だけ」にします。AIが作った文章を利用者が選ぶ、候補の予定を表示して人が確定する、機器の操作手順を示して責任者が実行する、といった段階を設けます。実行履歴を残し、いつでも停止できるボタンや連絡先を用意すれば、失敗を早く見つけやすくなります。正解率を上げる工夫と同じくらい、間違いが外へ広がらない工夫が重要です。
試行の終了時には、「便利だった」「使いにくかった」だけで終わらせず、次に残す条件を短く書きます。入力してよいデータ、禁止する操作、確認する役割、更新の担当、問題の報告先です。こうしたメモは、別の端末や別のチームへ広げるときの土台になります。小型AIは身近に置きやすいからこそ、個人の工夫だけにせず、誰が使っても迷いにくい約束事を作ることが大切です。
小型であることは、検証を省略してよいという意味ではありません。目的に近い場面で、短い試行、記録、見直しを繰り返すことが、無理なく使い続ける近道になります。
まとめ:小型AIは「近くで速く動かす」ための選択肢
NVIDIAが公開したNemotron 3.5 Bolt E4B 4GBは、会話、ツール利用、端末や組み込み機器での応答を意識した小型言語モデルです。AIを使う場所はクラウドだけではなくなり、利用者のそばで素早く補助する仕組みが増えていくでしょう。一方で、発表の性能値は開発元の測定に基づくものであり、すべての端末や用途での効果・安全性・費用を保証するものではありません。
大切なのは、モデルの名前やサイズだけで導入を決めないことです。何を助けてもらうのか、何を入力してよいのか、どの操作を人が承認するのか、根拠に戻れるか、問題が起きたら止められるかを、先に決めます。小さな用途から試し、実際の利用者の声と記録をもとに見直す。その積み重ねが、端末で動くAIを便利で説明できる道具にしていきます。
医療、法律、税務、投資、保険、雇用、教育、行政手続きなどの重要な個別判断は、AIの出力だけで確定しないでください。最新の公式情報、担当窓口、必要に応じた専門職に確認し、訂正や相談の手段を確保したうえで利用することが大切です。