2026年10月30日、OpenAIは、ウェブサイトの運営者が「自分のサイトの内容を基盤となる生成AIの学習に使ってよいか」という利用意向を、複数のAI事業者へまとめて伝えやすくする共通の信号を尊重する方針を発表しました。使われる場所は、多くのサイトに置かれている`robots.txt`です。これまで事業者ごとにクローラー名を探して個別のルールを保守していた運営者にとって、設定の考え方を整理しやすくする可能性があります。
ただし、ここで早合点は禁物です。発表時点でOpenAIは「今後数か月で実装することを目指す」と説明しており、共通の仕組みもIETFで検討中のインターネット草案です。標準として確定したものではありません。さらに、AI学習への利用意向を示すことと、サイトを取得するクローラーのアクセスを制限することは、同じ`robots.txt`を使っても別の話です。設定一つで、すべてのAI利用、著作権上の扱い、検索掲載、第三者による再利用までを自動的に決められるわけではありません。
この記事では、発表の内容を平易に整理し、サイトやブログ、メディアを運営する人が今から確認しておきたい点を紹介します。技術や運用の一般的な解説であり、著作権、契約、個別の設定についての法的助言ではありません。収益化、顧客情報、医療・法律・税務・金融など重要な情報を扱うサイトでは、公開前に最新の公式資料、契約先、必要に応じて専門家へ確認してください。
今回発表された「共通の信号」とは
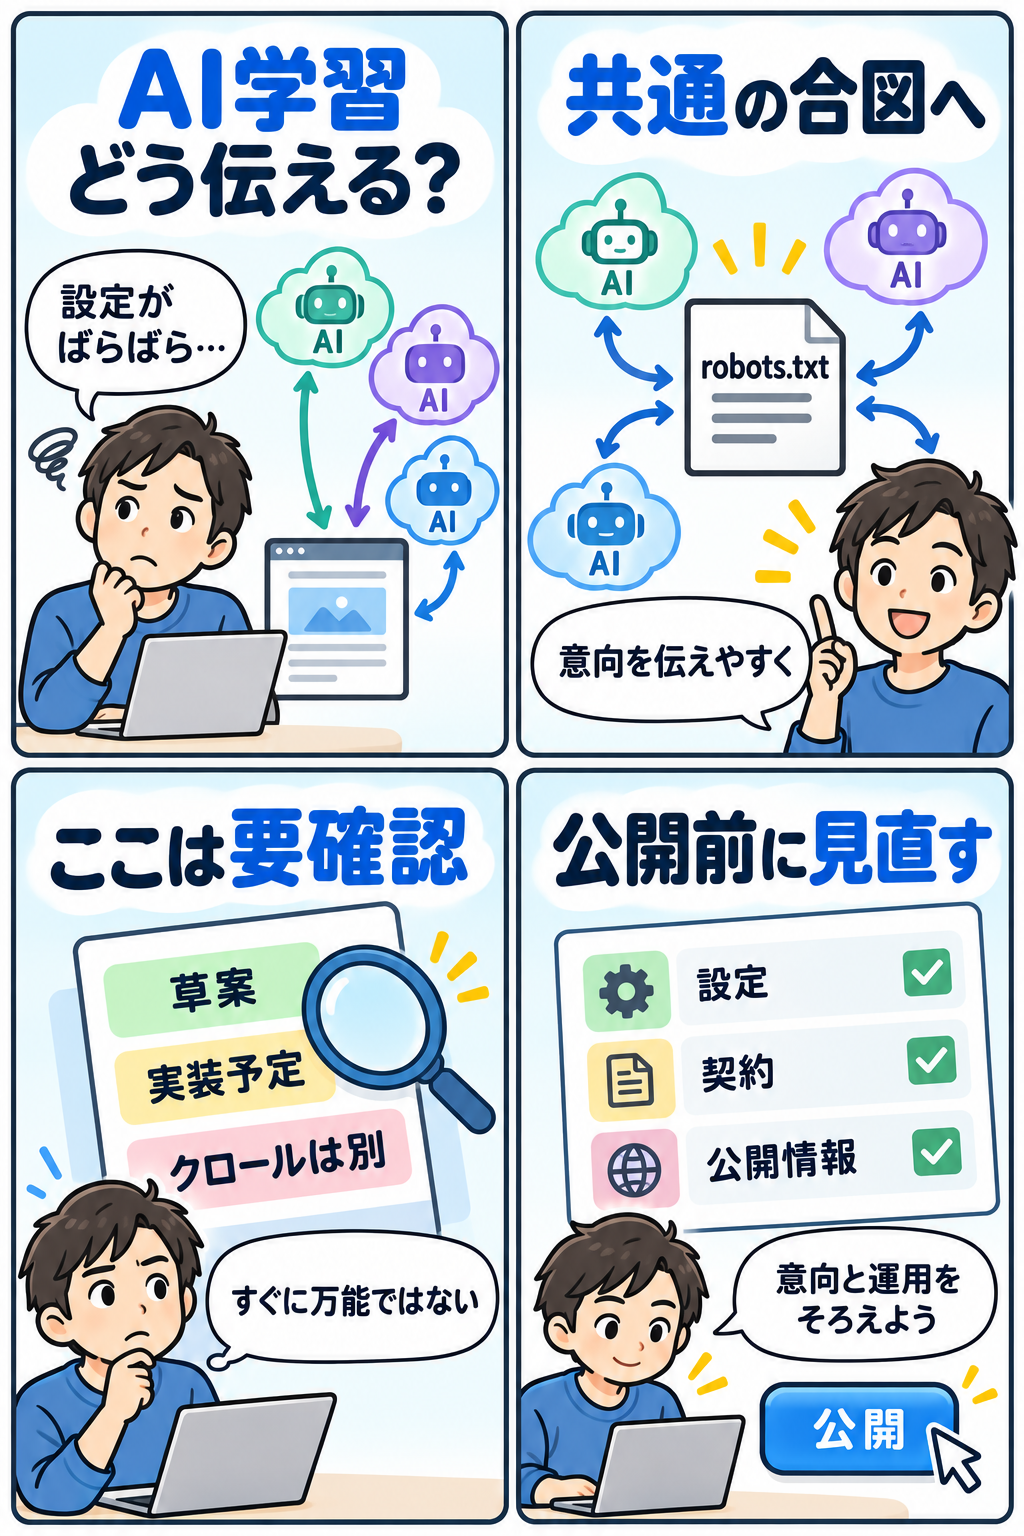
OpenAIが10月30日に示したのは、サイト運営者が生成AIの基盤モデル学習についての意向を、共通の書き方で表せるようにする考え方です。同社によると、運営者はこれまで、AI事業者ごとのクローラーを特定し、それぞれに別のルールを置く必要がありました。サイトが増え、利用目的ごとにクローラーも増えるほど、この保守は手間になります。共通の信号が複数の参加事業者に受け入れられれば、一つの意向を伝えるための重複した作業を減らせる、というのが狙いです。
仕組みの検討資料では、既存の`robots.txt`の書式を大きく作り替えず、特定の用途を表す「ポリシートークン」を`User-Agent`行に書く方法が示されています。学習への利用を対象にする場合の名称は`__usage_ai-training`です。パスごとに、使ってほしくない意向、使ってよい意向を表せるようにする案になっています。サイト全体だけでなく、たとえば公開資料と会員向けのページを区別したい運営者が、将来検討できる余地を持たせる発想です。
ここで大切なのは、これは「サイトの内容を許可・禁止する万能の命令」ではなく、運営者の利用意向を機械可読な形で表すための合図だということです。IETFの草案自身も、対応しない消費者は従来どおりに動くこと、草案の信号がない場合は意向が表明されていないことを説明しています。誰がどの用途で尊重するかは、参加する各事業者の実装と方針に依存します。表示しただけで世界中のすべての収集者に効果が及ぶ、と考えるのは正確ではありません。
robots.txtは何をするファイルなのか
`robots.txt`は、通常はサイトのルートに置かれる小さなテキストファイルです。検索エンジンなどの自動取得プログラムに対し、どの場所を取得してよいか、どの場所を避けてほしいかという希望を表すために使われてきました。代表的なルールは、対象となるプログラム名を示す`User-Agent`と、対象パスを示す`Allow`や`Disallow`です。インターネット標準のRFC 9309は、こうしたロボット排除プロトコルの基本を定めています。
しかし、`robots.txt`はアクセス制御そのものではありません。秘密にしたい情報や、確実に見せたくないファイルを置く場所ではありません。外部からアクセスできるページであれば、別の経路で見つかる可能性がありますし、規則をどう解釈するかは取得側の実装にも関わります。認証、アクセス権限、公開範囲の設定、サーバー側の制限といった対策の代わりに使うものではない、という基本を押さえておく必要があります。
今回の草案も、既存のクローラー向け規則と、コンテンツをどの目的に使ってよいかという意向は独立している、と明記しています。つまり、AI学習についての意向を表す行を置いても、特定のクローラーがページを取得するかどうかの規則を自動的に置き換えるわけではありません。反対に、クローラーの取得を制限する規則を書いたからといって、学習利用に関する共通の意向まで必ず表せるわけでもありません。似た場所に書く二つの設定を、役割ごとに分けて考えることが大切です。
なぜ共通化が求められているのか
ウェブ上のコンテンツには、個人ブログ、企業の案内、報道、研究資料、創作作品、商品ページ、行政情報など、性質の異なる情報が混在しています。運営者がAIとの関係を考えるときも、答えは一つではありません。幅広く見つけてもらいたい人もいれば、内容の利用範囲を細かく選びたい人もいます。自分で書いた記事、外部から許諾を得て掲載している素材、会員限定の情報、個人情報を含むページでは、確認すべき契約や扱いが異なることもあります。
個別のAI事業者が独自の名称で意向を受け取る状態では、運営者は相手ごとに仕様を調べ、複数の記載を維持することになります。そこでは、記入漏れ、古い設定の放置、意図しない重複、担当交代時の引き継ぎ漏れが起きやすくなります。共通の表現が広く使われれば、少なくとも「何についての意向か」を同じ言葉で話し合いやすくなります。OpenAIが今回、複数の参加事業者へ同じ希望を伝えられる点を強調した背景には、こうした運用負荷があります。
一方で、共通化は「全員が同じ結論になる」ことではありません。信号を読む事業者、読む用途、導入時期、既存の個別設定との優先関係は、公開資料で確認する必要があります。IETF草案は特定の表現がより具体的な場合に優先され得ることや、私的な契約が信号に優先し得ることにも触れています。コンテンツ提供者と利用者の関係は、技術的な一行だけでは完結しません。設定、契約、公開方法、説明の四つをそろえて見直す姿勢が現実的です。
発表時点で分かっていること、まだ分からないこと
今回のニュースを読むときは、確定した事項と今後の事項を分けると混乱が減ります。確定しているのは、OpenAIが共通信号を尊重する方針を発表したこと、既存のクローラー制御は継続して尊重すると説明していること、そして草案が10月30日付で公開されていることです。草案は既存の`robots.txt`の文法を大きく変えず、AI学習という用途に対応するためのトークンを提案しています。
まだ決まったものとして扱えないのは、OpenAIの実装がいつ完了するか、他のすべてのAI事業者が対応するか、草案が将来どのような文言へ変わるかです。IETFのデータトラッカーには、この文書が個人提出のInternet-Draftであり、IETFによる承認を受けておらず、正式な位置づけを持たないことが明示されています。Internet-Draftは更新、置換、廃止される可能性があります。現在の例をコピーして長期の確定設定と決めつけるより、採用するサービスの公式案内を追い、公開時点の仕様を確かめるのが安全です。
また、意向の信号は著作権や契約の結論そのものではありません。掲載物に第三者の写真、寄稿、素材、データベース、顧客提供資料が含まれる場合、自分だけで利用方針を決めてよいとは限りません。利用規約、ライセンス、取引先との契約、社内規程を確認してください。法域や事実関係で扱いが変わり得る問題について、この記事やAIの一般的な回答を根拠に個別の権利判断をしないことも重要です。
サイト運営者が先に棚卸ししたい4つのこと
新しい記法を急いで追加する前に、自分のサイトの中身と運用を整理すると、後の設定ミスを減らせます。最初は、何が公開されているかです。記事、画像、PDF、商品説明、ダウンロード資料、過去の告知、テストページなどを一覧にし、公開の目的と権利関係を大まかに分けます。CMSの古い下書き、検索結果に残った添付ファイル、サブドメインも忘れず確認するとよいでしょう。
次は、誰が権利や公開判断を持つかです。個人ブログなら自分で決められる範囲が比較的見えやすい一方、会社や団体のサイトでは広報、法務、編集、セキュリティ、事業部、委託先の意向が関係することがあります。記事の本文は自社作成でも、掲載写真や図表は別契約ということもあります。設定をする担当者だけで判断せず、必要な人に「どのコンテンツを対象に、どの方針を表すのか」を確認してもらう流れを用意しましょう。
三つ目は、いま存在する技術設定です。`robots.txt`に何が書かれているか、サイトマップの場所はどこか、検索エンジンの管理画面にどんな設定があるか、CDNやセキュリティ製品で特別なルールがないかを記録します。変更前のファイルを保存し、誰がいつ何を変えたかを残しておくと、検索表示や取得の変化が起きたときに原因を調べやすくなります。本番環境を直接書き換える前に、テスト環境や構文確認ツールで確認することも役立ちます。
四つ目は、利用者への説明です。AI利用に関する意向を示すなら、プライバシーポリシー、利用規約、編集方針、問い合わせ窓口との整合性も見ます。技術的な行が一つあるだけでは、読者や取引先が意図を理解できないことがあります。反対に、説明文で過度な約束をすると、実際の技術設定や契約とのずれが生まれます。「現在どの方針を取っているか」「変更時にはどこで知らせるか」を簡潔に書ける状態を目指すと、伝わりやすくなります。
設定を検討するときの安全な進め方
第一に、対象のAI事業者が実際に対応を公表しているかを、公式の開発者向け文書で確認します。ニュース記事やSNSの要約だけで、対応済みと判断しないでください。今回のOpenAIの発表は、今後数か月で実装を目指す段階です。実際に有効になる日、対象サービス、適用範囲、既存ルールとの関係が追加で案内される可能性があります。設定例を使うなら、取得した日付と参照した公式ページを残しておくとよいでしょう。
第二に、変更の目的を一文で書きます。たとえば「基盤モデルの学習についての利用意向を表したい」のか、「不要な取得を減らしたい」のか、「公開範囲を狭めたい」のかで、取るべき手段は違います。目的が混ざると、`robots.txt`の変更に認証や契約の課題まで任せてしまいがちです。非公開にすべき資料なら、公開URLを残したまま合図を置くのではなく、認証や公開停止など、目的に合う手段を検討してください。
第三に、小さく変更して観察します。大規模なサイトでは、全パスを一度に変えるより、対象を明確にし、変更前後のファイル、公開日時、承認者を残します。意図しない検索流入の変化や、必要なクローラーまで止めていないかを確認できるようにします。IETF草案の意向信号はクロール規則と別であるため、既存の検索・クローラー向け設定を削除する根拠にはなりません。個別のクローラー設定を変える場合も、別の変更として影響を確認しましょう。
第四に、定期的に見直します。AI事業者の方針、IETF文書、サイトの構成、掲載契約は変わります。半年ごと、またはCMS更新・サイトリニューアル・大きなコンテンツ追加のタイミングで、設定と説明文を見直す担当を決めておくと安心です。便利な自動化ほど、誰が最終確認するか、問題が見つかったときにどこで止めるかを先に決めておくと、継続しやすくなります。
よくある誤解を避ける
一つ目の誤解は、「robots.txtに書けば、誰にも取得されない」というものです。先に触れたように、robots.txtは公開された情報への希望を表す仕組みで、鍵や門ではありません。認証が必要な情報、個人情報、未公開の資料、限定配布のファイルは、公開場所やアクセス権を見直す必要があります。URLを知っている人だけが見られる状態も、十分な保護といえないことがあります。
二つ目は、「AI学習の意向と検索表示は同じ」という誤解です。検索結果へ出すこと、検索用のクローラーに取得させること、生成AIの学習に使うこと、生成AIの回答で参照されることは、サービスや目的によって別に扱われる可能性があります。検索流入を維持したいなら、重要なページの検索設定を変える前に、何へ影響するルールなのかを公式資料で確認します。集客、広報、採用、公共情報の提供など、サイトの役割を踏まえて判断してください。
三つ目は、「共通信号があれば法的な問題も解決する」という誤解です。技術的な意向表明は、関係者間の対話をしやすくする一つの材料にはなり得ますが、権利、契約、地域ごとの制度、利用の実態を代替するものではありません。特に、第三者の著作物を含むメディア、共同制作物、顧客から預かった資料、業界規制のある情報は、専門の確認が必要です。重要な判断にAIの回答だけを使わず、一次資料と担当者・専門家の確認を重ねてください。
小さな運用ルールが、後の負担を減らす
このニュースは技術仕様の話に見えますが、本質は「自分のコンテンツに関する意向を、相手に伝わる形で管理する」ことです。個人運営なら、公開前に権利の由来をメモし、画像や文章の出典を整理するだけでも、判断しやすくなります。会社なら、編集・広報・法務・ITの間で、サイトの利用方針と変更窓口を共有しておくことが土台になります。
おすすめは、変更記録を残すことです。ファイルの旧版、変更日時、目的、承認者、参照した公式資料、確認日を、短い表でもよいので保管します。意向を変えた理由を後から説明でき、退職や担当変更があっても引き継ぎやすくなります。もし外部制作会社やホスティング会社が設定を管理しているなら、どこまでを誰が更新するのかも確認します。
問い合わせを受ける可能性があるサイトでは、連絡先と訂正・削除の窓口も整えておくとよいでしょう。AI学習の話題に限らず、公開情報に誤りや権利上の懸念があったとき、利用者が連絡できる経路があることは信頼につながります。対応の期限や結論を安易に約束する必要はありませんが、受け付けた後に誰が確認するかを決めておくと、慌てずに済みます。
まとめ:意向の表示と、公開管理を一緒に考える
OpenAIが発表した共通のAI学習利用意向シグナルは、ウェブサイト運営者が複数のAI事業者へ同じ希望を伝えやすくするための前向きな動きです。既存の`robots.txt`を使うため、運用になじみやすい可能性があります。一方で、2026年10月30日時点ではIETFの作業草案であり、OpenAIの実装もこれからです。すべての事業者への効果、法的な結論、サイトへのアクセス制御を保証するものではありません。
いま優先したいのは、設定を急ぐことではなく、自分のサイトに何があり、誰が公開判断を担い、どの目的を表したいのかを整理することです。既存のクローラー設定、権利関係、公開範囲、契約、説明文を見直し、公式資料に基づいて段階的に運用してください。AIの変化が速いからこそ、技術的な合図だけに頼らず、公開情報を適切に管理し、人が確認できる仕組みを残すことが、長く安心してサイトを運営する近道になります。
特に小規模なブログでは、完璧な規程を一度に作ろうとしなくて構いません。まずは、`robots.txt`の現在の内容を保存する、掲載画像と文章の出所を把握する、変更を公開する前に公式の仕様ページを開く、という三つから始めれば十分です。分からない設定を推測で追加せず、対象となる提供者の案内が整うのを待つ判断も、立派なリスク管理です。新しい仕組みを使うかどうかを、アクセス数だけで急いで決めるのではなく、読者への情報提供、創作物の扱い、事業上の目的とのバランスで考えましょう。
また、AIに設定案や説明文の下書きを頼む場合も、出力をそのまま本番へ反映しないでください。現在の`robots.txt`、サイト構成、契約条件、各社の公式文書と照合し、必要なら運用担当者へ見てもらいます。AIは論点の洗い出しや確認リスト作りには役立ちますが、個別サイトの安全性、権利、検索上の影響を保証することはできません。最後に内容を確認して公開を決める責任は、サイト運営者側に残ります。