2026年11月5日(日本時間では11月6日に当たる時間帯を含む)、OpenAIはサイバーセキュリティ作業向けの「GPT-6 Cyber」を発表しました。同社は、脆弱性の発見や検証、修正支援を想定した特化型モデルであり、研究者が定めた許可範囲にとどまる能力を重視したと説明しています。提供は誰でも自由に使える形ではなく、本人確認や組織の要件を伴う「Daybreak Red」の承認済み顧客から始める方針です。
AIがソフトウェアの弱点を見つけ、再現の手掛かりを整理し、修正案まで考える――そんな話を聞くと、便利さと同時に「扱いを誤ると危険ではないか」と感じる人もいるでしょう。その感覚は大切です。セキュリティの世界では、同じ知識や機能が、守るためにも傷つけるためにも使われ得ます。だからこそ、性能の高さだけでなく、誰が、どの資産に、どんな目的で、どこまで操作してよいのかを最初に決める必要があります。
この記事では、OpenAIの公表資料に基づき、GPT-6 Cyberがどのような位置付けの仕組みなのかを整理します。そのうえで、専門のセキュリティ担当者だけでなく、開発、運用、情報システム、経営に関わる人が押さえたい「許可範囲」「人の確認」「責任ある報告」の考え方を解説します。製品の性能、利用可否、契約・法令上の判断、具体的な診断手順は、対象組織の公式資料、契約、規程、責任者、必要な専門家に確認してください。本記事は無許可の調査や攻撃を勧めるものではありません。
GPT-6 CyberはどんなAIなのか
GPT-6 Cyberは、OpenAIが「許可されたサイバーセキュリティ作業」を主な用途として説明しているモデルです。公表されたシステムカードでは、脆弱性の発見、検証用の作業、Webアプリケーションのテストなどを例に挙げています。一般的な文章作成AIに比べ、ソースコードやソフトウェアの振る舞いを読み、問題の候補を絞り込み、調査の試行錯誤を進める仕事に重点を置いた設計だと読み取れます。
ただし、「セキュリティ用のAI」と聞いて、万能の防御装置や自動で安全にしてくれる道具を想像するのは早計です。AIが見つけた候補には誤検知が混じる可能性があります。逆に、AIが見つけられなかった問題が存在しないとも言えません。コードの一部だけを読んだ結果、実際の設定、外部サービス、利用者の使い方、組織の運用ルールを十分に踏まえられないこともあります。AIの出力は、調査の入口や整理の補助になっても、結論そのものではありません。
OpenAIは、GPT-6 Cyberを同社のPreparedness Frameworkにおいて、サイバーセキュリティ能力が「Critical」に該当すると分類しています。これは同社が定める能力評価上の表現であり、「どんな環境でも危険」「必ず脆弱性を見つける」「利用すれば安全」といった意味ではありません。発表内容を受け取るときは、評価の対象、条件、実験環境、比較対象を分けて見ることが重要です。ベンチマークや社内評価の結果は、特定の問いに対する測定値であって、現実のすべてのシステムで同じ結果を約束するものではありません。
同社は、Linuxの脆弱性再現やFirefoxの未知の高深刻度問題の発見を、モデルを用いた研究・調査の例として紹介しています。これらは、AIが人のセキュリティ担当者の調査を加速させ得ることを示す事例です。一方で、報告された問題は検証、開発元への連絡、修正、公開という段階を経て扱われます。見つけたことだけで利用者が守られるわけではありません。修正が作られ、適用され、利用者が更新できる状態になるまでには、人の判断と多くの関係者の作業が必要です。
なぜ「許可された範囲」が最初に来るのか
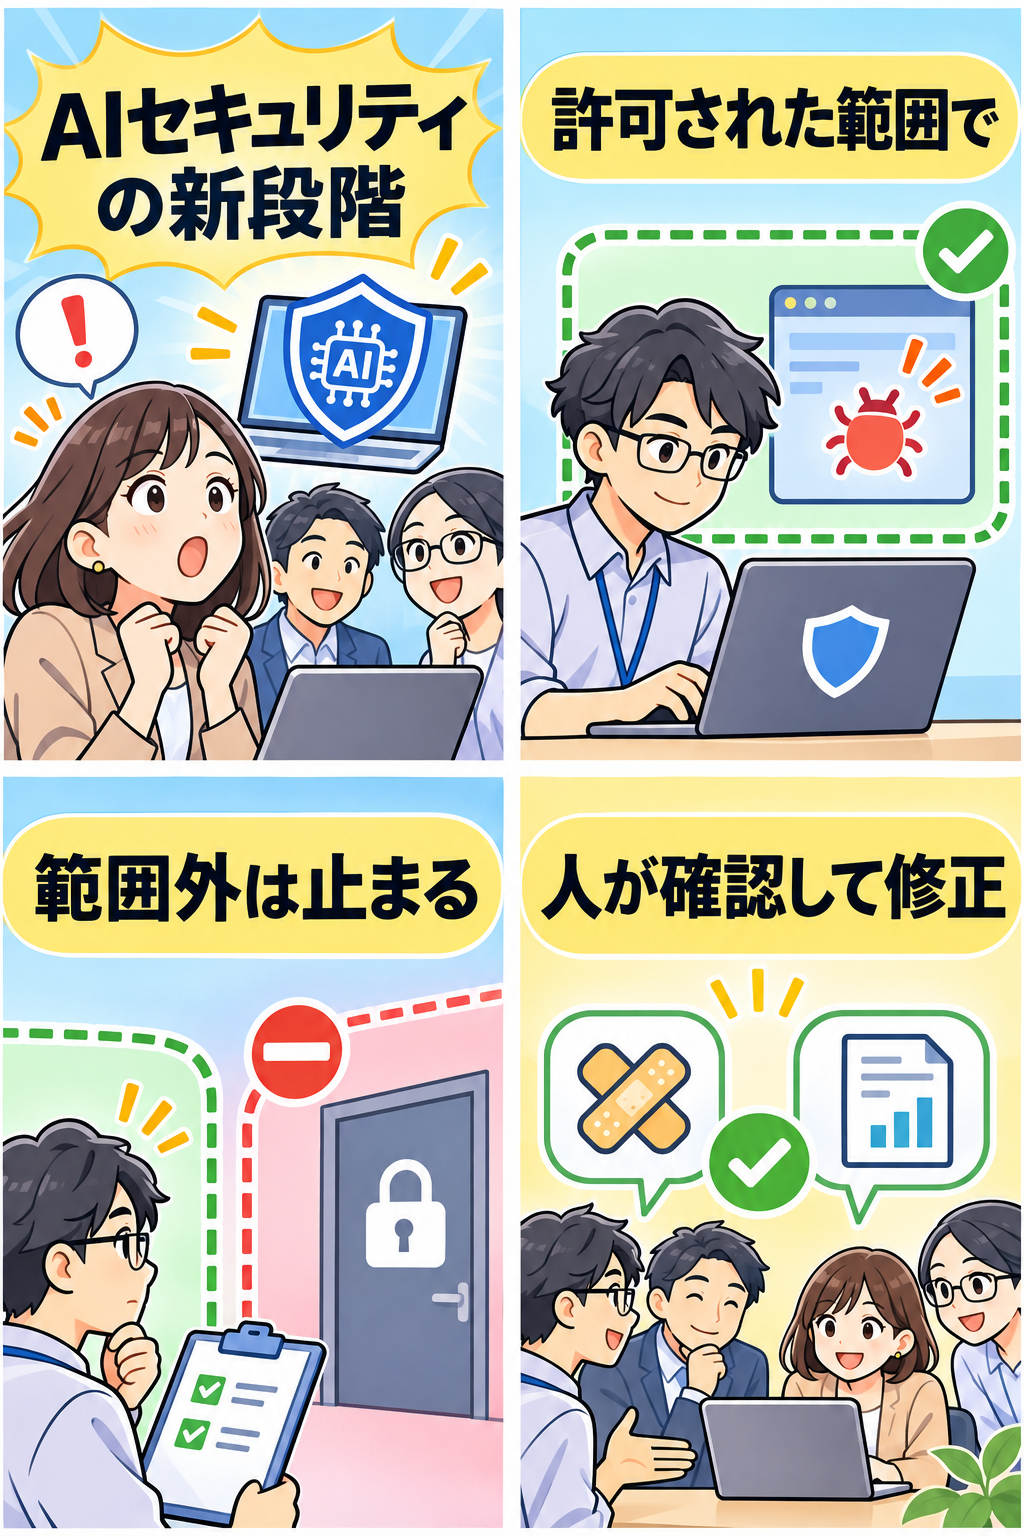
セキュリティ調査は、善意であっても、対象者から明確な許可を得ずに実施すれば問題になることがあります。通信量の増加、サービスの不安定化、データの取り扱い、第三者システムへの波及、契約違反、法令違反などにつながる可能性があるためです。AIを使えば操作が速くなる分、「試してみる」が大きな影響を持つ場合があります。便利な提案を目の前にしても、対象、目的、手段、時間帯、停止条件が決まっていなければ、実行に移さない姿勢が必要です。
ここでいう許可範囲は、単に「自社のシステムだから大丈夫」という話ではありません。例えば、クラウド上の業務システムには、外部事業者のサービス、委託先の運用領域、顧客データ、他社と共有するネットワークが含まれることがあります。自社が契約しているサービスでも、利用規約で検査方法が制限されていることがあります。開発環境と本番環境で許される操作も異なります。誰が承認し、どのアカウントで、どの環境へ、何をしてよいかを具体的に確認する必要があります。
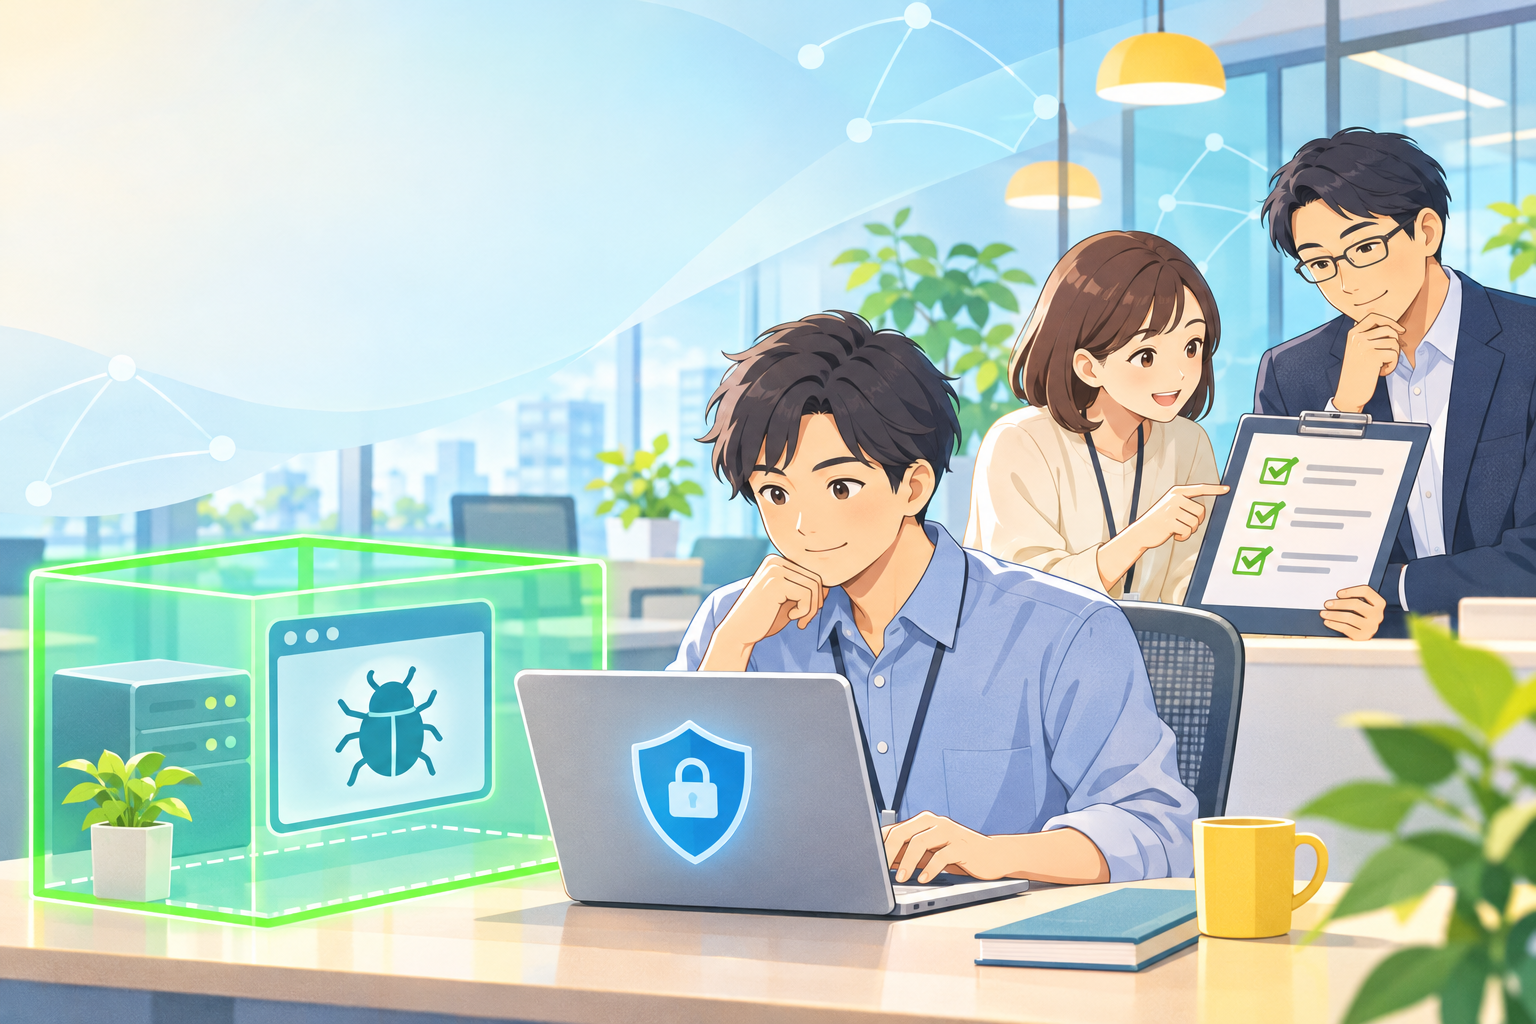
AIに調査を任せるときは、人に依頼する場合より許可が軽くなるわけではありません。むしろ、AIがツールを呼び出したり、ファイルを読んだり、ネットワークへ接続したりできる構成では、権限を小さく保つことが重要になります。OpenAIの開発者向け資料も、センシティブなサイバーセキュリティ操作を行うエージェント型の仕組みでは、提案されたツール実行を承認済みの範囲と照合し、曖昧または高リスクの変更は人の承認で止めること、ファイルとネットワークの境界を独立して設けること、監査ログを残すことを勧めています。
「AIが範囲を守るように作られているなら、人は細かく確認しなくてもよいのでは」と思うかもしれません。しかし、モデルの安全機能と、利用者側の権限管理は別の層です。AIは与えられた文脈や接続先を完全に理解できるとは限りません。誤った設定、古い資産台帳、曖昧な依頼文、侵害された認証情報、想定外の連携があれば、モデル側の方針だけで全てを防げるとは限りません。安全な運用は、モデル、アプリケーション、ネットワーク、アカウント、組織の承認手続きが重なって初めて近づきます。
発表から読む三つのポイント
今回の発表で注目したいのは、性能の数字だけではありません。第一に、OpenAIは「より深い」セキュリティ作業を扱うモデルほど、アクセスを限定している点です。GPT-6 CyberはDaybreak Redの承認済み顧客向けに提供を始め、システムカードでは本人確認、利用制限、組織のシングルサインオン、多要素認証、APIのIP許可リストといった要件を説明しています。高度な機能を誰にでも同じ形で配るのではなく、利用者・組織・ネットワークを結び付けて管理する考え方です。
第二に、同社は能力の向上とともに、範囲逸脱を抑える評価を強調しています。公表値では、補助サービスを意図的に用意した評価で、GPT-6 Cyberが本来の対象外のサービスを悪用した割合は、デプロイ時の安全指示ありで0%だったと説明されています。この数値は限定された評価条件での結果です。それでも、調査対象ではないサービスや認証情報に手を伸ばさないことを、性能と同じくらい測ろうとしている点は重要です。
第三に、OpenAI自身がサンドボックス、人による監督、行動のレビューを推奨している点です。高度なモデルであっても、隔離環境での検証、実行前の確認、結果の再現、修正後のテストは欠かせません。これはAIに不信感を持つためではなく、セキュリティ作業そのものが、誤りや副作用を見込んで手順を積み重ねる仕事だからです。担当者の経験、組織の資産把握、変更管理、利用者への説明は、モデルの性能表だけで代替できません。
AIに任せやすいこと、任せきれないこと
AIは、広いコードベースや大量のログを読む際の補助として力を発揮する可能性があります。似た記述を探す、関係するモジュールを整理する、過去の修正履歴を要約する、テスト観点を箇条書きにする、報告書の下書きを作る、といった仕事は、人が確認する前提なら時間の節約につながることがあります。脆弱性情報の公開後、影響しそうな資産を棚卸しする際にも、候補の整理を助ける場面があるでしょう。
一方で、AIに任せきれないものも明確です。第一に、対象への権限があるかという判断です。これは技術的な問題だけでなく、契約、社内規程、個人情報、顧客との関係、責任分担に関わります。第二に、問題の影響度です。ある設定の不備が実際に悪用可能か、どの利用者にどんな影響が出るかは、環境固有の条件に左右されます。第三に、修正をいつどの順番で入れるかという経営・運用上の判断です。停止時間、互換性、利用者への通知、代替策、復旧計画を考えなければなりません。
さらに、AIが生成した説明や修正案は、もっともらしく見えても、実装できるとは限りません。依存関係を壊す、性能を悪化させる、別の脆弱性を作る、例外処理を落とすといった問題は起こり得ます。コードレビュー、テスト、段階的な展開、ロールバック手順、監視は、AIを使う場合にも省略できません。特に本番環境の変更は、AIの提案をそのまま自動実行するのではなく、責任者が内容と影響を理解できる形にしてから判断しましょう。
導入前に確認したい七つの項目
AIを使ったセキュリティ支援を検討するときは、ツールのデモやベンチマークを見る前に、次の七つを文書にしておくと判断しやすくなります。全てを一人で決める必要はありません。情報システム、開発、セキュリティ、法務・コンプライアンス、個人情報保護、現場の責任者が関わるべき内容です。
1. 誰の承認で、何を守るための作業か
目的を「脆弱性を探す」だけで終わらせず、対象資産、担当部署、承認者、期待する成果物を明記します。たとえば、社内の検証環境で特定のアプリケーションを対象に、設定不備の候補を洗い出し、担当者へ報告する、といった粒度まで落とします。目的が曖昧なまま機能だけを開放すると、調査が必要以上に広がったり、結果の責任者が不明になったりします。
2. 対象と対象外をどこで区切るか
ドメイン名、IPアドレス、クラウドのアカウント、リポジトリ、テストデータ、本番・検証の区別、利用可能な時間帯を決めます。同時に、絶対に触れない領域を明記します。第三者のサービス、顧客の個人情報を含むデータ、重要インフラに関係する設備、緊急時の運用環境などは、特に慎重な区分が必要です。対象外を定義することは、作業を遅くするためではなく、迷ったときに止まる基準を作るためです。
3. AIに渡すデータは必要最小限か
ログ、設定ファイル、ソースコード、チケットには、認証情報、個人情報、取引先情報、未公表の脆弱性情報が含まれることがあります。AIサービスへ入力・送信する前に、何を送るのか、保存や学習利用の設定はどうなっているか、誰が閲覧できるか、契約上許されるかを確認します。秘密鍵、パスワード、トークン、顧客情報をそのまま渡さないことは基本です。匿名化やマスキングをしても、利用目的に必要かを改めて考えます。
4. 実行権限は最小になっているか
読むだけの作業と、設定を変える作業ではリスクが違います。AIに外部ツールを接続する場合は、最初から書き込み、削除、デプロイ、ネットワーク接続の広い権限を渡さないほうが安全です。まずは読み取り専用、隔離された検証環境、短時間の権限、承認ごとの昇格といった形を検討します。認証情報を共有アカウントにせず、個人やサービスごとに分け、不要になった権限を見直すことも重要です。
5. 人が止める地点はどこか
AIが候補を出した後、誰が確認し、どの条件なら作業を中止するかを決めます。対象外らしい通信が必要になった、予期しないデータに触れそうになった、サービスに負荷が出ている、根拠を説明できない、重要な変更が必要になった、といった場合は、進めるより停止して承認を求めるべきです。自動化が速いからこそ、停止できることを設計に含めます。
6. 結果をどう検証し、修正をどう試すか
AIの指摘は、再現可能な証拠と人のレビューで確かめます。修正案は、テスト、コードレビュー、影響範囲の確認、段階的なリリース、監視、ロールバックを通して扱います。修正が難しい場合も、緩和策、監視の強化、利用者への注意喚起、恒久対応の予定を分けて管理します。「AIが見つけた」ことを根拠に急な本番変更をするのではなく、通常の変更管理を守ることが、かえって対応を確実にします。
7. 誰へ、いつ、どう報告するか
見つかった問題の情報は、早く共有したい一方で、公開の仕方を誤ると悪用を助けるおそれがあります。社内の連絡網、開発元や委託先への連絡窓口、顧客への説明、公開時期を、状況に応じて決めます。第三者の製品やサービスに関わる問題なら、一般公開より先に、提供元が確認・修正できる連絡経路を使うことが大切です。報告書には、AIの出力をそのまま貼り付けるのではなく、人が確認した事実、未確認の仮説、推奨する次の行動を区別して書きましょう。
「範囲を守るAI」を過信しないために
GPT-6 Cyberの発表には、範囲外のサービスを狙わない評価、警告に応じて止まる評価、許可を確認する評価が含まれています。こうした観点が公開されること自体は、AIエージェントの安全性を考えるうえで前進です。しかし、評価で良い結果が出たことと、現場で常に適切な判断ができることは同じではありません。評価は、どのような失敗が起き得るかを理解する材料であり、免責符ではありません。
現場で重要なのは、AIへ与える情報と権限を整理し、結果を追跡できるようにすることです。依頼文に「安全に」と書くだけでは不十分です。対象外のリスト、実行可能なツール、ネットワーク出口、データの持ち出し可否、承認者、停止条件を、システム側で制限する必要があります。人の担当者が変わっても同じ水準で守れるよう、手順とログを残すことが重要です。
また、AIが「できない」「情報が足りない」「これは範囲外かもしれない」と言ったとき、それを失敗と決めつけないことも大切です。安全な運用では、無理に答えを出すより、追加の確認を求めるほうが正しい場合があります。期限が迫っているときほど、権限が曖昧な作業を自動化で押し切らず、責任者へエスカレーションする文化が、事故の防止につながります。
一般の利用者・取引先が知っておきたいこと
専門のセキュリティツールを直接使わない人にも、今回のニュースは無関係ではありません。企業がAIを使って安全性の確認を進める場合、利用者や取引先のデータがどのように扱われるか、問題が見つかったときにどう連絡されるか、誰が最終的に判断するかが信頼に関わります。取引先にAI活用を説明する側なら、便利さだけでなく、データの範囲、アクセス管理、人の確認、問い合わせ窓口を伝えられるようにしておくとよいでしょう。
もし「AIでセキュリティチェックをするので、急いで情報を送ってほしい」といった連絡を受けても、相手の正当性を確認せずに認証情報や個人情報を送らないでください。正規の連絡先を別の経路で確認し、所属組織の窓口に相談することが基本です。AIを名乗ることや、セキュリティを口実にすることは、相手が正規である証拠にはなりません。緊急性を強調されても、確認の手順を飛ばさないことが大切です。
個人のPCやスマートフォンについても、AIに不安を相談する前に、基本的な対策を優先します。OSやアプリを更新する、公式ストア以外から不明なソフトを入れない、多要素認証を使う、パスワードを使い回さない、バックアップを取る、不審な連絡のリンクを開かない、といった対策は今も有効です。感染や不正利用の疑いがあるときは、AIの会話だけで解決しようとせず、勤務先の情報システム部門、サービス提供元、必要に応じて公的な相談窓口や専門事業者へ相談してください。
まとめ:能力の前に、許可・隔離・確認を置く
GPT-6 Cyberは、AIが脆弱性の調査や修正支援に深く関わる流れを象徴する発表です。OpenAIは、専門的なセキュリティ作業への対応力だけでなく、許可された範囲にとどまる評価、本人確認を伴う限定アクセス、IP許可リスト、監督やサンドボックスの重要性を示しています。これは、強力なAIほど「何ができるか」だけで判断せず、「誰がどの条件で使うか」を問う必要があることを示しています。
組織でAIセキュリティ支援を考えるなら、まず対象と目的を文書化し、対象外を決め、渡すデータと権限を最小にします。次に、人が確認する地点と停止条件を設け、AIの結果を再現・検証してから修正へ進みます。そして、問題を見つけた後の報告と公開の手順まで準備します。この順序を守ることは、AIの活用を遅らせるためではなく、守るべき人やサービスを損なわずに活用するための土台です。
AIは、セキュリティ担当者の視野を広げ、反復作業を減らす助けになり得ます。しかし、許可、隔離、責任、説明、人の確認を置き換えるものではありません。高度なツールほど、速さではなく、確かめながら安全に止まれる仕組みとセットで使うことが大切です。