2026年11月16日、OpenAIは、外部の専門組織が同社の内部モデルや安全対策を一定期間にわたって評価する「埋め込み型評価(embedded assessments)」の初期段階を公表しました。契約したのはApollo Research、Goodfire、METR、Transluceの4組織です。発表によれば、評価者は必要に応じてモデルの途中段階、学習・評価の記録、監視の仕組み、技術文書、担当する研究者・技術者との議論など、通常は外から見えない材料へアクセスして検証します。
「第三者が見るなら、AIの安全性はもう保証されるのでは」と受け取る人もいるかもしれません。けれど、このニュースの重要な点は、太鼓判が押されたことではありません。何を調べるのか、誰がどの範囲まで見られるのか、評価者の独立性をどう守るのか、結果のうち何が公開されるのかを、具体的な手続きとして示そうとした点にあります。安全性を一回のテストや一つの会社の説明だけで判断しないための、まだ発展途上の試みとして読むのが適切です。
この記事では、OpenAIの発表を手がかりに、埋め込み型評価とは何か、一般的な外部レビューと何が違うのか、独立性を読むときにどのような条件を確かめればよいのかを整理します。発表内容は将来の評価結果、個別のAIの性能・安全性、サービスの利用可否を保証するものではありません。医療、法律、税務、投資、保険、雇用、教育、福祉、行政手続きなど、生活や権利に大きく関わる個別判断は、AIの出力や一般記事だけで確定せず、公式情報、担当窓口、必要な専門職に確認してください。
埋め込み型評価とは、外部の人が「内部の根拠」をたどる仕組み
AIを評価する方法にはいくつかあります。公開された製品を触って、決められた質問への答えや操作の結果を見る方法。開発元が公開した報告書を、外部の研究者が読み解く方法。発売前のモデルを限定的に試す方法です。どれも意味がありますが、外から見える結果だけでは、「その挙動がなぜ起きたのか」「見つかった問題を社内でどう扱ったのか」「テストに出なかった失敗をどのように探しているのか」まで確認しにくいことがあります。
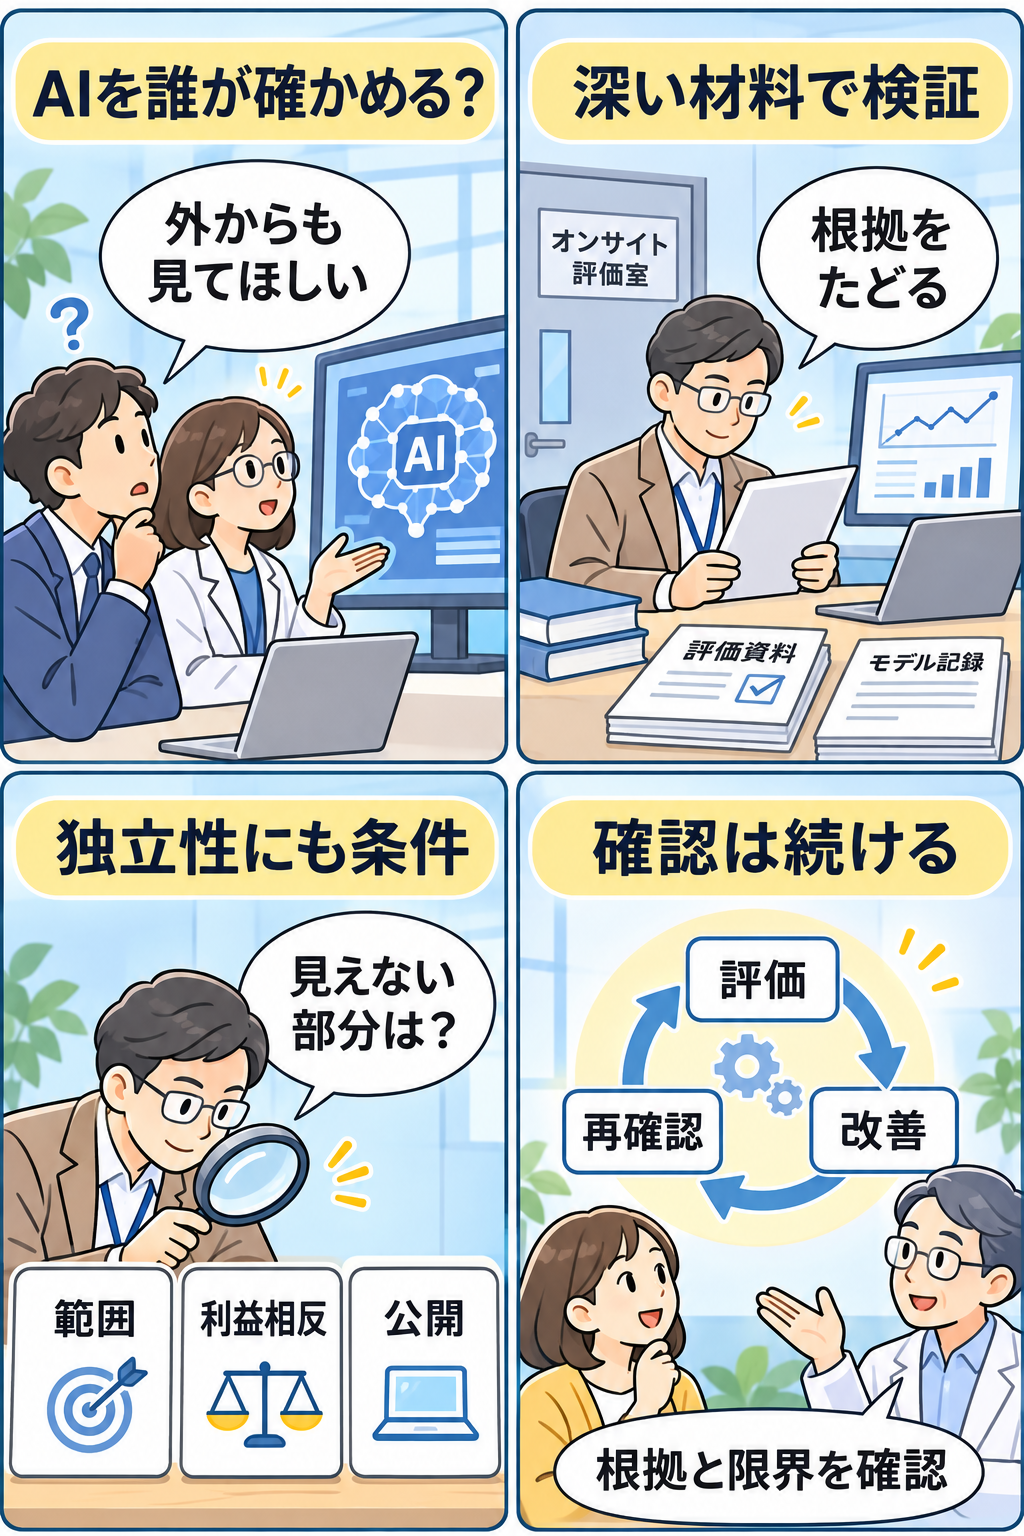
OpenAIが説明する埋め込み型評価は、外部の評価者が研究開発の現場に近い環境で、より深い証拠へアクセスしながら調査する考え方です。発表では、評価の必要性に応じて、モデルのチェックポイント、ソースコード、学習データと評価データ、監視システム、技術文書、研究者や技術者との議論などが例として挙げられています。ここでいう「深い」とは、評価者が何でも自由に持ち出したり、無制限に操作したりできるという意味ではありません。機密性や安全性を守るため、合意した対象、資源、手順の中で確認するという前提です。
この形が目指すのは、開発側が想定した試験をなぞるだけでなく、独立した専門家が「見落とした失敗はないか」を探しやすくすることです。たとえば、ある監視の仕組みが異常を検知できると説明されている場合、評価者はテストの設計、監視が反応した記録、反応しなかった場面、対応の流れを見ながら、主張と証拠の間に抜けがないかを考えます。AIがもっともらしい答えを作るかどうかだけでなく、開発・評価・運用の過程を対象にできる点が特徴です。
ただし、これはニュース時点で始まった「初期段階」の取り組みです。評価が終わった範囲、発見された問題、改善が完了したかどうかは、今回の発表だけからは確定できません。埋め込み型評価という言葉を見かけたら、「外部組織の名前がある」ことだけで安心せず、実際の対象、手法、結果、限界が後からどこまで示されるかを追う必要があります。
OpenAIが示した4組織の役割をどう読むか
発表では、評価の焦点が組織ごとに少しずつ異なります。Apollo Researchは、モデルが開発者の意図に反してひそかに行動する可能性と、そのような行動を安全策で検知できるかを検討する予定です。OpenAIは、学習がそのような行動を促していないか、強い評価やレッドチーミングでその行動が引き出されないか、社内利用中に試みがなかったか、仮にそうした推論があれば検知可能か、といった複数の主張を評価対象として掲げています。
Goodfireについては、モデル内部を分析する研究者を組み込み、学習実行中の監視、デバッグ、アラインメントの確認を主な目的とする説明です。ここでいうアラインメントは、AIの振る舞いを人間が意図する目標や制約に沿わせようとする研究領域を指します。モデル内部を読む技術は研究途上であり、内部に何かの特徴が見つかったからといって、それだけで将来の行動を完全に説明・予測できるわけではありません。だからこそ、分析結果をどの判断へ結びつけ、どの限界を残すのかが大切になります。
METRは、同社にとって最大規模の強化学習の実行における、既存のテストや監視が見逃したかもしれない不整合な振る舞いを評価する予定とされています。関連するチェックポイント、学習・評価の実行記録、監視記録を用い、合意した安全措置のもとで、優先順位や探索方法を独立して決め、追加の実験を進める構想です。また、以前の監視システムのストレステストに続く評価についても、範囲の合意を前提に検討中と説明されています。
Transluceは、学習後のアラインメント評価について、品質とカバー範囲を調べる初期評価を担当します。選ばれた公開・未公開モデル、評価とその結果、振る舞いに関するデータ、安全性の説明資料などへのアクセスが想定されています。さらに2027年初頭には、モデル公開の判断に評価結果がどう反映されるかに関する情報も含め、より広いアクセスを伴う約8週間の評価を行う意向が記されています。
四つの名前が並ぶことは、評価の観点に多様性を持たせようとする姿勢として読めます。しかし、四つあるから四倍確かなのではありません。各評価がどこまで重なり、どこが違うのか、評価者に与えられた情報と時間は十分だったのか、結論の根拠が公開されるのかが分からなければ、外部の人は強さを判断できません。数ではなく、問い・手法・証拠・公開の質を見ることが重要です。
なぜ「第三者」だけでは足りず、独立性の条件が重要なのか
第三者評価と聞くと、企業と無関係な人が完全に自由な立場で調べる姿を想像しがちです。実務では、機密情報、知的財産、個人情報、悪用され得る技術情報を扱うため、評価者が守るべき制限は避けられません。発表でも、特に機微な情報へ直接アクセスするときは、OpenAIの研究者と組んで分析を実行する代替案を検討するとしています。また、機密情報を扱う評価者は原則としてOpenAIの拠点で、同社の端末を使って作業する計画です。
この制約そのものを「評価は無意味だ」とみなす必要はありません。むしろ、機密性と検証可能性が衝突しやすい現実を明示した点は、読むべき情報です。ただし、制約がある以上、読者が「独立」という言葉を広く受け取りすぎないことも重要です。評価者が何を見られず、どのような仮説を試せず、どの結果を外へ出せないかによって、評価の射程は変わります。
利益相反も確認点です。OpenAIは脚注で、Apollo ResearchとGoodfireは評価業務への金銭的補償を受けるが、その額は評価結果に連動しないと説明しています。METRとTransluceは金銭的補償を受けない一方、評価用のAPIクレジットや計算資源を受け取る可能性があるとしています。報酬や計算資源の提供が直ちに不正を意味するわけではありません。専門的な評価には人材・設備・時間が必要です。しかし、だからこそ、資金関係、結果に連動する条件の有無、過去・将来の取引、担当者の移動制限などを開示し、評価の受け手が自分で考えられるようにする必要があります。
発表には、別のAI開発企業へ埋め込まれる前に、評価に参加した組織の職員へ短い「クールオフ期間」を求める考え方もあります。狙いは、競争上の機密情報が意図せず別の場所へ流れる危険を減らすことです。一方で、クールオフ期間が長すぎれば、限られた専門家が評価に参加しにくくなる可能性もあります。独立性は、単純に「距離を遠くする」だけでは作れません。透明性、評価者の裁量、異議を言える経路、結果の扱い、専門人材を持続できる条件を組み合わせて考える必要があります。
評価の範囲・公開・異議申立てを分けて見る
今回の発表は、評価開始時の手続きを比較的詳しく説明しています。まず範囲については、個々の評価で対象、アクセス、資源、安全の取り決めを合意して始めるとされています。特定の安全上の主張を検証する評価もあれば、決めたシステムや学習実行の中で、予期しない失敗を探す裁量を評価者に持たせる評価もあるといいます。ここで確認したいのは、「評価した」という事実ではなく、評価しなかった領域です。学習段階だけを見たのか、外部公開後の利用まで見たのか、実際のユーザーや悪用への影響を含めたのかで、読み取れることは違います。
次に公開です。OpenAIは、評価者が評価を公開する独立性を持つ一方、機密情報の非公開化を求める権利を留保し、安全・セキュリティ上の問題を直す時間を確保するため、責任ある開示の遅延を求める場合があると説明します。これは脆弱性情報をすぐ公開すると悪用が容易になる場面では合理的な対応になり得ます。しかし、非公開化や遅延が広く使われれば、外部の人が都合の悪い結果を把握できなくなるおそれもあります。後に出る報告では、何が編集・延期されたのか、理由は何か、どの程度の要約が残っているかが重要になります。
異議申立ての経路も、評価の実効性を左右します。発表では、OpenAIと評価者の意見が対立した場合、安全助言グループと経営陣へ上げ、解決しなければ財団の理事会にある安全・セキュリティ委員会へ回す手順が示されています。同委員会は非編集の報告を受け、評価者とも非公開で話せるとされています。これは手続きの存在を示す情報ですが、実際に異議がどのように扱われたか、委員会がどの程度独立しているか、最終判断と根拠がどう説明されるかは、運用を見なければ分かりません。
AIの安全性を読み解くときは、「報告書が出た」かどうかよりも、範囲、アクセス、公開、異議申立てを別々に質問すると整理しやすくなります。範囲は何か。評価者は根拠を再現できるか。利益相反は開示されたか。見つかった問題は誰に報告され、修正はいつ確認されるか。公開できない部分は何か。この問いを分けることで、派手な見出しに引きずられず、評価の実態に近づけます。
外部評価は「安全証明」ではなく、改善を始める材料
AIの評価に限らず、監査やレビューには限界があります。対象期間の外で起きる変化、新しい使われ方、未知の攻撃、評価に入っていないデータ、運用する人の判断まで、すべてを一度にカバーすることはできません。高い点数や好意的な報告が出ても、「どんな状況でも安全」という結論には飛べません。反対に、問題が見つかったことも、評価の失敗だけを意味するわけではありません。早く問題を表に出し、影響を抑え、対策が効いたかを再確認できるなら、評価の目的に近づく場合があります。
そのため、よい評価の成果は「問題なし」という一言ではなく、少なくとも三つの形で残ると考えられます。第一に、何をどの方法で調べ、何が分かったかという根拠。第二に、調べられなかった範囲や不確実性。第三に、見つかった課題への対応、再テスト、継続監視です。NISTのAIリスク管理フレームワークも、リスクを一度だけ判定して終えるのでなく、状況に合わせて管理を続ける考え方を示しています。これは特定企業の評価を保証する資料ではありませんが、AIのように環境や使い方が変わる技術を読む際の参考になります。
利用者や導入企業の立場でも、同じ考え方は役立ちます。AIツールの選定では、宣伝上の「安全」「信頼」といった言葉だけでなく、第三者のテストの有無、対象範囲、データの扱い、障害時の連絡先、変更履歴、問題を報告する手段を確認します。社内でAIを使う場合は、いきなり重要な業務へつなげず、公開情報や匿名化したデータを使った小規模な検証から始め、担当者の承認、記録、停止手順を整える方が安全です。
個人情報、顧客情報、未公表の企画、健康情報、口座情報、契約書などをAIへ入力する前には、組織の規程、契約、サービスの設定、保存・学習利用の条件、閲覧権限を確認してください。AIに複数のレビュー役を置いたとしても、同じ資料や同じ偏りを共有すれば、似た誤りが重なることがあります。複数のAIの一致は、独立した証拠の代わりにはなりません。人による確認と、必要に応じた外部の物差しを残すことが大切です。
一般の読者がニュースで確認したい5つのポイント
1. 評価対象は何か
モデルそのもの、学習の手順、監視システム、公開前の製品、公開後の運用では、見えるリスクが異なります。「AIを評価した」という大きな表現だけでは対象が分かりません。対象外の領域も含めて確認します。
2. 評価者はどんな根拠へ触れたか
公開画面だけのテストなのか、内部の記録、評価データ、技術文書、担当者への質問まで含むのかで、検証できる深さが変わります。一方で、アクセスにどの制約があったかも同時に見ます。
3. 独立性を支える条件は開示されたか
報酬、計算資源、過去の関係、評価範囲を決める権限、反対意見を出す経路、情報の持ち出し制限を見ます。第三者というラベルより、条件の透明性が判断材料になります。
4. 報告の限界は書かれているか
評価がカバーした期間、試せなかった仮説、非公開にした情報、サンプル数、再現できない部分が記されているかを探します。限界の記載は弱さの告白ではなく、結論を正しく受け取るための情報です。
5. 指摘後の改善と再確認が追えるか
見つかった問題に対して、誰が何を修正し、いつ再評価するのか。報告の公開後に変更履歴や続報があるのか。評価を単発の広報イベントにしないためには、この追跡が欠かせません。
組織でAI評価の仕組みを取り入れるなら
大規模なAI研究所の埋め込み型評価を、そのまま一般企業や学校、非営利団体へ持ち込む必要はありません。それでも、考え方の一部は規模を問わず使えます。たとえば社内のAI活用では、導入担当とは別の部署や、利用する現場の担当者に小さなレビューを頼むだけでも、見落としを減らす助けになります。開発した人だけが「問題なし」と判断する形より、実際に困る人、情報管理を担当する人、運用を引き継ぐ人の目を加える方が、前提の違いを早く見つけやすいためです。
始めるときは、評価役へ「このツールを褒めるか」ではなく、「どんなときに誤るか」「どの情報を入れてはいけないか」「誰が最終判断を持つか」を尋ねるとよいでしょう。たとえば、問い合わせ文の下書きを作るAIなら、誤った事実、差別的な表現、顧客情報の混入、存在しない規約の引用、送信前の承認漏れをチェック項目にします。テストに使う文章は、実在の顧客データではなく、許可を得た例文や匿名化済みのサンプルにします。小さな範囲で失敗を集め、使い方や停止条件を直してから広げる方が、問題の影響を抑えられます。
また、評価者が利用部署と違う意見を出したときに、黙らせずに残す仕組みも必要です。指摘を「今は直せない」「追加確認が必要」「採用しない」と分類し、理由と担当者、見直す時期を記録します。結論が一つに決まらない場合でも、なぜ保留したのかが残っていれば、後から状況が変わったときに再判断できます。これは高度なAIだけの話ではなく、業務システムや新しいサービスを導入するときにも役立つ基本的な運用です。
AIの出力を利用する現場では、速さと正確さが同じ方向を向かない場面があります。急いで回答することが利用者の助けになる一方、誤りの影響が大きい案件では、人が確認する時間を省くべきではありません。用途ごとに、AIが提案してよい範囲、人へ渡す条件、自動で実行してはいけない操作を決めます。特に採用、評価、融資、保険、医療・福祉の案内、契約、行政手続きに関係する情報では、AIの下書きやスコアを単独の決定理由にせず、説明可能な基準と人の責任を残してください。
外部の第三者評価を依頼する場合も、契約前に確認したいことがあります。評価対象のデータとシステム、閲覧・操作できる権限、秘密保持、報酬、成果物の所有、重大な問題を見つけた場合の連絡先、公開できる範囲、修正後の再確認です。最初から完璧な設計にするのは難しくても、これらを文書にしておくと、評価する側とされる側の期待がずれにくくなります。評価は導入を止めるためだけの仕組みではなく、どこを直せば安全に次の段階へ進めるかを知るための対話でもあります。
まとめ:見るべきなのは「第三者」の看板ではなく、確かめる過程
OpenAIが公表した埋め込み型評価は、AIの安全性を確認する外部の目を、より深い内部の根拠へ近づけようとする初期段階の取り組みです。評価者にどんなアクセスを与えるか、機密性と独立性をどう両立するか、利益相反をどう開示するか、意見が対立したときにどこへ上げるか、公開をどう扱うかまで示したことに、ニュースとしての意味があります。
ただし、この仕組みは安全の保証印ではありません。評価の範囲や制約、実際の運用、公開される結果、改善の継続を見て初めて、外部の人も手応えを判断できます。AIに関する発表へ接するときは、「第三者が関わったか」だけで終わらせず、根拠、限界、利益相反、異議申立て、再確認の五つを確かめてみてください。その習慣が、AIを過度に恐れず、過度に信じもしないための出発点になります。